Thực hành shadow mode: chạy agent song song với nhân viên vận hành và đo độ đồng thuận bằng kappa
Agent khớp 90% với nhân viên vẫn có thể chưa học được gì. Vài chục dòng Python đủ để bạn biết agent của mình thuộc trường hợp nào.

Tóm tắt nhanh
- Ở shadow mode, agent nhận bản sao của request thật, còn người dùng chỉ thấy kết quả của quy trình hiện tại.
- Khi một loại quyết định chiếm đa số, tỷ lệ đồng thuận thô dễ đánh lừa. Kappa trừ đi phần trùng do may rủi.
- Kỳ shadow kết thúc bằng một báo cáo promote, hold hoặc rollback. Con người ký duyệt, hệ thống không tự quyết.
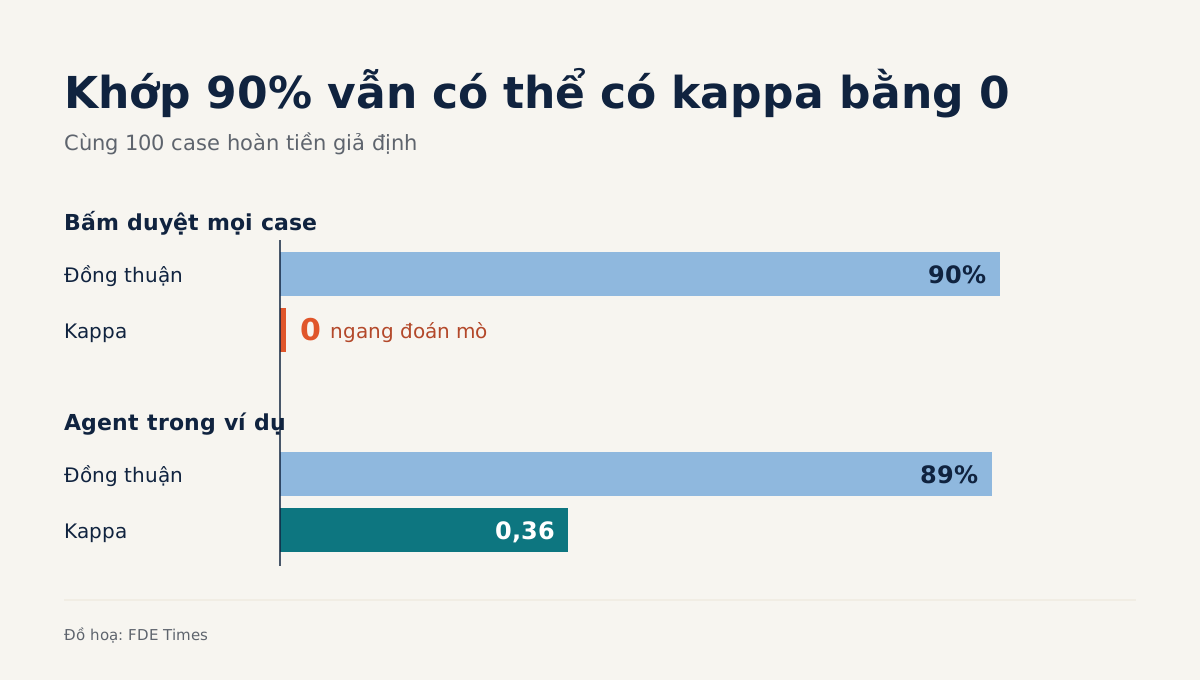
Giả sử agent duyệt hoàn tiền của bạn khớp với nhân viên vận hành ở 90 trên 100 case. Con số đó mang đi báo cáo thì nghe rất ổn. Nhưng nếu nhân viên duyệt đúng 90 case, còn agent gặp case nào cũng bấm “duyệt”, thì nó vẫn đạt 90% mà chẳng học được gì.
Vì vậy, trước khi agent được chạm vào quyết định thật, bạn cần một giai đoạn quan sát nó, với một thước đo không bị con số đẹp đánh lừa. Hướng dẫn này đi qua từng bước: dựng shadow mode cho một quyết định vận hành, ghi lại cả hai phía, tính tỷ lệ đồng thuận và Cohen’s kappa, rồi viết báo cáo cuối kỳ.
Bạn chỉ cần Python 3 và module sqlite3 có sẵn. Mọi đoạn code dưới đây đã được giản lược cho dễ học. Ở khách hàng, phần lưu trữ sẽ là database hoặc hàng đợi mà hệ thống của họ đang dùng.
Shadow mode thực chất là gì?
Christopher Samiullah mô tả shadow mode là kỹ thuật cho traffic và dữ liệu production đi qua một phiên bản mới của service hoặc model. Phiên bản mới chạy thật, nhưng kết quả không đến tay người dùng. Shadow test của AWS SageMaker cũng theo nguyên tắc đó: model shadow nhận bản sao của request thật, còn ứng dụng gọi đến chỉ nhận response của model production.
Với agent cũng vậy. Nhân viên vận hành vẫn làm việc như mọi ngày, agent đưa ra quyết định riêng ở phía sau, và mọi thứ được ghi lại.
Theo AWS, mục đích là bắt lỗi cấu hình và lỗi hiệu năng trước khi chúng ảnh hưởng đến người dùng cuối. Sau shadow test là một bước promote có kiểm soát, chứ không phải bật công tắc một lần là xong.
Shadow mode không miễn phí. Samiullah lưu ý nó tạo thêm tải cho hệ thống, và vào giờ cao điểm, nhu cầu tài nguyên có thể lên tới gấp đôi. Bạn nên nói trước điều này với khách hàng, đừng để họ tự phát hiện qua hóa đơn.
Bước 1: chốt một quyết định và một bộ nhãn
Chỉ chọn một quyết định có đầu ra rời rạc. Ví dụ ở đây là yêu cầu hoàn tiền với hai nhãn approve và reject. Nếu thực tế nhân viên còn có lựa chọn “chuyển cấp trên”, hãy thêm nó làm nhãn thứ ba. Đừng ép một quyết định có ba lựa chọn vào hai nhãn.
Kiểm tra: ngồi với một nhân viên vận hành, cho họ xem 10 case cũ và hỏi bộ nhãn đã đủ để diễn đạt mọi quyết định của họ chưa. Nếu họ phải giải thích kiểu “duyệt nhưng…” thì bộ nhãn còn thiếu.
Bước 2: một bảng chung cho cả hai phía
Kiến trúc tham chiếu của AWS ghi request và response của cả hai endpoint vào DynamoDB để so sánh về sau. Bạn làm đúng như vậy, chỉ khác là một bên là agent, bên kia là con người.
import sqlite3
from datetime import datetime, timezone

db = sqlite3.connect("shadow.db")
db.execute("""
CREATE TABLE IF NOT EXISTS decisions (
  case_id TEXT PRIMARY KEY,
  agent_decision TEXT,
  agent_reason TEXT,
  agent_at TEXT,
  operator_decision TEXT,
  operator_at TEXT
)""")
db.commit()

def now():
    return datetime.now(timezone.utc).isoformat()
Kiểm tra: chạy sqlite3 shadow.db ".schema" và thấy bảng decisions. Hãy giữ cột agent_reason, vì đến lúc đọc các case bất đồng, đó là cột bạn mở ra đầu tiên.
Bước 3: bọc agent sao cho nó không thể làm hỏng luồng thật
Đây là bước dễ sai nhất. Agent có thể chậm, lỗi hoặc trả về rác, nhưng nhân viên vận hành không được nhận ra bất kỳ sự cố nào.
def shadow_agent(case, run_agent):
    try:
        decision, reason = run_agent(case)
    except Exception as e:
        decision, reason = "ERROR", repr(e)
    db.execute("""
      INSERT INTO decisions (case_id, agent_decision, agent_reason, agent_at)
      VALUES (?, ?, ?, ?)
      ON CONFLICT(case_id) DO UPDATE SET
        agent_decision=excluded.agent_decision,
        agent_reason=excluded.agent_reason,
        agent_at=excluded.agent_at""",
      (case["id"], decision, reason, now()))
    db.commit()
    # Không return gì: kết quả của agent không đi về giao diện vận hành.
Code dùng upsert chứ không dùng INSERT OR REPLACE. Nhân viên có thể chốt quyết định trước khi agent chạy xong, và REPLACE sẽ xóa mất cột của họ. Ở môi trường thật, hàm này nên chạy bất đồng bộ qua hàng đợi, để agent có chậm cũng không kéo chậm giao diện vận hành.
Kiểm tra: cố tình cho run_agent ném exception, rồi xác nhận hai điều: màn hình của nhân viên không thay đổi, và bảng có một dòng ERROR.
Bước 4: ghi quyết định của nhân viên ngay tại chỗ họ bấm nút
def record_operator(case_id, decision):
    db.execute("""
      INSERT INTO decisions (case_id, operator_decision, operator_at)
      VALUES (?, ?, ?)
      ON CONFLICT(case_id) DO UPDATE SET
        operator_decision=excluded.operator_decision,
        operator_at=excluded.operator_at""",
      (case_id, decision, now()))
    db.commit()
Hãy gọi hàm này từ chính sự kiện “đã chốt” trong hệ thống của khách hàng, đừng lấy từ bảng tổng hợp xuất ra cuối ngày. Nhân viên không bao giờ được thấy quyết định của agent trước khi chốt. Nếu họ thấy, bạn đang đo mức độ họ bị agent ảnh hưởng, chứ không còn đo độ đồng thuận.
Bước 5: vì sao 89% có thể chỉ là “tạm được”?
Tỷ lệ đồng thuận thô rất dễ tính: số case hai bên chọn giống nhau chia cho tổng số case. Cohen’s kappa thường được xem là thước đo chắc chắn hơn vì nó loại bỏ phần trùng khớp có thể xảy ra do may rủi. Điều này quan trọng nhất khi một nhãn chiếm đa số, như approve trong ví dụ.
Công thức là κ = (p_o − p_e) / (1 − p_e). Trong đó p_o là tỷ lệ đồng thuận quan sát được, còn p_e là tỷ lệ hai bên trùng nhau nếu mỗi bên chỉ chọn ngẫu nhiên theo tần suất quen thuộc của mình.
Thử tính với 100 case giả định. Hai bên cùng duyệt 85 case và cùng từ chối 4 case. Có 5 case nhân viên duyệt nhưng agent từ chối, và 6 case ngược lại. Như vậy p_o = 0,89. Nhân viên duyệt 90 case, agent duyệt 91 case, nên p_e = 0,90 × 0,91 + 0,10 × 0,09 = 0,828. Kappa = 0,062 / 0,172 ≈ 0,36.
Còn agent lười bấm “duyệt” hết ở đầu bài thì có p_o = 0,90 và p_e = 0,90. Kappa của nó bằng đúng 0: khớp 90% nhưng không hơn gì đoán mò theo số đông.
Để đọc con số kappa, nhiều người dùng các mốc Landis và Koch: từ 0 đến 0,20 là “slight”, 0,21 đến 0,40 là “fair”, 0,41 đến 0,60 là “moderate”, 0,61 đến 0,80 là “substantial”.
Theo thang này, 0,36 của ví dụ mới ở mức “fair”. Các mốc này không được chấp nhận rộng rãi như một chuẩn chung, nên hãy dùng chúng để định hướng, đừng coi là luật.
rows = db.execute("""
  SELECT agent_decision, operator_decision FROM decisions
  WHERE agent_decision IS NOT NULL AND agent_decision != 'ERROR'
    AND operator_decision IS NOT NULL""").fetchall()
n = len(rows)
labels = {a for a, _ in rows} | {o for _, o in rows}
p_o = sum(a == o for a, o in rows) / n
p_e = sum((sum(a == l for a, _ in rows) / n) *
          (sum(o == l for _, o in rows) / n) for l in labels)
kappa = (p_o - p_e) / (1 - p_e) if p_e < 1 else float("nan")
print(f"n={n} agreement={p_o:.2f} kappa={kappa:.2f}")
Kiểm tra: nạp đúng 100 dòng như ví dụ trên và xác nhận script in ra agreement=0.89 kappa=0.36. Sau đó đếm riêng số dòng ERROR. Lỗi kỹ thuật là một chỉ số khác, đừng để nó lặng lẽ biến mất khỏi mẫu số.
Bước 6: báo cáo cuối kỳ và người ký
Skill shadow-mode-runner của Foundry định nghĩa shadow mode cho agent là việc đo agreement_rate giữa người và agent. Skill này kết thúc kỳ shadow bằng một trong ba khuyến nghị: promote_to_assisted, hold_in_shadow hoặc rollback. Nó cũng ghi rõ skill không tự quyết việc promote mà chỉ tạo báo cáo, còn con người ký duyệt.
Bạn nên làm đúng như vậy. Báo cáo cần có n, agreement, kappa, tỷ lệ lỗi, ma trận bất đồng và khoảng 10 case bất đồng tiêu biểu kèm agent_reason. Người ký là người chịu trách nhiệm cho quy trình đó ở phía khách hàng, không phải bạn.
Những lỗi hay gặp
Lỗi đầu tiên là chỉ báo cáo con số agreement. Ví dụ trên cho thấy 89% có thể chỉ ứng với kappa 0,36. Lỗi thứ hai là để nhân viên nhìn thấy gợi ý của agent ngay trong kỳ shadow, khiến hai quyết định không còn độc lập.
Lỗi thứ ba là gộp hai loại bất đồng làm một. Agent từ chối case mà nhân viên duyệt khác hẳn về rủi ro so với agent duyệt case mà nhân viên từ chối.
Lỗi thứ tư là quên chi phí: bản thân shadow mode, dù chạy cho service hay model nào, đã tạo thêm tải cho hệ thống, và vào giờ cao điểm nhu cầu tài nguyên có thể lên tới gấp đôi.
Kỹ năng này xuất hiện ở khách hàng như thế nào?
Trong một deployment thật, câu hỏi khó nhất thường không phải “agent có chạy được không”, mà là “lấy gì để chúng tôi tin nó”. Shadow mode trả lời bằng dữ liệu của chính khách hàng, trên chính nhân viên của họ, trước khi agent được can thiệp vào bất cứ việc gì.
Về nghề nghiệp, khi đọc JD FDE, hãy để ý các cụm như “evaluation”, “rollout” hay “human-in-the-loop”, vì kỹ năng này nằm phía sau chúng. Trong CV, một dòng như “dựng shadow mode cho quyết định X, báo cáo agreement và kappa trên N case, khách hàng ký promote sang chế độ assisted” có sức nặng hơn nhiều so với “xây dựng AI agent”.
Một tỷ lệ khớp đứng một mình rất dễ bị người phản biện khó tính bẻ gãy. Kappa đặt cạnh ma trận bất đồng thì khó bẻ hơn nhiều, và đó là cặp số nên có trên slide của bạn.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!