Dựng pipeline tăng dần trên Snowflake bằng hai cách: Dynamic Tables, hoặc Streams và Tasks
Một câu SELECT hay bốn object cùng một lệnh MERGE: tự dựng cả hai trên một tài khoản Snowflake thử nghiệm, rồi bạn sẽ biết nên chọn cách nào trước khi khách hàng hỏi.

Tóm tắt nhanh
- Dynamic table lưu sẵn kết quả một câu SELECT thành bảng và tự giữ nó cập nhật. Ở chế độ INCREMENTAL, mỗi lần refresh chỉ xử lý những dòng đã đổi.
- Streams và Tasks cho bạn toàn quyền kiểm soát, đổi lại bạn phải tự lo offset, lịch chạy, MERGE và chuyện stream bị stale.
- Snowflake khuyên dùng dynamic table cho pipeline SQL mới. Chỉ chuyển sang streams và tasks khi cần MERGE, stored procedure hay gọi hàm ngoài.
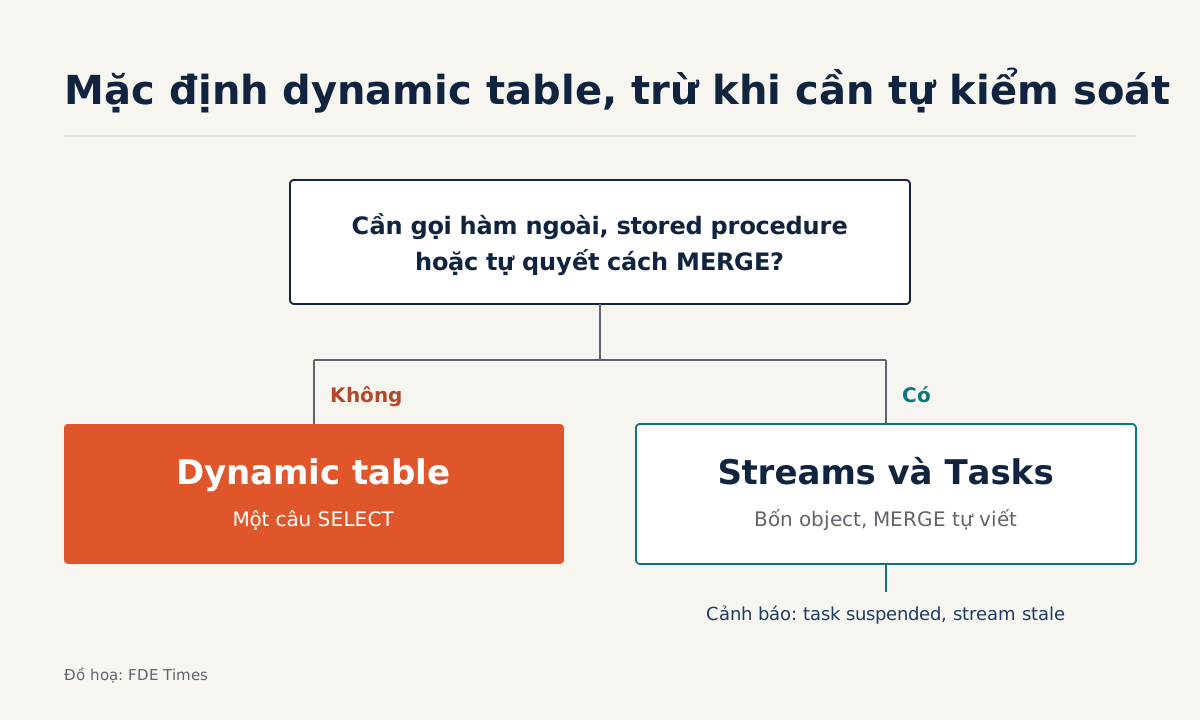
Decision guide của Snowflake viết rằng cách dùng dynamic table gói bốn object và toàn bộ logic MERGE vào một định nghĩa SELECT duy nhất. Nghe như lời quảng cáo. Muốn kiểm chứng, cách tốt nhất là tự dựng cùng một pipeline theo cả hai cách, rồi so xem mỗi cách bắt bạn phải lo những gì.
Với FDE, đây là tình huống quen thuộc. Khách hàng có một bảng đơn hàng lớn thêm mỗi giờ và một dashboard doanh thu bị tính lại toàn bộ mỗi đêm. Họ muốn số liệu mới hơn nhưng không muốn hóa đơn compute tăng. Đọc hết bài, bạn sẽ có hai bản của cùng pipeline đó và biết nên đề xuất bản nào.
Bạn cần chuẩn bị: một tài khoản Snowflake có quyền tạo bảng, stream, task và dynamic table; một warehouse nhỏ (bài này đặt tên transform_wh); và một bảng nguồn raw_orders gồm các cột store_id, order_ts, amount. Tình huống trong bài là giả định, code đã được rút gọn cho dễ theo dõi.
Vì sao “tăng dần” quyết định chi phí?
Năm 2022, lúc giới thiệu Dynamic Tables, Snowflake đã coi xử lý tăng dần là thách thức lớn nhất. Lý do: với refresh tăng dần, chi phí tăng theo tốc độ thay đổi của dữ liệu đầu vào chứ không theo kích thước bảng.
Thử lấy một ví dụ giả định. Bảng có 10 triệu dòng, mỗi giờ thêm 20.000 dòng. Tính lại toàn bộ thì mỗi lần chạy phải đọc 10 triệu dòng. Tính tăng dần thì mỗi lần chỉ xử lý khoảng 20.000 dòng mới. Bạn nên hỏi khách con số này ngay trong buổi làm việc đầu tiên.
Bước 1: một câu SELECT, một dynamic table
Theo tài liệu Snowflake, dynamic table lưu sẵn kết quả của một câu SELECT thành bảng và tự giữ kết quả đó luôn cập nhật. TARGET_LAG là khoảng thời gian tối đa mà nội dung bảng được phép chậm hơn bảng gốc. WAREHOUSE là warehouse sẽ chạy các lần refresh.
CREATE OR REPLACE DYNAMIC TABLE daily_revenue
  TARGET_LAG = '5 minutes'
  WAREHOUSE = transform_wh
  REFRESH_MODE = INCREMENTAL
AS
SELECT store_id,
       DATE(order_ts) AS order_date,
       SUM(amount)    AS revenue,
       COUNT(*)       AS orders
FROM raw_orders
GROUP BY store_id, DATE(order_ts);
Có ba chế độ refresh. INCREMENTAL chỉ xử lý những dòng đã thay đổi kể từ lần refresh trước. FULL tính lại toàn bộ. Ở chế độ AUTO, hệ thống mặc định cố dùng refresh tăng dần. Ví dụ trên ghi rõ INCREMENTAL để bạn thấy ngay mình đang chọn gì. Nếu muốn để hệ thống tự quyết, hãy đổi sang AUTO.
Cách kiểm tra: insert vài dòng vào raw_orders, đợi hết khoảng TARGET_LAG, rồi SELECT từ daily_revenue. Doanh thu của cửa hàng tương ứng phải tăng lên mà bạn không cần chạy thêm lệnh nào.
TARGET_LAG còn nhận một giá trị khác là DOWNSTREAM, hữu ích khi về sau có thêm dynamic table khác đọc từ daily_revenue. Trước khi dùng giá trị này cho chuỗi bảng của khách, hãy đọc kỹ cách nó hoạt động trong tài liệu CREATE DYNAMIC TABLE.
Bước 2: dựng lại bằng tay với stream
Giờ hãy dựng lại đúng logic đó mà không dùng dynamic table. Stream ghi lại các thay đổi DML trên bảng nguồn, tính từ một offset.
CREATE OR REPLACE STREAM raw_orders_stream ON TABLE raw_orders;

CREATE OR REPLACE TABLE daily_revenue_manual (
  store_id INT, order_date DATE, revenue NUMBER, orders INT
);
Cách kiểm tra, cũng là cái bẫy đầu tiên: insert ba dòng vào raw_orders, rồi chạy SELECT * FROM raw_orders_stream hai lần liên tiếp. Cả hai lần đều ra đúng ba dòng đó, vì chỉ truy vấn stream thì offset không dịch chuyển. Offset chỉ tiến lên khi stream được dùng trong một giao dịch DML, chẳng hạn một lệnh MERGE hay INSERT.
Người mới hay tưởng mình đã “đọc xong” stream chỉ vì đã SELECT. Thực ra dữ liệu vẫn nằm đó, chờ một lệnh DML tiêu thụ.
Bước 3: task và MERGE
Task có thể chạy theo lịch hoặc được kích hoạt bởi sự kiện, ví dụ khi stream có dữ liệu mới. Ở đây ta kết hợp cả hai: task được lên lịch mỗi 5 phút, nhưng chỉ chạy thật khi SYSTEM$STREAM_HAS_DATA trả về true.
CREATE OR REPLACE TASK merge_daily_revenue
  WAREHOUSE = transform_wh
  SCHEDULE = '5 MINUTE'
  WHEN SYSTEM$STREAM_HAS_DATA('raw_orders_stream')
AS
MERGE INTO daily_revenue_manual t
USING (
  SELECT store_id, DATE(order_ts) AS order_date,
         SUM(amount) AS revenue, COUNT(*) AS orders
  FROM raw_orders_stream
  GROUP BY store_id, DATE(order_ts)
) s
ON t.store_id = s.store_id AND t.order_date = s.order_date
WHEN MATCHED THEN UPDATE SET
  revenue = t.revenue + s.revenue,
  orders  = t.orders + s.orders
WHEN NOT MATCHED THEN INSERT (store_id, order_date, revenue, orders)
  VALUES (s.store_id, s.order_date, s.revenue, s.orders);
Lệnh MERGE này đã được rút gọn và giả định raw_orders chỉ có insert. Nếu khách có update hoặc delete, bạn phải tự viết thêm logic cho từng loại thay đổi. Đây đúng là phần việc dynamic table làm thay bạn.
Cái bẫy thứ hai: task mới tạo luôn ở trạng thái suspended. Phải chạy lệnh dưới đây thì task mới bắt đầu chạy theo lịch.
ALTER TASK merge_daily_revenue RESUME;Cách kiểm tra: insert thêm dữ liệu, đợi một chu kỳ, rồi so daily_revenue_manual với daily_revenue ở Bước 1. Hai bảng phải ra cùng con số. Sau đó SELECT lại từ stream: lần này kết quả phải rỗng, vì MERGE đã đẩy offset lên.
Cái bẫy thứ ba chỉ lộ ra khi đã lên production
Stream bị stale khi offset của nó rơi ra ngoài khoảng data retention của bảng nguồn. Thử hình dung task bị suspend suốt một kỳ nghỉ dài mà không ai để ý. Đến lúc quay lại, offset có thể đã vượt khỏi khoảng retention và stream đã stale.
Vì vậy, nếu chọn streams và tasks cho khách, hãy đưa trạng thái task và tình trạng stale của stream vào bộ cảnh báo ngay từ đầu. Đừng đợi đến khi dashboard của khách đứng hình mới làm việc này.
Nên đề xuất cách nào cho khách hàng?
Decision guide của Snowflake nói khá rõ. Với pipeline SQL mới có nhiều bảng, hãy ưu tiên dynamic table. Chọn streams và tasks khi pipeline cần stored procedure, MERGE hay gọi hàm ngoài.
Bài blog năm 2022 giới thiệu Dynamic Tables của Snowflake còn nêu thêm một tiêu chí: chọn streams và tasks khi bạn cần toàn quyền kiểm soát việc xử lý tăng dần. Một bài phân tích trên Data Engineer Academy tóm gọn sự đánh đổi này: bạn bớt quyền kiểm soát ở tầng thấp, đổi lại phải dựng ít “đường ống” hơn hẳn.
| Câu hỏi khi làm discovery | Nếu khách trả lời “có” |
|---|---|
| Logic chỉ gồm SELECT, JOIN, GROUP BY? | Dynamic table |
| Cần gọi API hay hàm ngoài trong từng bước? | Streams và Tasks |
| Đội vận hành ít người, không muốn giữ nhiều object? | Dynamic table |
| Cần tự quyết chính xác thời điểm và cách MERGE? | Streams và Tasks |
Buổi trao đổi đầu tiên với khách nên mở bằng hai câu hỏi: dữ liệu thay đổi nhanh đến đâu, và họ chấp nhận số liệu trễ bao lâu. Câu trả lời thứ hai gần như chính là giá trị TARGET_LAG bạn sẽ đặt.
Biến bài tập thành bằng chứng trong CV
Đừng dừng ở việc ghi rằng bạn “biết Snowflake”. Hãy cho thấy bạn từng cân nhắc giữa các phương án: đưa cả hai bản lên repo, kèm một README ngắn về ba cái bẫy và lý do bạn chọn từng cách.
Trong CV, một dòng như “chuyển pipeline từ tính lại toàn bộ sang tăng dần, kèm tiêu chí chọn giữa dynamic table và stream–task” nói được nhiều hơn một danh sách công cụ.
Khi đọc job description, hãy để ý những cụm như “incremental”, “CDC” hay “data freshness”. Đó là dấu hiệu công việc sẽ đặt bạn vào đúng lựa chọn vừa thực hành.
Lần tới khách xin “dashboard real-time”, bạn đã có một câu trả lời trung thực hơn: real-time thường chỉ là một con số TARGET_LAG mà hai bên thống nhất với nhau.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Dynamic tables (Snowflake Documentation)
- CREATE DYNAMIC TABLE (Snowflake Documentation)
- Introduction to Streams (Snowflake Documentation)
- Introduction to tasks (Snowflake Documentation)
- Decision guide for dynamic tables (Snowflake Documentation)
- Dynamic Tables: Delivering Declarative Streaming Data Pipelines · 2022-11-08
- Snowflake Dynamic Tables Explained for Data Engineers · 2026-06-07