SnowConvert đã chuyển xong SQL Oracle, Teradata sang Snowflake: FDE còn phải tự soát những gì
Những lỗi đắt nhất của một dự án migration không làm script báo lỗi: script vẫn chạy, chỉ có con số ra sai.

Tóm tắt nhanh
- SnowConvert AI đánh dấu những gì nó không tự xử lý được bằng EWI và FDM, nhưng có những khác biệt ngữ nghĩa không gây lỗi mà vẫn làm số liệu đổi.
- Oracle coi chuỗi rỗng là NULL, còn Teradata dễ dãi hơn Snowflake khi ép chuỗi sang số và khi so chuỗi trong GROUP BY.
- Đếm số dòng khớp nhau chưa đủ để kết luận gì: phải so từng cột, và với bảng quan trọng thì so đến từng dòng bằng khóa chính cộng mã băm MD5.
Bạn chạy SnowConvert AI trên toàn bộ kho SQL của khách hàng. Script deploy lên Snowflake không báo lỗi nào, dashboard đầu tiên đã lên số, và khách hàng hỏi bao giờ tắt được hệ thống cũ. Đây lại là lúc dự án dễ hỏng nhất, vì những lỗi còn sót đều là lỗi không làm gì báo đỏ.
Công cụ tự chuyển đổi làm tốt phần cú pháp. Nó không bảo đảm được ngữ nghĩa, tức là cùng một câu SQL có trả về cùng một kết quả trên hai nền tảng hay không. Việc của một FDE ở giai đoạn này là chứng minh điều đó bằng dữ liệu, rồi trình bằng chứng ấy cho khách hàng trước khi họ tắt hệ thống cũ.
Danh sách cảnh báo của công cụ mới chỉ là điểm bắt đầu
SnowConvert AI ghi lại những khác biệt giữa hai nền tảng mà nó không tự giải quyết được, dưới dạng EWI (errors, warnings, issues) và FDM. Chính Snowflake cũng khuyên rà lại code đã chuyển đổi trước khi deploy. Rất dễ nghĩ rằng xử lý hết danh sách đó là xong việc.
Cái bẫy là có những khác biệt mà công cụ đã hiểu và cố tình để nguyên, hoặc chỉ hiện ra khi chạy với dữ liệu thật. Vì vậy hãy coi danh sách EWI là bản đồ chỉ chỗ cần soát, đừng coi nó là danh sách việc phải làm cho xong. Bốn chỗ sau đáng soát đầu tiên.
| Bẫy | Hệ nguồn | Snowflake | Soát bằng cách |
|---|---|---|---|
| Chuỗi rỗng | Oracle coi ‘’ là NULL | ‘’ và NULL là hai giá trị khác nhau | Tìm REPLACE và CONCAT có ‘’ |
| Ép chuỗi sang số | Teradata đọc được chuỗi rỗng hoặc toàn khoảng trắng | Dễ lỗi khi chạy | Đếm các giá trị bẩn trong cột nguồn |
| GROUP BY văn bản | Teradata mặc định không phân biệt hoa thường | ‘ABC’ và ‘abc’ thành hai nhóm | So số nhóm giữa hai hệ |
| CHAR cố định | Teradata so khớp cả khoảng trắng đệm ở cuối | CHAR không đệm | Chạy lại các phép LIKE và hàm chuỗi |
Oracle: chuỗi rỗng không trống như bạn nghĩ
Tài liệu Oracle ghi rõ: một giá trị ký tự có độ dài bằng không được coi là NULL. Snowflake thì không làm vậy, nên SnowConvert viết lại các chuỗi rỗng thành NULL để giữ hành vi cũ. Trong phần lớn trường hợp, cách viết lại này đúng.
Ngoại lệ là các tham số của REPLACE và CONCAT. Tài liệu của SnowConvert nói phép biến đổi không áp dụng ở đây, vì nếu đổi chuỗi rỗng thành NULL trong các lời gọi này thì kết quả truy vấn sẽ khác. Thử hình dung một câu chuẩn hóa số điện thoại của khách:
-- Oracle, giữ nguyên sau chuyển đổi
SELECT ma_kh,
       REPLACE(so_dien_thoai, '-', '') AS sdt_sach
FROM khach_hang
WHERE ghi_chu IS NULL;
Dòng REPLACE được để nguyên có chủ đích, nhưng bạn vẫn phải chạy nó trên cả hai hệ để chắc kết quả khớp. Dòng WHERE mới là chỗ đáng lo hơn. Trên Oracle, IS NULL bắt luôn những ghi chú “trống”, vì Oracle không lưu chuỗi rỗng. Nếu quá trình nạp dữ liệu sang Snowflake để lại ‘’ trong cột ghi_chu, những dòng đó sẽ lặng lẽ biến khỏi kết quả.
Một truy vấn đối chiếu chạy trên cả hai hệ
Cách kiểm tra đầu tiên rất đơn giản: với mỗi cột văn bản quan trọng, đếm riêng số NULL, số chuỗi rỗng và số chuỗi chỉ có khoảng trắng ở hai bên. Trên Snowflake, truy vấn như sau:
-- Snowflake (Teradata dùng được gần như nguyên văn)
SELECT
  COUNT(*) AS tong_dong,
  SUM(CASE WHEN ghi_chu IS NULL THEN 1 ELSE 0 END) AS so_null,
  SUM(CASE WHEN ghi_chu = '' THEN 1 ELSE 0 END) AS so_rong,
  SUM(CASE WHEN ghi_chu <> '' AND TRIM(ghi_chu) = ''
           THEN 1 ELSE 0 END) AS so_toan_khoang_trang
FROM khach_hang;
Trên Oracle, phép so = '' không bao giờ đúng vì chuỗi rỗng đã là NULL, nên cột so_rong luôn bằng 0. Muốn đếm chuỗi toàn khoảng trắng, hãy đổi điều kiện thành ghi_chu IS NOT NULL AND TRIM(ghi_chu) IS NULL.
Khi so, cộng so_null với so_rong của Snowflake rồi đối chiếu với so_null của Oracle: lệch một con số là bạn biết phải xem lại những truy vấn lọc theo IS NULL nào.
Cùng tinh thần đó, với cột sắp đi vào GROUP BY, hãy so COUNT(DISTINCT thanh_pho) với COUNT(DISTINCT UPPER(thanh_pho)) trên Snowflake. Hai số khác nhau nghĩa là cột có giá trị chỉ khác nhau về chữ hoa thường, và báo cáo gộp nhóm sẽ lệch so với Teradata như phần dưới đây mô tả.
Teradata: dễ dãi ở chỗ bạn ít ngờ nhất
Với Teradata, khác biệt nằm ở mức độ “dễ tính”. Khi ép chuỗi sang số, Teradata đọc được cả chuỗi rỗng hay chuỗi toàn khoảng trắng, còn Snowflake thì chặt hơn. Một câu CAST(ma_buu_chinh AS INTEGER) chạy êm suốt nhiều năm có thể hỏng ngay khi gặp lần đầu những dòng như vậy. Lỗi này chỉ hiện ra lúc chạy chứ không hiện ra lúc chuyển đổi.
Khó thấy hơn nữa là GROUP BY. Teradata mặc định so chuỗi không phân biệt hoa thường (NOT CASESPECIFIC). Snowflake coi các giá trị khác nhau về chữ hoa chữ thường là khác nhau, trừ khi bạn đặt collation:
SELECT thanh_pho, COUNT(*) AS so_don, SUM(tong_tien) AS doanh_thu
FROM don_hang
GROUP BY thanh_pho;
Thử hình dung cột thanh_pho có cả ‘Ha Noi’ lẫn ‘HA NOI’. Trên Teradata đó là một nhóm. Trên Snowflake, câu trên trả về hai dòng, và báo cáo doanh thu theo thành phố bỗng có thêm một “thành phố mới”. Tổng toàn bảng vẫn khớp, nên phép kiểm tra tổng không bắt được lỗi này.
CHAR độ dài cố định là cái bẫy thứ ba. Teradata đệm khoảng trắng vào cuối giá trị, và một số hàm so khớp với toàn bộ giá trị, kể cả phần đệm đó. CHAR của Snowflake không đệm, nên các phép LIKE và hàm chuỗi chạy trên cột CHAR cần được chạy lại để so.
Kiểm tra dữ liệu: ba mức, đi từ rẻ đến đắt
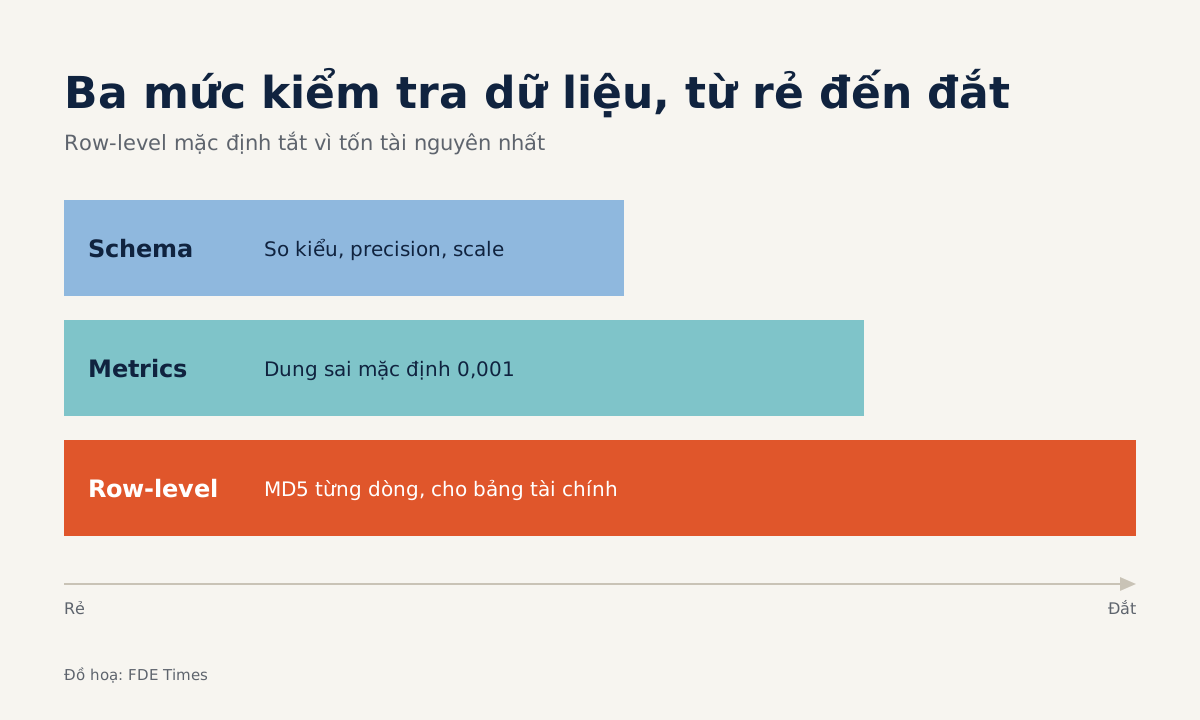
Phần soát code cho bạn biết nên nghi ngờ chỗ nào. Phần so dữ liệu mới là bằng chứng. Quy trình kiểm tra dữ liệu của Snowflake có ba mức: schema, metrics và row-level. Mức row-level mặc định bị tắt vì tốn tài nguyên nhất.
Ở mức schema, bạn so kiểu dữ liệu, độ chính xác (precision) và số chữ số thập phân (scale). Khi precision hoặc scale ở nguồn lớn hơn cột đích trên Snowflake, quy trình sẽ báo khác biệt ở từng mức.
Mức metrics so các chỉ số tổng hợp với dung sai mặc định 0,001. Hãy hỏi khách hàng xem dung sai đó có chấp nhận được cho cột tiền của họ không, đừng tự mặc định là được.
Mức row-level lấy chữ ký của từng partition ở phía nguồn, gồm các cột khóa chính cộng một mã băm MD5 của cả dòng. Partition nào lệch thì được soi tiếp đến từng ô. Mức này đắt, vì vậy nên bật cho những bảng đi vào báo cáo tài chính hoặc báo cáo gửi cơ quan quản lý, còn các bảng log thì dùng metrics là đủ.
Datafold, một công ty làm công cụ migration, cho rằng việc kiểu dữ liệu lệch nhau một cách lặng lẽ là nguyên nhân phổ biến của sai lệch sau migration, và khuyên kiểm tra mọi cột chứ không chỉ đếm số dòng. Ví dụ GROUP BY ở trên cho thấy lý do: số dòng ở bảng gốc khớp hoàn toàn, chỉ có kết quả gộp nhóm là sai.
Thứ tự làm việc tại chỗ khách hàng
Bắt đầu từ danh sách EWI và FDM, xếp các file theo mức độ quan trọng với nghiệp vụ chứ không theo số cảnh báo. Sau đó grep toàn bộ code đã chuyển để tìm bốn mẫu trong bảng ở trên: REPLACE và CONCAT có chuỗi rỗng, các phép ép kiểu sang số, GROUP BY theo cột văn bản, và hàm chuỗi trên cột CHAR.
Tiếp theo, chạy schema và metrics cho mọi bảng, rồi bật row-level cho một nhóm bảng nhỏ mà bạn và khách hàng đã thống nhất là “không được sai”. Trong lúc so, đóng băng dữ liệu đã migrate: tài liệu của Snowflake dặn không sửa dữ liệu trong quá trình kiểm tra, nếu không kết quả kiểm tra sẽ sai lệch.
Sai lầm hay gặp nhất là báo cáo “đã khớp số dòng” như thể đó là bằng chứng hoàn tất. Sai lầm thứ hai là sửa lệch ngay trên bảng đích mà không ghi lại, khiến lần chạy kiểm tra sau mất mốc để so. Sai lầm thứ ba là chỉ xử lý những gì công cụ đã đánh dấu và bỏ qua những chỗ nó cố tình để nguyên.
Biến việc này thành điểm cộng trong hồ sơ
Nếu bạn nhắm tới vai FDE hay solutions engineer mảng data, kinh nghiệm migration chỉ có giá trị khi bạn kể được phần kiểm tra. Khi viết CV, đừng ghi chung chung “tham gia chuyển đổi sang Snowflake”.
Hãy mô tả bạn đã kiểm tra những bảng nào, ở mức nào, tìm ra loại khác biệt ngữ nghĩa nào và sửa ra sao. Người đọc CV sẽ hiểu ngay bạn là người chịu trách nhiệm về số liệu chứ không chỉ người bấm nút chạy công cụ.
Khách hàng ít khi nhớ dự án migration đã chuyển bao nhiêu nghìn dòng SQL. Họ sẽ nhớ báo cáo doanh thu tháng đầu tiên trên Snowflake có khớp với hệ thống cũ hay không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!