Thực hành: dựng agent biết hỏi lại khi yêu cầu mơ hồ, rồi đo xem hỏi có đáng không
Agent hỏi quá ít thì làm sai, hỏi quá nhiều thì người dùng bỏ đi, và bạn chỉ biết mình đang mắc lỗi nào khi có số đo.

Tóm tắt nhanh
- Mô hình thường mặc định một cách hiểu cho yêu cầu mơ hồ, và mẹo prompt như CoT hay few-shot gần như không chữa được tật này.
- Trong Agent SDK, agent hỏi lại qua AskUserQuestion; nếu giới hạn danh sách tools mà quên thêm tool này thì agent không hỏi được.
- Đo hỏi thiếu và hỏi thừa riêng ra, rồi so với một bản đoán thẳng không được hỏi: hỏi chỉ đáng khi kết quả tốt hơn.
Khách hàng gõ “làm báo cáo doanh thu tháng này”, và agent của bạn chạy ngay. Nó chọn doanh thu gộp, tính theo múi giờ của server, gom mọi khu vực lại, rồi trả về một con số trông rất tự tin. Trong khi đó, người hỏi lại cần doanh thu thuần của riêng một chi nhánh.
Lỗi này rất phổ biến. Nhóm nghiên cứu viết bài “Modeling Future Conversation Turns” (có tác giả từ Google) ghi nhận LLM hiện nay hay trả lời bằng cách mặc định chỉ có một cách hiểu cho yêu cầu mơ hồ. ClarifyMT-Bench, bộ đo gồm 6.120 hội thoại nhiều lượt, cho thấy cả mười LLM được thử đều có xu hướng hỏi thiếu.
Với một FDE, đây là chuyện hằng ngày chứ không phải chuyện nghiên cứu. Yêu cầu ở chỗ khách gần như luôn thiếu ngữ cảnh. Bài này hướng dẫn dựng một agent biết hỏi lại, sau đó dựng một bộ eval nhỏ trả lời câu hỏi khó hơn: hỏi như vậy có đáng không.
Vì sao không chỉ cần sửa prompt?
Phản xạ đầu tiên của nhiều người là thêm vào system prompt câu “nếu chưa rõ thì hãy hỏi”. Benchmark CLAMBER (ACL 2024) đã thử các kỹ thuật kiểu chain-of-thought và few-shot. Kết quả: khả năng nhận ra câu hỏi mơ hồ chỉ nhích lên rất ít, có khi còn làm mô hình tự tin quá mức.
CLAMBER cũng thấy LLM viết câu hỏi làm rõ chưa tốt, vì không xử lý được chỗ các cách hiểu mâu thuẫn nhau. Như vậy có hai việc riêng: biết khi nào nên hỏi, và hỏi cho trúng. DiscoBench, một benchmark cho search agent, cũng kết luận rằng phát hiện mơ hồ và hỏi làm rõ hiệu quả là hai năng lực khác nhau.
Vì thế cách làm đúng là xây cơ chế hỏi vào hạ tầng của agent, rồi đo từng năng lực một. Viết prompt hay hơn chưa đủ.
Bạn sẽ dựng gì, và cần gì?
Bạn sẽ dựng hai thứ. Thứ nhất là một agent viết bằng Claude Agent SDK, hỏi lại qua tool AskUserQuestion, có giới hạn số lượt hỏi. Thứ hai là một script eval chấm agent trên một tập yêu cầu đã gắn nhãn.
Bạn cần một project đã cài Agent SDK, một agent sẵn có (agent chỉ đọc dữ liệu là đủ), và 20 yêu cầu mẫu. Code bên dưới là phác thảo đã lược bớt để thấy rõ cấu trúc. Trước khi chạy, hãy đối chiếu tên hàm và kiểu dữ liệu với trang “Handle approvals and user input” trong docs SDK.
Bước 1–3: cho agent quyền hỏi, và chặn lại khi nó hỏi
Bước 1. Thêm AskUserQuestion vào danh sách tools. Theo docs SDK, Claude gọi AskUserQuestion khi cần thêm định hướng cho một tác vụ có nhiều cách làm hợp lệ. Nếu bạn đã giới hạn tools, chẳng hạn để agent chỉ được đọc, thì phải thêm tool này vào mảng đó. Không thêm thì agent không hỏi lại được.
// Phác thảo — đã lược giản
const options = {
  allowedTools: [...READ_ONLY_TOOLS, "AskUserQuestion"],
  canUseTool: handleTool,
};
Kiểm tra: đưa agent một yêu cầu cố tình mơ hồ, ví dụ “tổng hợp số liệu tháng này”, rồi xem log có lệnh gọi AskUserQuestion không.
Bước 2. Chặn lệnh gọi trong canUseTool. Mỗi lần agent gọi AskUserQuestion, SDK sẽ kích hoạt callback canUseTool của ứng dụng. Đây là chỗ bạn hiện câu hỏi cho người dùng, lấy câu trả lời và ghi log để phục vụ eval sau này.
// Phác thảo — đã lược giản
let asks = 0;
const MAX_ASKS = 2;

async function handleTool(toolName, input) {
  if (toolName !== "AskUserQuestion") return allow(input);
  asks += 1;
  log({ type: "ask", round: asks, input });
  if (asks > MAX_ASKS) return answerWith(input, "Tự chọn phương án hợp lý nhất và ghi rõ giả định");
  const answers = await showToUser(input);
  return answerWith(input, answers);
}
Bước 3. Đặt điều kiện dừng. Bài “Building effective agents” của Anthropic khuyên đặt điều kiện dừng, chẳng hạn số vòng lặp tối đa, để giữ quyền kiểm soát agent. Vòng hỏi lại cũng cần như vậy. Con số hai lượt ở trên là lựa chọn thiết kế của bạn, không phải giá trị mặc định của SDK.
Khi hết lượt, agent phải tự quyết và ghi lại giả định để người dùng còn kiểm tra.
Kiểm tra: thử một yêu cầu mơ hồ ở ba chỗ khác nhau. Agent phải dừng hỏi sau lượt thứ hai, và kết quả phải có phần ghi giả định.
Ba lỗi dễ mắc khi bật tính năng hỏi
Lỗi dễ mắc nhất là để subagent hỏi. Docs SDK ghi rõ AskUserQuestion chưa dùng được trong subagent. Mọi câu hỏi vì thế phải đi qua agent chính, nên bạn cần thiết kế để subagent trả nhu cầu làm rõ về cho agent chính.
Kế đến là dồn quá nhiều vào một câu hỏi. Mỗi lần gọi chỉ được 1–4 câu, mỗi câu 2–4 lựa chọn. Giới hạn này thực ra có lợi, vì nó buộc agent đưa ra vài cách hiểu cụ thể như “doanh thu gộp hay thuần?” thay vì hỏi chung chung “bạn muốn gì?”.
Cuối cùng là để callback treo mãi. Docs SDK cho biết callback có thể chờ vô thời hạn và agent đứng yên đến khi callback trả về. Khách hàng thì có thể trả lời sau nửa ngày; với trường hợp này, docs khuyên dùng PreToolUse hook với quyết định defer, để tiến trình thoát ra và chạy tiếp khi có câu trả lời.
Bước 4–5: đo hỏi thiếu và hỏi thừa riêng ra
Chỉ đếm số lần agent hỏi thì vô nghĩa. ClarifyMT-Bench thấy các mô hình hỏi thiếu, nhưng chính nghiên cứu này cũng ghi nhận điều ngược lại: mô hình hay hỏi thừa với những đầu vào đáng lẽ phải từ chối. Muốn biết agent của bạn đang lệch về phía nào, bạn phải đo cả hai.
Bước 4. Gắn nhãn dữ liệu. Mỗi mẫu gồm yêu cầu, nhãn should_ask và intent, tức ý định thật mà một người dùng giả lập sẽ dùng để trả lời khi bị hỏi.
cases = [
    {"prompt": "Báo cáo doanh thu tháng này", "should_ask": True,
     "intent": "doanh thu thuần, chi nhánh Bắc"},
    {"prompt": "Đếm số đơn hủy ngày 3/11 trong bảng orders", "should_ask": False,
     "intent": None},
]
Bước 5. Tính hai tỉ lệ.
def score(results):
    amb = [r for r in results if r["should_ask"]]
    clear = [r for r in results if not r["should_ask"]]
    under = sum(not r["asked"] for r in amb) / len(amb)
    over = sum(r["asked"] for r in clear) / len(clear)
    return under, over
Thử hình dung tập 20 mẫu của bạn chia đôi: 10 mơ hồ, 10 rõ ràng. Agent hỏi ở 6 mẫu mơ hồ, tức bỏ sót 4, nên tỉ lệ hỏi thiếu là 40%.
Nó cũng hỏi ở 2 mẫu rõ ràng, tức 20% hỏi thừa. Hai con số này dẫn tới hai cách sửa khác nhau, nhưng nếu chỉ đếm tổng thì bạn thấy 8 lần hỏi và không biết phải sửa gì.
Hỏi có đáng không? So với một agent chỉ biết đoán
Đây là bước nhiều đội bỏ qua. DiscoBench không so việc hỏi với việc đoán; nó so việc cứ tìm kiếm tiếp thay vì hỏi lại với việc đoán thẳng, và thấy tìm tiếp thường kém hơn: tỉ lệ đạt trung bình 51,9% so với 56,5%. Bài học rút ra được là hành vi trông có vẻ cẩn thận chưa chắc cho kết quả tốt hơn.
Phép so giữa hỏi và đoán thì không benchmark nào làm thay bạn trên dữ liệu của khách. Bạn phải tự đo.
Bước 6. Chạy so sánh. Chạy cùng 20 mẫu với hai cấu hình: một có AskUserQuestion và một bỏ nó ra khỏi allowedTools. Cấu hình thứ hai buộc agent phải đoán. Chấm cả hai bằng cùng một tiêu chí đạt/không đạt dựa trên intent.
Tiếp tục ví dụ giả định ở trên, bảng kết quả có thể trông như sau:
| Chỉ số (20 mẫu, số giả định) | Có AskUserQuestion | Đoán thẳng |
|---|---|---|
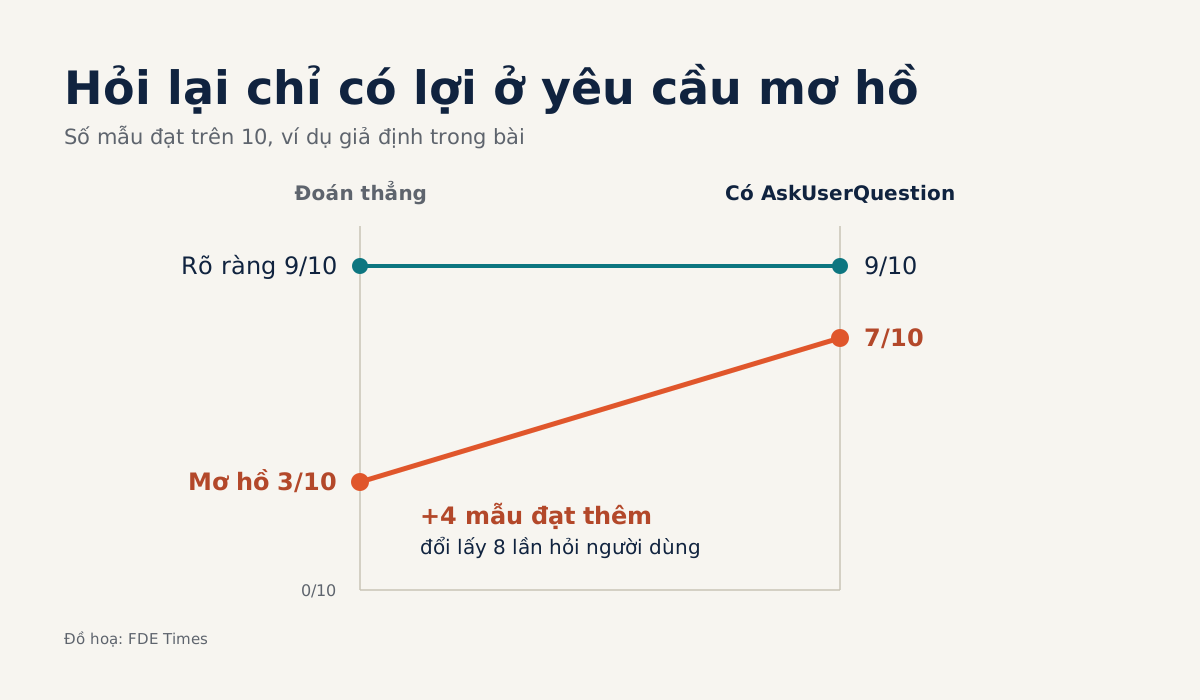
| Đạt trên 10 mẫu mơ hồ | 7/10 | 3/10 |
| Đạt trên 10 mẫu rõ ràng | 9/10 | 9/10 |
| Tổng đạt | 16/20 | 12/20 |
| Số lần bắt người dùng trả lời | 8 | 0 |
Cách đọc: bản có hỏi đổi 8 lần làm phiền lấy 4 mẫu đạt thêm, và cả 4 đều nằm ở nhóm mơ hồ.
Nhưng 2 trong 8 lần hỏi rơi vào mẫu rõ ràng mà không làm tăng tỉ lệ đạt ở nhóm đó, nên việc đầu tiên cần sửa là chặn hỏi thừa.
Nếu cột bên trái không đạt cao hơn rõ rệt, chi phí bắt người dùng trả lời là không đáng.
Bước 7. Chấm chất lượng câu hỏi. Câu hỏi tốt là câu mà mỗi lựa chọn dẫn tới một hướng làm khác nhau, và ít nhất một lựa chọn khớp với ý định thật. Cách kiểm tra đơn giản: với mỗi lần hỏi đã ghi log, cho người dùng giả lập chọn lần lượt từng phương án, chạy lại agent, rồi so các kết quả.
# Phác thảo — đã lược giản; normalize() tùy dữ liệu của bạn
def question_quality(case, ask, run_with_answer, matches):
    outputs = {opt: normalize(run_with_answer(case, opt))
               for opt in ask["options"]}
    branches = len(set(outputs.values())) > 1   # các lựa chọn có đổi kết quả không
    on_target = any(matches(opt, case["intent"]) for opt in ask["options"])
    return {"branches": branches, "on_target": on_target}
Với câu “doanh thu gộp hay thuần?”, hai lựa chọn cho ra hai con số khác nhau và một trong đó khớp intent, nên câu đạt cả hai tiêu chí. Nếu chọn phương án nào agent cũng làm y như nhau, branches bằng False: câu hỏi đó chỉ làm chậm người dùng.
Ở chỗ khách hàng, kỹ năng này trông thế nào
Bộ eval này là thứ bạn có thể mang vào buổi review với khách. Thay vì nói “agent đã biết hỏi lại”, bạn đặt bảng so sánh ở trên lên màn hình, với số thật của khách thay cho số giả định.
Tập mẫu tốt nhất lấy từ ticket thật của chính khách, vì ở mỗi công ty, chỗ mơ hồ nằm ở những thuật ngữ khác nhau. Bài tập cuối cho bạn: chạy đủ bảy bước trên 20 ticket đó, điền bảng, rồi viết một câu kết luận nên giữ hay bỏ AskUserQuestion.
Về sự nghiệp, hãy ghi trong CV và kể trong buổi phỏng vấn đúng cách bạn đo, chứ không chỉ liệt kê tính năng. Một dòng kiểu “giảm tỉ lệ hỏi thừa trên tập yêu cầu thật của khách, có so với bản đoán thẳng” cho người tuyển thấy bạn biết đánh giá agent.
Khi đọc JD, hãy để ý những đoạn nhắc tới việc đánh giá agent hoặc để con người duyệt giữa chừng. Đó là chỗ bạn nên đem bộ eval này ra kể.
Anthropic mô tả agent tự làm việc nhưng có thể quay lại hỏi con người khi cần thêm thông tin hoặc cần con người phán đoán. Còn quay lại vào lúc nào thì đừng phó mặc cho cảm giác của mô hình: hãy để số đo trên dữ liệu của khách quyết định.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Building effective AI agents (Anthropic) · 2024-12-19
- CLAMBER: A Benchmark of Identifying and Clarifying Ambiguous Information Needs in Large Language Models · 2024-05-20
- Modeling Future Conversation Turns to Teach LLMs to Ask Clarifying Questions · 2024-10-17
- ClarifyMT-Bench: Benchmarking and Improving Multi-Turn Clarification for Conversational Large Language Models · 2025-12-24
- When Search Agents Should Ask: DiscoBench for Clarification-Aware Deep Search
- Handle approvals and user input (Claude Agent SDK docs)