Dựng MCP server giả có sẵn lỗi timeout, 429 và đổi schema để test agent không cần mạng
Agent của bạn chạy mượt trên demo, nhưng chưa ai biết nó làm gì khi tool treo 30 giây hay trả về một trường dữ liệu đã bị đổi tên.

Tóm tắt nhanh
- Theo spec MCP, lỗi tool đi theo hai kênh: lỗi giao thức JSON-RPC và lỗi thực thi có isError: true, nên fake server phải giả lập được cả hai.
- Bộ lỗi tối thiểu nên có: 429 kèm retry-after, 429 không kèm retry-after, tool treo, tool không tồn tại, và dữ liệu trả về sai schema.
- Chạy theo kịch bản cố định, không cần mạng, test lặp lại được: đây là thứ cho phép bạn chứng minh với khách hàng rằng agent chịu được lỗi.
Spec MCP chỉ dành một dòng ngắn cho khuyến nghị client đặt timeout khi gọi tool. Dòng đó dễ bị lướt qua lúc làm demo. Lúc khách hàng nối agent vào CRM thật thì mọi thứ đổi khác: API của họ có rate limit, có lúc bảo trì, và đội backend có thể đổi tên một trường dữ liệu mà không báo ai.
Bài hướng dẫn này dựng một MCP server giả bằng Python. Server có cùng tên tool với hệ thống thật nhưng gây lỗi theo kịch bản bạn chọn. Cả bộ test chạy trên laptop, không cần mạng, lần nào chạy cũng cho cùng một kết quả.
Họ muốn biết agent làm gì khi hệ thống của họ hỏng. Có sẵn một bộ test lỗi, bạn trả lời được bằng kết quả chạy ngay trước mắt họ chứ không chỉ bằng lời.
Bạn cần hiểu hai kênh lỗi trước khi viết dòng code nào
Spec MCP (bản 2025-06-18) quy định tool báo lỗi theo hai cơ chế. Loại thứ nhất là lỗi giao thức JSON-RPC, ví dụ gọi một tool không tồn tại sẽ nhận mã -32602. Loại thứ hai là lỗi thực thi tool: kết quả vẫn được trả về bình thường nhưng có isError: true. Lỗi API và lỗi nghiệp vụ thuộc loại này.
Hai loại lỗi đến từ hai kênh khác nhau, nên agent của bạn cũng nên có hai nhánh xử lý riêng. Một cách chia hợp lý là chuyển lỗi thực thi cho model đọc để nó quyết định thử lại hay đổi hướng, còn lỗi giao thức thì ghi log như lỗi tích hợp để người sửa. Đây là gợi ý thiết kế, không phải điều spec bắt buộc.
Spec còn có sẵn một ví dụ lỗi thực thi cho rate limit, với nội dung “Failed to fetch weather data: API rate limit exceeded”. Bạn có thể lấy luôn câu đó làm khuôn cho thông điệp của lỗi 429 giả.
Cần chuẩn bị gì?
Bạn cần Python 3.10 trở lên, pytest kèm plugin chạy test async, và thư viện FastMCP. Python SDK chính thức của MCP cho phép định nghĩa server chỉ bằng các hàm có type hint và docstring, mỗi tool đăng ký bằng một decorator. FastMCP còn cho phép bọc server trong một Client để test ngay trong cùng tiến trình, không phải mở MCP Inspector riêng.
Code bên dưới đã được rút gọn để dạy ý tưởng. Tên lớp, tham số và cách ánh xạ exception có thể khác giữa các phiên bản, nên hãy đối chiếu với tài liệu của bản SDK bạn cài.
Bước 1: viết server nhận kịch bản lỗi từ biến môi trường
Nguyên tắc là kịch bản phải tất định. Thay vì cho lỗi xảy ra ngẫu nhiên 10% số lần, bạn truyền vào một chuỗi lỗi cố định, ví dụ 429,ok: lần gọi đầu bị rate limit, lần thứ hai thành công. Nhờ vậy, test hôm nay pass thì mai cũng pass.
# fake_crm.py (đã rút gọn)
import asyncio, os
from fastmcp import FastMCP
from fastmcp.exceptions import ToolError

mcp = FastMCP("fake-crm")
PLAN = [f for f in os.environ.get("FAULTS", "").split(",") if f]
state = {"n": 0}

def next_fault() -> str:
    i = state["n"]; state["n"] += 1
    return PLAN[i] if i < len(PLAN) else "ok"

@mcp.tool
async def get_order(order_id: str) -> dict:
    """Lấy đơn hàng theo mã."""
    fault = next_fault()
    if fault == "429":
        raise ToolError("API rate limit exceeded. retry-after: 2")
    if fault == "429cap":
        raise ToolError("API rate limit exceeded: monthly spend cap reached")
    if fault == "hang":
        await asyncio.sleep(3600)
    if fault == "drift":
        return {"orderId": order_id, "total": "12.5"}
    return {"order_id": order_id, "status": "shipped", "total": 12.5}
PLAN được đọc từ FAULTS một lần lúc import. Trong test, bạn ghi đè nó bằng monkeypatch và đặt lại bộ đếm, để mỗi test có kịch bản riêng mà không phải khởi động lại tiến trình.
Kiểm tra: tạo file test_fake_crm.py với test “đường vui” đầu tiên, kịch bản rỗng, rồi chạy pytest -q test_fake_crm.py.
# test_fake_crm.py (đã rút gọn)
import pytest
from fastmcp import Client
from fake_crm import mcp, state

@pytest.mark.asyncio
async def test_khong_loi(monkeypatch):
    monkeypatch.setattr("fake_crm.PLAN", [])
    state["n"] = 0
    async with Client(mcp) as client:
        r = await client.call_tool("get_order", {"order_id": "A1"})
        assert not r.is_error
Test này phải pass và trả về đơn hàng có status là shipped. Nếu bước này chưa chạy được thì đừng làm tiếp.
Bước 2: vì sao cần tới hai kiểu 429?
Mẫu lỗi ở đây mượn từ tài liệu của Claude API, một API HTTP thật. Với 429 thông thường, header retry-after cho biết phải chờ bao nhiêu giây, và retry sớm hơn sẽ thất bại.
Rate limit của Claude API chạy theo token bucket, tức dung lượng hồi lại dần chứ không reset vào một mốc cố định. Nhưng 429 do chạm trần chi tiêu theo tier thì không có retry-after, và retry bao nhiêu lần cũng thất bại cho tới khi quyền truy cập được mở lại.
Cần nói rõ: tool trong fake server không trả HTTP 429 và không có header nào. Nó chỉ chép lại hai mẫu hành vi đó vào một ToolError dạng văn bản, retry-after: 2 nằm ngay trong thông điệp lỗi. Nếu backend thật của khách hàng là HTTP, tầng code gọi API của bạn sẽ thấy header thật, và bạn nên mock ở cả tầng đó.
Vì thế fake server có cả 429 lẫn 429cap. Agent tốt sẽ chờ rồi thử lại với loại thứ nhất. Với loại thứ hai, nó dừng và báo cho người dùng thay vì retry vô ích. Thêm test sau vào cùng file:
@pytest.mark.asyncio
async def test_429_la_loi_thuc_thi(monkeypatch):
    monkeypatch.setattr("fake_crm.PLAN", ["429", "ok"])
    state["n"] = 0
    async with Client(mcp) as client:
        r = await client.call_tool("get_order", {"order_id": "A1"},
                                   raise_on_error=False)
        assert r.is_error  # kênh isError, không phải lỗi JSON-RPC
Kiểm tra: kết quả phải có cờ lỗi chứ không ném exception giao thức. Nếu client ném exception, nghĩa là bạn đang trộn hai kênh lỗi.
Bước 3: giả lập tool treo, rồi hủy request
Kịch bản hang mô phỏng một API không bao giờ trả lời. Spec khuyến nghị client đặt timeout, nên test phải khẳng định agent bỏ cuộc sau một khoảng thời gian có giới hạn.
import asyncio

@pytest.mark.asyncio
async def test_tool_treo_bi_cat(monkeypatch):
    monkeypatch.setattr("fake_crm.PLAN", ["hang"])
    state["n"] = 0
    async with Client(mcp) as client:
        with pytest.raises(asyncio.TimeoutError):
            await asyncio.wait_for(
                client.call_tool("get_order", {"order_id": "A1"}), timeout=5)
Sau timeout còn một chỗ dễ bỏ sót. Spec về cancellation nói bên nhận thông báo hủy nên dừng xử lý và không gửi response cho request đã bị hủy. Spec cũng thừa nhận có race condition: response có thể đã được gửi đi trước khi thông báo hủy tới nơi.
Hãy viết thêm một kịch bản server “trả lời muộn, ngay sau khi bị hủy” và kiểm tra agent bỏ qua câu trả lời đó thay vì ghép nó vào một lượt hội thoại khác.
Bước 4: lỗi giao thức và schema drift
Lỗi giao thức là phần dễ làm nhất: gọi get_ordr (cố tình viết sai tên). Theo spec, kết quả mong đợi là lỗi JSON-RPC kiểu -32602. Hãy kiểm tra xem SDK của bạn có ánh xạ đúng như vậy không, và agent có ghi log thành lỗi tích hợp thay vì nhét vào prompt hay không.
Schema drift khó phát hiện hơn. Kịch bản drift đổi order_id thành orderId và biến total từ số thành chuỗi. Kết quả này về tới agent như một lần gọi thành công, không có isError, không có lỗi JSON-RPC, nên nó không đi qua kênh lỗi nào cả.
Nếu tool khai báo outputSchema, spec bắt buộc server trả kết quả đúng schema và khuyến nghị client validate. Fake server cố tình vi phạm điều đó để xem client có bắt được lỗi không, hay agent lặng lẽ cộng chuỗi “12.5” vào hóa đơn.
Spec còn có cơ chế báo danh sách tool thay đổi: server khai báo capability listChanged rồi phát notification notifications/tools/list_changed. Thêm một kịch bản phát notification này giữa phiên làm việc, sau đó kiểm tra agent có gọi lại tools/list trước lần gọi tool tiếp theo không. Mỗi SDK phát notification theo một cách khác nhau, nên phần này tùy vào thư viện bạn chọn.
Ba lỗi hay gặp nhất khi xử lý retry
Lỗi đầu tiên là chồng retry lên retry. SDK chính thức của Claude mặc định tự retry lỗi tạm thời hai lần, với exponential backoff, và tôn trọng retry-after.
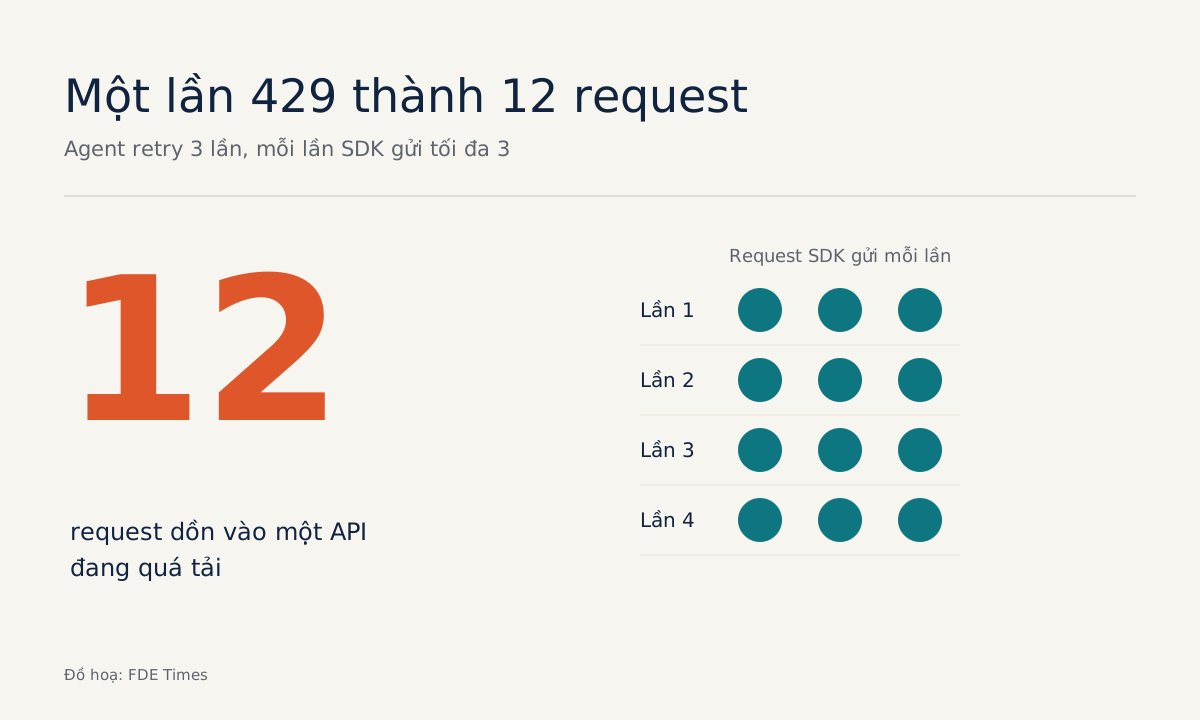
Thử tính: vòng lặp agent của bạn tự retry 3 lần, tức 4 lần gọi tính cả lần đầu, và mỗi lần SDK lại gửi tối đa 3 request. Một lần gặp 429 có thể biến thành 12 request dồn vào một API vốn đang quá tải.
Lỗi thứ hai là retry theo nhịp cố định mà không đọc retry-after. Lỗi thứ ba là gom mọi 429 vào một nhánh xử lý, nên agent cứ thử lại mãi trong trường hợp chạm trần chi tiêu. Bộ lỗi của bạn cũng nên có thêm 504 timeout_error và 529 overloaded_error, hai lỗi tạm thời khác ngoài 429 được liệt kê trong tài liệu của Claude API.
Kỹ năng này xuất hiện ở đâu khi làm cho khách hàng?
Thử hình dung tuần đầu tiên tại một công ty logistics. Bạn chưa có quyền truy cập API sản xuất, và môi trường staging thì một ngày chỉ chạy được vài tiếng. Fake server cho phép bạn làm việc song song.
Bạn xin họ tài liệu mô tả rate limit và schema, dựng fake theo đúng tài liệu đó, và khi có quyền truy cập thật thì bộ test lỗi đã sẵn sàng.
Việc nên làm đầu tiên là hỏi đội vận hành của khách hàng ba câu: API trả 429 kèm header gì, timeout thực tế là bao lâu, và lần gần nhất schema bị đổi mà không báo trước là khi nào. Mỗi câu trả lời trở thành một kịch bản trong biến FAULTS.
Về hồ sơ xin việc, đừng chỉ viết “xây agent dùng MCP”. Hãy viết rằng bạn đã dựng bộ test chèn lỗi gồm bao nhiêu kịch bản, và nó bắt được lỗi gì trước khi lên production. Khi đọc mô tả công việc FDE, hãy để ý các cụm như “reliability”, “production readiness” hay “integration testing”.
Một bộ FAULTS tốt sẽ lớn dần theo từng sự cố thật, vì mỗi lần hệ thống của khách hàng hỏng theo một kiểu mới thì bạn thêm được một dòng vào kịch bản.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!