Tích hợp chạy tốt một giờ rồi treo: tìm lỗi ở connection pool, timeout và hàng đợi
Khi lỗi lặp lại đúng sau mỗi giờ, thủ phạm thường không nằm trong code của bạn mà nằm trên đường mạng của khách. Lỗi càng nặng hơn khi bạn phản ứng bằng cách tăng pool và thêm retry.

Tóm tắt nhanh
- Firewall hoặc NAT có thể cắt kết nối nhàn rỗi, ví dụ sau 60 phút, mà không gửi tín hiệu đóng TCP. Pool vẫn tưởng kết nối đó còn sống.
- Đặt TTL của kết nối ngắn hơn idle timeout ngắn nhất trên đường đi và bật dọn dẹp chạy nền. Đừng tăng cỡ pool.
- Retry ở một tầng duy nhất, có jitter. Với hàng đợi, đo tuổi message chứ không chỉ đo độ dài.
Bản demo chạy trơn tru suốt buổi sáng. Sau bữa trưa, có lúc hệ thống đứng im khoảng một tiếng, rồi request đầu tiên treo cho tới khi hết timeout, kéo theo vài chục request khác. Bạn restart service và mọi thứ chạy lại, đúng tới lần treo sau.
Lý do khá dễ hiểu khi bạn so hai môi trường. Ở laptop của bạn, giữa ứng dụng và database không có thiết bị nào. Ở công ty khách thì có firewall, NAT gateway, load balancer, và mỗi thiết bị có luật riêng mà không ai ghi vào tài liệu tích hợp.
Bài này dạy bạn đọc sự cố theo ba lớp: kết nối, timeout và retry, rồi hàng đợi. Phản xạ phổ biến nhất ở cả ba lớp là tăng pool, tăng retry, thêm worker, và cả ba phản xạ đó đều làm sự cố nặng hơn.
Kết nối chết mà pool vẫn tưởng còn sống
Tài liệu hạ tầng Nais mô tả cơ chế này rất rõ. Firewall có trạng thái (stateful), NAT gateway và load balancer đều xóa các entry đã nhàn rỗi quá lâu, và thường không gửi tín hiệu đóng TCP nào. Phía bạn không ai biết kết nối đã mất. Connection pool vẫn coi nó là kết nối khỏe và đưa ra cho request tiếp theo.
Ví dụ cụ thể trong tài liệu ấy là một firewall bỏ kết nối sau 60 phút nhàn rỗi mà không gửi tín hiệu đóng. Vì thế lỗi hay xuất hiện “sau khoảng một giờ” và thường vào giờ thấp điểm, khi một số kết nối trong pool không được dùng đủ lâu.
Nais khuyên đặt thời gian sống tối đa (TTL) của mỗi kết nối trong pool ngắn hơn idle timeout ngắn nhất trên đường mạng, và bật cơ chế dọn kết nối chạy nền. Chữ quan trọng là “ngắn nhất”. Nếu load balancer cắt sau 60 phút nhưng có một firewall nội bộ cắt sớm hơn, con số của firewall mới là con số bạn phải theo.
Ví dụ: đồng bộ đơn hàng vào ERP của khách
Thử hình dung bạn viết một service đẩy đơn hàng vào database của hệ thống ERP phía khách. Ban ngày đơn về liên tục. Từ 22 giờ tới 6 giờ sáng gần như không có đơn nào. Mỗi sáng, đơn đầu tiên treo khoảng 30 giây, sau đó loạt đơn kế tiếp lỗi theo.
Cách điều tra là hỏi đội mạng của khách một câu cụ thể: “Trên đường từ subnet của chúng tôi tới database ERP có những thiết bị nào, và idle timeout của từng thiết bị là bao nhiêu?”. Giả sử họ trả lời firewall cắt sau 60 phút. Khi đó cấu hình pool (ví dụ với HikariCP) sẽ trông như sau:
# idle timeout ngắn nhất trên đường mạng: 60 phút (firewall của khách)
maximumPoolSize=9
# TTL 50 phút, ngắn hơn 60 phút, có biên an toàn
maxLifetime=3000000
# định kỳ kiểm tra kết nối nhàn rỗi trước khi firewall kịp cắt
keepaliveTime=300000
Con số 50 phút là lựa chọn có chủ đích: đủ ngắn để kết nối luôn được thay trước khi firewall cắt, đủ dài để pool không phải mở kết nối mới liên tục. Hãy ghi nguồn của con số 60 phút vào runbook bàn giao, vì người tiếp quản sẽ không biết nó đến từ đâu.
Tăng pool lên là làm sự cố nặng hơn
Khi hệ thống treo, phản xạ đầu tiên của nhiều người là tăng maximumPoolSize từ 10 lên 100. Wiki của HikariCP nói ngược lại: để có throughput tốt nhất, số kết nối đang hoạt động nên ở quanh mức (số core × 2) + số ổ đĩa hiệu dụng.
Database chạy trên máy 4 core với một ổ đĩa sẽ cho (4 × 2) + 1 = 9 kết nối, đó là lý do cấu hình trên dùng 9.
Lý do nằm ở context switching. Wiki này viết rằng khi số thread vượt quá số core CPU, thêm thread chỉ làm hệ thống chậm đi. Pool 100 kết nối không làm biến mất kết nối chết. Nó chỉ tạo thêm nhiều kết nối có thể chết, và đè thêm tải lên database của khách đúng lúc database đang chật vật.
Ba tầng retry thành chín lần gọi
Lớp thứ hai là timeout và retry. Amazon Builders’ Library chỉ ra rằng timeout đặt quá thấp làm tăng tải và độ trễ ở backend, vì quá nhiều request bị retry. Timeout quá cao thì một kết nối chết giữ chân request rất lâu. Bạn cần đo độ trễ thật của hệ thống khách rồi mới chọn con số.
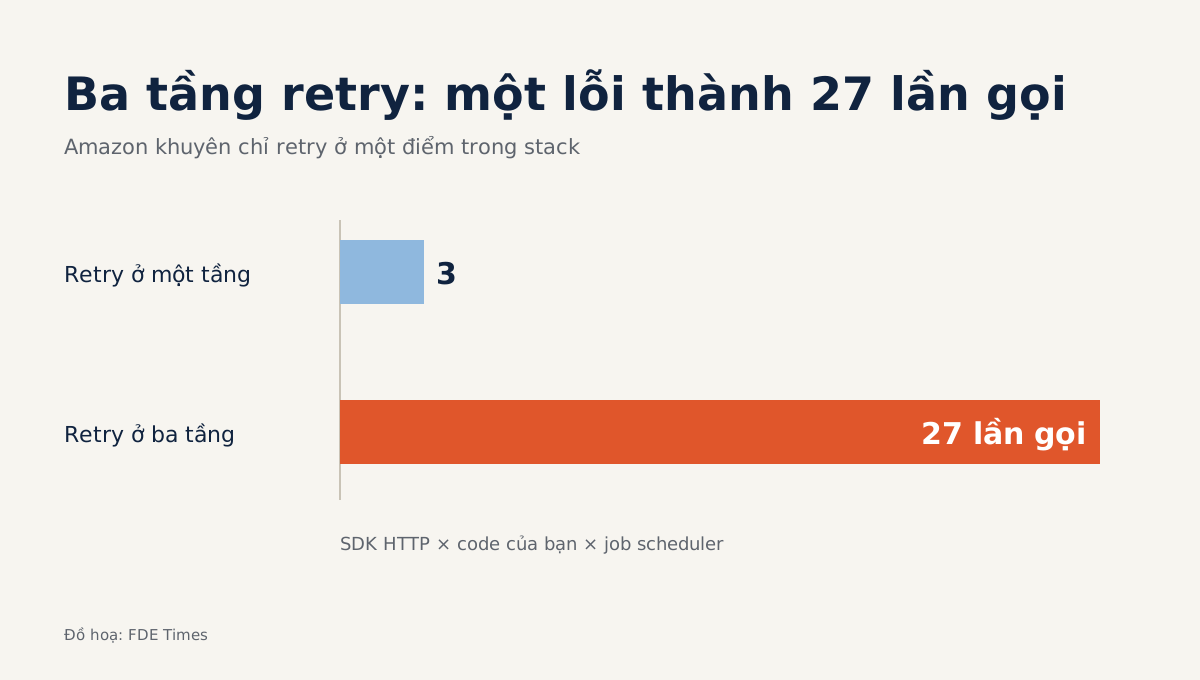
Nguy hiểm hơn là retry chồng nhiều tầng. Theo Amazon, retry ở mỗi tầng nhân lên nhau: ba lần thử thành chín, rồi cứ thế tăng tiếp.
Giả sử SDK HTTP retry 3 lần, code của bạn bọc thêm 3 lần, job scheduler chạy lại job 3 lần. Một request lỗi có thể thành 27 lần gọi vào hệ thống đang yếu.
Amazon khuyên chỉ retry ở một điểm duy nhất trong stack.
Ở tầng được giữ lại, hãy thêm jitter. Jitter đưa một lượng ngẫu nhiên vào backoff để các lần retry rải ra theo thời gian, nhờ đó các client không cùng lúc dội vào hệ thống của khách theo từng đợt.
import random, time

def call_with_retry(fn, attempts=3, base=0.5, cap=8.0):
    for i in range(attempts):
        try:
            return fn()
        except TransientError:
            if i == attempts - 1:
                raise
            # full jitter: chờ ngẫu nhiên từ 0 đến mức backoff hiện tại
            time.sleep(random.uniform(0, min(cap, base * 2 ** i)))
Khi đã đặt retry ở đây, hãy tắt retry tự động của SDK bên dưới và của scheduler bên trên.
Hàng đợi: đo tuổi, đừng chỉ đo độ dài
Lớp cuối cùng là hàng đợi, nơi lý giải vì sao khách vẫn phàn nàn sau khi bạn đã sửa xong pool. Amazon lưu ý rằng khi backlog đã hình thành, hệ thống có thể mất rất nhiều thời gian mới xử lý hết để quay về trạng thái nhanh. Lỗi gốc hết lúc 9 giờ, nhưng đơn hàng vẫn vào ERP trễ tới gần trưa.
Vì vậy Amazon tập trung đo tuổi của message trong hàng đợi chứ không chỉ đo độ dài. Một hàng đợi có 5.000 message nhưng message cũ nhất mới chờ vài giây là hàng đợi khỏe. Một hàng đợi có 200 message nhưng message cũ nhất đã nằm đó 40 phút là dấu hiệu hệ thống đang chậm, hoặc đang lỗi và retry lặp đi lặp lại.
Amazon cũng cho biết khi quá tải, nhiều hệ thống của họ tự động siết lại và từ chối nhiều yêu cầu hơn ngay từ phía producer, thay vì để hàng đợi phình ra.
Với tích hợp của bạn, điều này có nghĩa là trả lỗi rõ ràng về phía gửi khi tuổi message vượt ngưỡng. Như vậy tốt hơn là âm thầm nhận thêm việc rồi xử lý trễ vài giờ.
Những sai lầm hay gặp
Sai lầm đầu tiên là sửa bằng restart theo lịch. Cách này che triệu chứng, và người tiếp quản sẽ không bao giờ hiểu vì sao có cron restart lúc 3 giờ sáng. Sai lầm thứ hai là chỉ hỏi idle timeout của một thiết bị, trong khi con số cần dùng là timeout ngắn nhất trên cả đường đi.
Sai lầm thứ ba là để retry sống ở mọi tầng vì mỗi thư viện đều bật sẵn. Sai lầm thứ tư là cảnh báo theo độ dài hàng đợi, vốn dao động theo giờ cao điểm, thay vì theo tuổi message.
Nếu bạn từng gỡ một sự cố như vậy, hãy ghi nó vào CV bằng số liệu thay vì tính từ, chẳng hạn: “phát hiện firewall cắt kết nối nhàn rỗi sau 60 phút, đặt TTL của pool là 50 phút, gỡ retry trùng lặp ở ba tầng”.
Sự cố “một giờ” hiếm khi xuất phát từ một dòng code sai. Phần lớn nó đến từ một thiết bị mạng mà bạn chưa hỏi tới, nên câu hỏi đầu tiên ở site khách nên là: giữa hai hệ thống này có những gì?
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!