Phát hiện bất thường trên dữ liệu cảm biến: dựng baseline bằng median và MAD trước khi train model
Với mười giá trị đo nhiệt độ, Z-score kinh điển có thể bỏ sót một ổ trục đang nóng lên, còn một phép tính bằng tay theo median thì bắt được ngay.

Tóm tắt nhanh
- Z-score dùng trung bình và độ lệch chuẩn dễ bị chính giá trị bất thường kéo lệch, nhất là khi mẫu nhỏ; median và MAD thì bền hơn nhiều.
- Baseline chạy được trong production cần thêm bốn thứ: cửa sổ lùi, số mẫu tối thiểu, ngưỡng tĩnh dự phòng và cách xử lý tính mùa vụ.
- Bất thường chưa chắc là sự cố. Hãy ghép thêm ngữ cảnh rồi mới cảnh báo khách.
Thử hình dung tuần đầu bạn làm ở nhà máy của khách. Trưởng ca vận hành gửi bạn một file CSV nhiệt độ ổ trục của hai mươi máy bơm rồi hỏi: “Bên anh làm AI phát hiện bất thường được không?” Lúc này rất dễ mở notebook ra thử isolation forest hay autoencoder luôn.
Nên kìm lại. Thứ khách cần trong tháng đầu là một quy tắc mà kỹ sư của họ hiểu được, kiểm tra được và tự chỉnh được khi bạn không có mặt. Baseline thống kê đáp ứng đủ ba điều đó. Nó còn là thước đo để sau này bạn chứng minh model phức tạp hơn thật sự tốt hơn.
Với một FDE, đây là kỹ năng rất thực tế. Phần lớn dự án IoT, giám sát hạ tầng hay chất lượng dữ liệu đều bắt đầu bằng câu hỏi “cái này có bình thường không?”. Ai trả lời được câu đó bằng mười dòng code và một ngưỡng giải thích được sẽ được khách tin sớm hơn.
Vì sao trung bình và độ lệch chuẩn đánh lừa bạn?
Grafana Labs, khi xây hệ thống phát hiện bất thường trên Prometheus, kể rằng họ bắt đầu bằng đúng công thức mà gần như ai cũng dùng đầu tiên: một dải trung bình cộng/trừ vài lần độ lệch chuẩn, tức là biến thể của Z-score. Công thức này ổn khi dữ liệu nhiều và sạch. Dữ liệu cảm biến của khách thì hiếm khi được như vậy.
Cuốn handbook thống kê của NIST cảnh báo rằng Z-score thông thường có thể gây hiểu nhầm, đặc biệt với mẫu nhỏ, vì giá trị Z lớn nhất có thể đạt được bị giới hạn bởi kích thước mẫu.
Lý do là giá trị bất thường làm phình cả trung bình lẫn độ lệch chuẩn, nên nó tự che mình đi. Thay vào đó, NIST dẫn khuyến nghị của Iglewicz và Hoaglin: dùng modified Z-score, tính bằng median và MAD (median của các độ lệch tuyệt đối so với median).
Công thức là M = 0,6745 × (x − median) / MAD. Iglewicz và Hoaglin khuyến nghị gắn nhãn “có thể bất thường” cho mọi điểm có |M| lớn hơn 3,5.
Làm bằng tay với mười giá trị đo
Giả sử một ổ trục báo mười giá trị nhiệt độ (°C): 61, 62, 60, 63, 61, 62, 61, 60, 62, 85. Ai nhìn cũng thấy 85 có vấn đề. Câu hỏi là công thức có thấy giống vậy không.
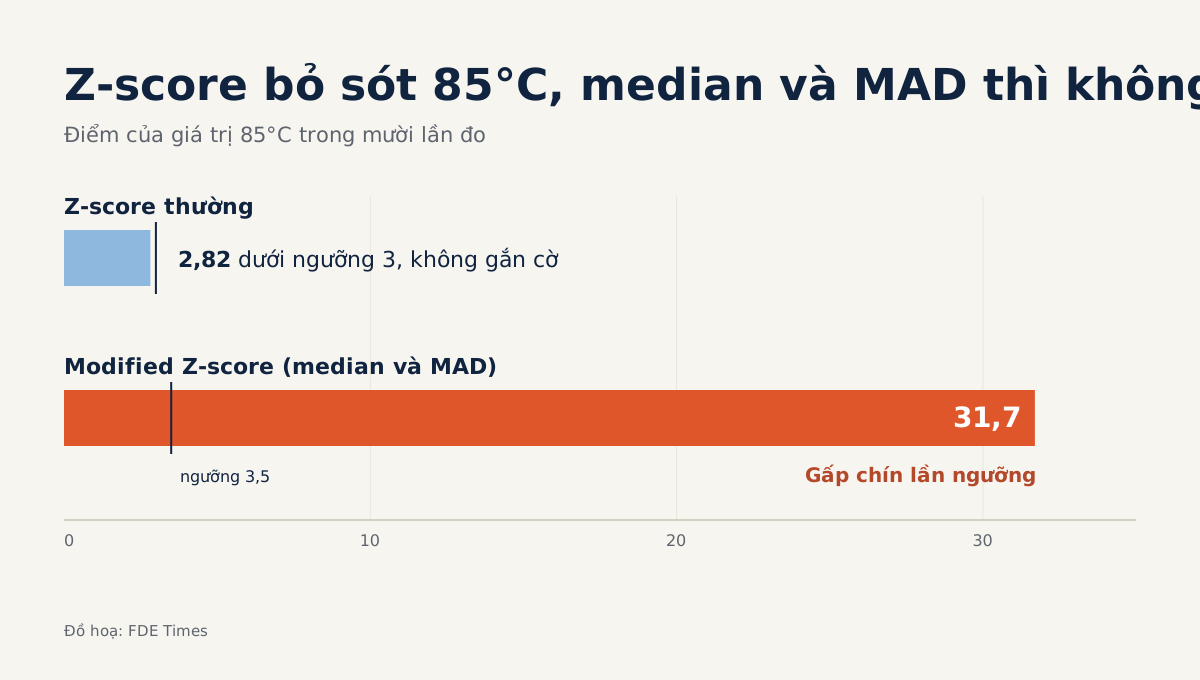
Trước hết thử Z-score thường. Tổng là 637 nên trung bình bằng 63,7. Độ lệch chuẩn mẫu khoảng 7,54, vậy Z của giá trị 85 là 21,3 / 7,54 ≈ 2,82. Với ngưỡng quen thuộc là 3, điểm này lọt qua. Nó cũng không thể nào vượt 3 được: với 10 điểm, Z lớn nhất chỉ khoảng 2,85, đúng như giới hạn NIST nói tới.
Giờ thử median và MAD. Sắp xếp lại ta được 60, 60, 61, 61, 61, 62, 62, 62, 63, 85, nên median là 61,5. Các độ lệch tuyệt đối gồm sáu giá trị 0,5, ba giá trị 1,5 và một giá trị 23,5, nên MAD bằng 0,5.
Giá trị 85 có M = 0,6745 × 23,5 / 0,5 ≈ 31,7, cao gấp chín lần ngưỡng 3,5. Giá trị 63 có M ≈ 2,02 nên không bị gắn cờ, và đúng là không nên.
Khi khách hỏi vì sao chọn median, chỉ cần một ý: một điểm bất thường không kéo được median đi đâu, cũng không làm MAD phình ra, nên nó không thể tự che mình như với trung bình và độ lệch chuẩn.
Từ phép tính tay tới baseline chạy được trong production
Một phép tính trên mười điểm thì chưa phải hệ thống. Khi chạy liên tục, bạn sẽ gặp bốn vấn đề. Ba vấn đề đầu được OneUptime mô tả trong bài viết về ngưỡng động, còn vấn đề thứ tư là thứ Grafana phải xử lý riêng khi dựng baseline cho Prometheus.
Vấn đề đầu tiên: sự cố lọt vào chính baseline của nó. OneUptime đề xuất lùi cửa sổ baseline một giờ, vì giờ gần nhất là khoảng thời gian dễ chứa sự cố đang diễn ra nhất.
Với cửa sổ bảy ngày, vài chục phút nóng lên khó kéo median đi xa. Nhưng nếu bạn rút cửa sổ xuống vài giờ để phản ứng nhanh hơn, dữ liệu của sự cố sẽ chiếm phần lớn cửa sổ và có thể đẩy median lên theo, khiến cờ bật muộn hoặc không bật.
Vấn đề thứ hai là khởi động lạnh. Cũng nguồn đó nhắc rằng một host mới có một giờ dữ liệu thì chưa thể có baseline bảy ngày đáng tin. Cảm biến vừa lắp hay vừa thay cũng vậy, nên hãy đặt số mẫu tối thiểu trước khi tin vào baseline.
Vấn đề thứ ba nối tiếp từ đó: thiết bị chưa đủ mẫu thì lấy gì để cảnh báo? OneUptime khuyên giữ một ngưỡng tĩnh dự phòng cho những tài nguyên chưa có lịch sử baseline. Ở nhà máy, ứng viên tự nhiên là ngưỡng nhiệt tối đa trong datasheet của nhà sản xuất.
Vấn đề thứ tư là tính mùa vụ. Grafana cho biết đó là tình huống cuối cùng họ phải xử lý riêng, vì một dải trượt đơn thuần không đủ.
Họ chọn cửa sổ một giờ sau khi thử nghiệm thấy đây là điểm cân bằng cho phát hiện bất thường ngắn hạn. Để làm mượt dải, họ dùng 26 giờ thay vì 24 quen thuộc, để người dùng có thêm khoảng dư.
Ở nhà máy, mùa vụ thường đi theo ca làm việc. Máy bơm chạy tải nặng ca ngày rồi nghỉ ca đêm, nên cách đơn giản là tính baseline riêng cho từng khung giờ trong ngày. Hỏi trưởng ca lịch sản xuất trước khi nhìn dữ liệu sẽ tiết kiệm cho bạn cả tuần.
import pandas as pd

def flag_anomalies(df, window="7D", offset="1h",
                   min_points=500, static_max=90.0, cutoff=3.5):
    s = df.set_index("ts")["temp_c"].sort_index()
    hist = s.shift(freq=offset)  # baseline does not see the latest hour
    med = hist.rolling(window, min_periods=min_points).median()
    mad = (hist - med).abs().rolling(window, min_periods=min_points).median()
    med = med.reindex(s.index, method="ffill")
    mad = mad.reindex(s.index, method="ffill")
    m = 0.6745 * (s - med) / mad.where(mad > 0)
    has_baseline = med.notna() & mad.gt(0)
    flag = (m.abs() > cutoff) & has_baseline
    fallback = (~has_baseline) & (s > static_max)  # cold start
    return pd.DataFrame({"temp_c": s, "m": m, "flag": flag | fallback})
MAD tính theo cửa sổ trượt ở đây chỉ là xấp xỉ, nhưng với baseline thì đủ dùng. Lưu ý dòng mad > 0: cảm biến làm tròn tới nguyên độ thường cho MAD bằng 0 trong những giờ máy đứng yên, và nếu chia cho 0 thì cả buổi sáng sẽ bị gắn cờ.
Cờ bật rồi, có nên gọi khách không?
Grafana nói thẳng rằng bất thường tự nó chưa đủ mạnh để cho thấy có gì đó hỏng. Một ổ trục lên 85°C có thể do vòng bi sắp hỏng, nhưng cũng có thể do vừa chạy rửa đường ống theo lịch.
Vì vậy cờ bất thường chỉ là đầu vào, còn cảnh báo cần thêm ngữ cảnh: máy có đang chạy không, cảm biến bên cạnh có cùng tăng không, và cờ có kéo dài quá vài chu kỳ không.
Trong cuộc họp với khách, hãy nói “hệ thống thấy một điểm lệch xa mức bình thường” thay vì “hệ thống phát hiện lỗi”. Nghe thì khác biệt nhỏ, nhưng nó quyết định khách có tắt kênh cảnh báo của bạn sau tuần thứ hai hay không.
Những lỗi hay gặp nhất
Lỗi phổ biến nhất là dùng trung bình và độ lệch chuẩn trên ít điểm, rồi kết luận “dữ liệu không có bất thường”. Lỗi thứ hai là để cửa sổ baseline chạm tới thời điểm hiện tại, khiến sự cố kéo lệch chính baseline của nó. Tiếp theo là quên khởi động lạnh, nên mỗi lần khách thay cảm biến là một tràng cảnh báo giả.
Nhóm lỗi cuối nằm ở con người. Có người bỏ qua lịch ca nên gắn cờ mọi lần máy khởi động lúc 6 giờ sáng. Có người lại đẩy thẳng từng cờ thành tin nhắn cho khách. Cả hai cách đều làm mất niềm tin nhanh hơn bất kỳ model tệ nào.
Biến kỹ năng này thành lợi thế khi đi phỏng vấn
Khi đọc mô tả công việc FDE, hãy để ý các cụm như “industrial data”, “observability”, “time series” hay “IoT”. Đó là những vai trò mà kỹ năng dựng baseline có đất dùng, nên đáng chuẩn bị sẵn một ví dụ cụ thể để kể khi phỏng vấn.
Trong CV, đừng viết “xây model phát hiện bất thường”. Hãy ghi rõ bạn chọn ngưỡng nào, tại sao, xử lý khởi động lạnh và mùa vụ ra sao, và đo số cảnh báo giả trước và sau như thế nào.
Model học máy vẫn có chỗ của nó, nhưng chỉ nên dùng sau khi baseline đã chạy và bạn có số liệu để so. Nếu không vượt được một median và một MAD thì model đó chưa xứng để đưa vào nhà máy của khách.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!