Model đổi hành vi khi code của bạn đứng yên: cách phát hiện trước khách hàng
Git log trống trơn không chứng minh được gì khi chất lượng đầu ra có thể tụt vì những thứ nằm ngoài repo của bạn.

Tóm tắt nhanh
- Ghim phiên bản là việc cần làm đầu tiên, nhưng không chặn được lỗi hạ tầng phía nhà cung cấp hay ngày model bị ngừng.
- Đo mức dao động bình thường cho cả tổng lẫn từng nhóm dữ liệu rồi mới đặt ngưỡng, vì con số tổng có thể che một nhóm đang hỏng.
- Eval của nhà cung cấp không thay được eval của bạn: chạy canary đều đặn trên đúng hệ thống production.
Thử hình dung sáng thứ Ba, một khách hàng logistics nhắn: “Tuần này hệ thống đọc hóa đơn sai nhiều hơn hẳn.” Bạn mở git log. Ba tuần không có commit nào, prompt không đổi, schema không đổi.
Lúc đó bạn đã chậm một nhịp: khách biết trước bạn, còn bạn không có con số nào để trả lời.
Kỹ năng cần rèn gồm ba việc nối nhau: ghim phiên bản, đo độ lệch, chạy lại eval. Làm đúng thì chính bạn là người nhắn cho khách trước, kèm theo con số.
Code đứng yên, hệ thống vẫn có thể đổi
Bằng chứng đã có từ lâu. Khi so bản tháng 3 và tháng 6/2023 của GPT-3.5 và GPT-4, nhóm tác giả Chen, Zaharia và Zou kết luận hành vi của “cùng một” dịch vụ LLM có thể đổi đáng kể trong thời gian ngắn, và cần giám sát LLM liên tục.
Tài liệu của OpenAI nói thẳng hơn: đầu ra LLM vốn không tất định, và hành vi model đổi giữa các snapshot cũng như giữa các họ model. Nhưng không phải mọi lần tụt chất lượng đều do đổi model. Trong postmortem công bố tháng 9/2025, Anthropic xác nhận ba lỗi hạ tầng đã làm giảm chất lượng phản hồi của Claude một cách gián đoạn.
Vì thế, câu “nhà cung cấp đổi model” thường là giả thuyết, chưa phải chẩn đoán. Muốn kiểm chứng sớm, bạn cần canary.
Từ này vốn chỉ cách đưa một thay đổi tới nhóm nhỏ người dùng trước khi mở rộng ra toàn bộ hạ tầng; ở đây nó được mượn để gọi một bộ kiểm tra nhỏ chạy đều trong ngày, báo động từ sớm trước khi khách kịp thấy lỗi.
Tách ba trường hợp ra thì mới biết khi nào canary là đủ, khi nào cần việc khác:
| Chuyện xảy ra | Ghim phiên bản có đỡ không? | Cách phát hiện |
|---|---|---|
| Tên chung (alias) trỏ sang snapshot mới | Có, vì từ đó việc đổi model nằm trong tay bạn | Canary nếu chưa ghim; eval trên mọi thay đổi khi nâng bản đã ghim |
| Model sắp bị ngừng | Chỉ đến ngày model bị ngừng | Thông báo, kiểm kê usage, thử sớm bản thay thế |
| Lỗi hạ tầng phía nhà cung cấp | Không, vì hạ tầng quanh model vẫn có thể đổi | Canary chạy đều trên production |
Ghim phiên bản là bước đầu, không phải lá chắn
Trước hết, hãy phân biệt hai kiểu tên model. Trong tài liệu của Anthropic, snapshot là chính bản model cố định, còn alias như claude-sonnet-4-5 là tên tiện dụng trỏ tới snapshot có ngày mới nhất của phiên bản nhỏ đó.
Việc rẻ nhất vì thế là gọi model bằng tên snapshot cố định nếu nhà cung cấp có, và để tên đó ở đúng một file cấu hình. Nguyên tắc dễ nhớ: nếu một thay đổi hành vi sẽ buộc bạn phải điều tra, hãy ghim. Từ đó, mọi lần đổi model đều là một commit có người chịu trách nhiệm, thay vì một chuyện xảy ra ngoài tầm mắt.
Giới hạn này được chính Anthropic ghi rõ: mỗi ID giữ nguyên model bên dưới suốt vòng đời của nó, nhưng hạ tầng phục vụ quanh model vẫn có thể đổi theo thời gian. Hãng cũng xem hạ tầng là nguyên nhân khả dĩ nhất khi một ID ổn định bỗng cho kết quả khác thường.
Bản ghim cũng có hạn dùng. Anthropic cam kết báo trước ít nhất 60 ngày trước khi ngừng một model phát hành công khai, nên hãy thử ứng dụng với model thay thế từ sớm, trên đúng tác vụ của bạn.
60 ngày nghe thì dài, nhưng trong dự án thật không nhiều. Nếu khách chỉ cho phát hành mỗi 30 ngày, bạn có khoảng hai lượt, và lượt đầu nên dành cho việc tìm ra vấn đề chứ không phải sửa xong. Với nhà cung cấp khác, hãy đọc lại chính sách của họ thay vì giả định con số này.
Việc đầu tiên khi nhận thông báo là kiểm kê mức dùng theo API key và model. Thứ bạn tìm là job chạy đêm hoặc API key mà không ai trong đội còn nhớ.
Làm thử với 200 hóa đơn
Quay lại khách logistics. Lấy 200 hóa đơn thật, vì eval chỉ có ý nghĩa khi giống thứ khách gửi vào hằng ngày. Chia làm hai nhóm: 50 bản scan khó đọc và 150 bản PDF sạch. Mỗi ca chấm theo từng trường như mã số, ngày, tổng tiền, vì so khớp nguyên chuỗi sẽ báo sai liên tục với đầu ra không tất định.
Phần khó nhất là đáp án đúng, và bạn không nên tự chốt một mình. Hãy nhờ người đang đối soát hóa đơn bên khách xác nhận từng trường; nếu khách có hệ thống kế toán, điền sẵn từ đó để họ soát lại sẽ nhanh hơn. Ca nào hai người đọc khác nhau, để người phụ trách nghiệp vụ quyết rồi ghi lại quy tắc.
Trước khi đo độ lệch, phải biết điểm số dao động bình thường bao nhiêu, cho cả tổng lẫn từng nhóm. Chạy cả bộ ba lần trên cùng bản ghim, giả sử được 186, 188 và 190 ca đúng; trong đó scan được 45, 46, 47 và PDF sạch được 141, 142, 143.
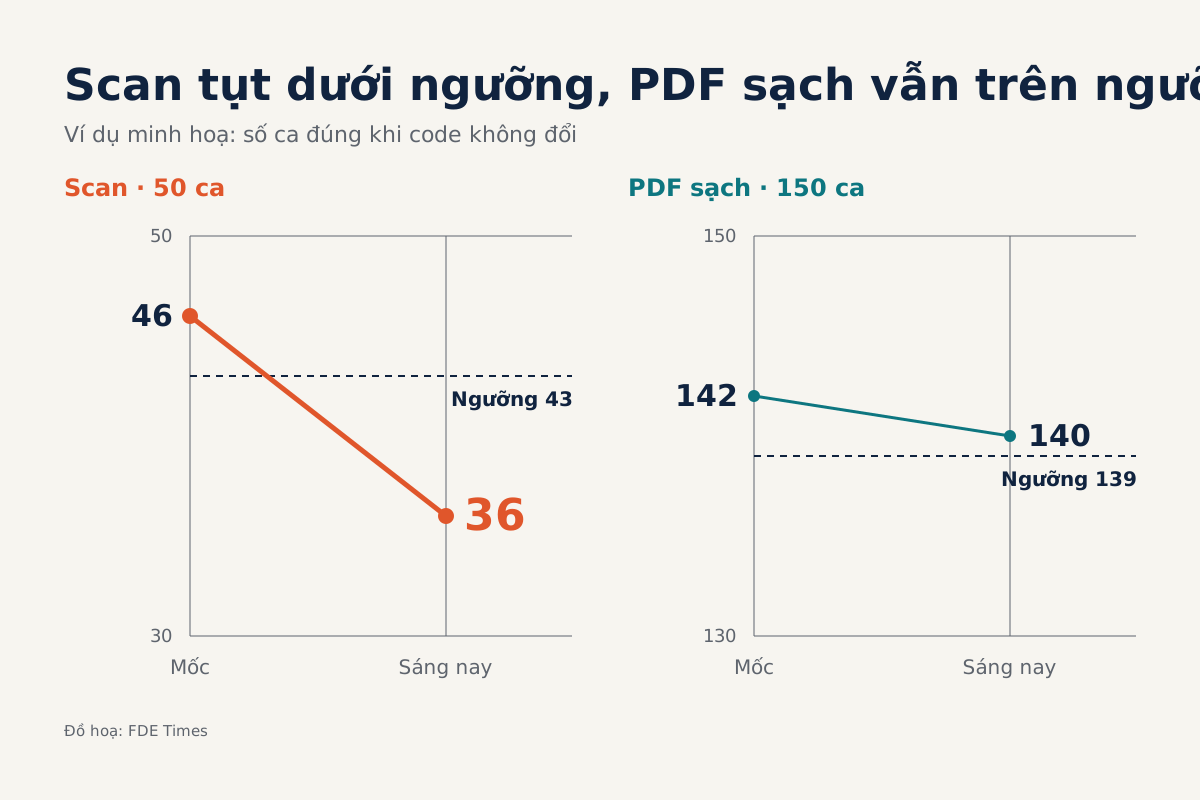
Lấy mức thấp nhất trừ đi mức dao động để ra ngưỡng. Tổng dao động 4 ca nên ngưỡng là 182; scan và PDF sạch cùng dao động 2 ca nên ngưỡng lần lượt là 43 và 139. Chỉ khi điểm xuống dưới ngưỡng mới có cảnh báo.
Giả sử sáng nay, canary báo động và bộ 200 ca tự chạy lại. Kết quả là 176 ca đúng, tức từ 94% xuống 88% so với mốc 188. Code không đổi, con số lại nằm ngoài mức dao động bình thường, nên đây là tín hiệu thật.
Xem riêng từng nhóm mới thấy chỗ hỏng: scan từ 46/50 xuống 36/50, dưới ngưỡng 43, còn PDF sạch từ 142/150 xuống 140/150, vẫn trên ngưỡng 139.
Giờ thử một kịch bản khó hơn: scan xuống 40/50, PDF sạch giữ nguyên 142. Tổng là 182, vừa bằng ngưỡng chứ chưa thấp hơn, và nếu chỉ nhìn tổng thì bạn sẽ không thấy gì. Đó là lý do mỗi nhóm cần ngưỡng riêng:
# Tên model, số ca và ngưỡng chỉ để minh họa
PINNED_MODEL = "vendor-model-2025-06-01"

BASE_RUNS = {
    "total": [186, 188, 190],
    "scan": [45, 46, 47],
    "pdf": [141, 142, 143],
}

def threshold(runs):
    return min(runs) - (max(runs) - min(runs))

def check(base_runs, today):
    return [name for name, runs in base_runs.items()
            if today[name] < threshold(runs)]

check(BASE_RUNS, {"total": 182, "scan": 40, "pdf": 142})  # ["scan"]
Với kịch bản này, check chỉ trả về nhóm scan, vì 40 thấp hơn 43, còn con số tổng chưa kích hoạt cảnh báo. Ba lần chạy chỉ cho ước lượng thô về mức dao động, nhất là với nhóm 50 ca, nên hãy chạy thêm nếu có thể, và chạy lại nhóm có cảnh báo để xác nhận trước khi báo cho ai.
Công thức này cũng không phải quy tắc chung. Hãy hỏi khách nhóm nào sai thì đau nhất, rồi đặt chặt hơn ở đó.
Bộ eval phải chạy trên production
Bộ eval chỉ nằm trong notebook thì không tự báo động được. Bài học đáng giá nhất trong postmortem của Anthropic là các eval của chính hãng đã không bắt được sự suy giảm mà người dùng báo cáo, và một biện pháp khắc phục là chạy eval liên tục trên hệ thống production thật.
Eval của nhà cung cấp không đo tác vụ của khách bạn, nên không thể thay cho eval của bạn. Lỗi lại xuất hiện gián đoạn, nên chạy một lần mỗi tuần rất dễ trượt.
Vậy hãy làm hai tầng. Tầng nhanh là canary khoảng 30 ca phủ đủ các nhóm, chạy nhiều lần trong ngày, qua đúng API key, gateway và prompt của production, với ngưỡng riêng đo từ chính bộ này, vì mẫu nhỏ dao động mạnh hơn.
Tầng đầy đủ là bộ 200 ca, tự chạy mỗi đêm và ngay khi canary cảnh báo, để xác nhận tín hiệu và chỉ ra nhóm nào bị ảnh hưởng. Nó cũng chạy trên mọi thay đổi như OpenAI khuyên, và giữ vai trò bộ kiểm thử hồi quy tự động trước khi đổi prompt hay model.
Khi có cảnh báo, mở từng ca hỏng trước khi nói với ai. Nếu cùng một bản ghim mà điểm tụt và code không đổi, hãy gửi nhà cung cấp các ca tái hiện được, đồng thời chuyển nhóm bị ảnh hưởng sang người duyệt nếu khách đồng ý.
Tin nhắn cho khách nên có số và có hành động: “Từ 9 giờ sáng nay, kiểm tra tự động cho thấy hóa đơn scan đúng 36/50, so với 46/50 trước đó; PDF sạch không bị ảnh hưởng. Đội triển khai đề xuất chuyển scan sang duyệt tay trong khi điều tra, và sẽ cập nhật lúc 14 giờ.”
Ba lỗi làm bạn mất thế đi trước khách hàng
Lỗi đầu tiên cần tránh là vội kết luận bản thân model đã đổi. Trong sự cố năm 2025, Anthropic quy nguyên nhân cho lỗi hạ tầng chứ không phải chủ ý đổi model, nên ai đoán “model bị đổi” lúc đó đã đoán sai dù lỗi đúng là nằm phía nhà cung cấp.
Dù nguyên nhân ở trường hợp của bạn là gì, khách vẫn cần ca tái hiện được chứ không cần một giả thuyết.
Lỗi thứ hai là dựng bộ eval từ ví dụ đẹp do đội mình tự nghĩ, rồi để nó đứng yên. Dữ liệu khách đổi theo thời gian, nên mỗi lần khách báo sai, hãy thêm ca đó vào bộ.
Lỗi thứ ba là để canary không có người phụ trách sau bàn giao. Cảnh báo không có người nhận thì cũng như không có, và khách lại là người phát hiện đầu tiên.
Phỏng vấn nên hỏi gì, CV nên ghi gì?
Khi đọc mô tả công việc FDE, hãy tìm những từ như regression eval, model upgrade, monitoring trên production. Dù mô tả có nhắc đến chúng hay không, hãy hỏi ở vòng phỏng vấn: lần gần nhất họ đổi model diễn ra thế nào, và ai là người phát hiện lỗi đầu tiên.
Trên CV, nên viết một dòng có số cụ thể thay vì chỉ liệt kê công cụ. Ví dụ, nếu đúng với bạn: “Dựng bộ eval 200 ca từ dữ liệu khách hàng, kèm canary trên production, phát hiện hồi quy trước khi khách báo”.
Bài tập tuần này: lấy 30 đầu vào thật từ một dự án của bạn, tự viết đáp án, chạy ba lần trên cùng một snapshot và ghi lại mức dao động. Sau đó chạy với một snapshot khác rồi xem chênh lệch có vượt mức đó không. Lần tới có người hỏi “model có đổi không”, bạn sẽ trả lời bằng một con số thay vì một cảm giác.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Model IDs and versioning
- What Is the Difference Between a Model Alias and a Versioned Model ID? · 2026-08-10
- How is ChatGPT's behavior changing over time? · 2023-07-18
- A postmortem of three recent issues · 2025-09-17
- Model optimization – OpenAI API docs
- Evaluation best practices – OpenAI API docs
- Model deprecations
- Canary Release · 2014-06-25