Hai chuyên gia chấm khác nhau: đo Cohen's kappa trước khi tin bộ eval
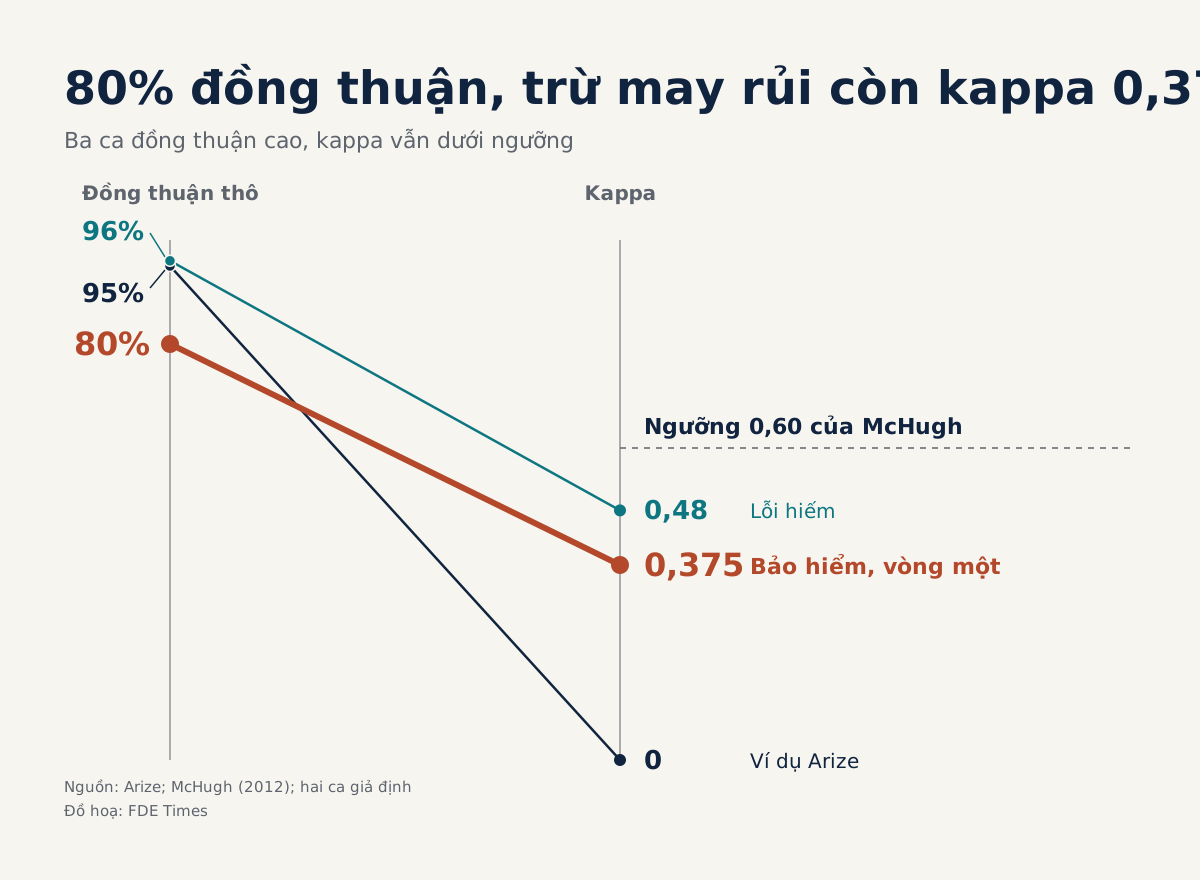
Hai người đồng ý với nhau 80% nghe khá ổn, cho đến khi bạn trừ đi phần trùng nhau do may rủi và chỉ còn kappa 0,375.

Tóm tắt nhanh
- Tỉ lệ đồng thuận thô bỏ qua may rủi: người chấm pass tất cả vẫn đạt 95% mà không bắt được lỗi nào.
- Kappa thấp thường là tín hiệu để sửa rubric, không phải để tìm xem chuyên gia nào đúng.
- Với lỗi hiếm, kappa có thể đổi mạnh chỉ vì vài mẫu, nên luôn đọc kèm bảng bất đồng.
Tuần thứ ba ở khách hàng, bạn có 100 câu trả lời của chatbot đã gắn nhãn pass hoặc fail, và bộ chấm tự động đang bám khá sát những nhãn ấy. Rồi bạn nhờ một chuyên gia thứ hai chấm lại đúng 100 câu đó. Có 20 câu ra kết quả ngược lại.
Phản xạ đầu tiên là hỏi ai đúng. Câu nên hỏi trước là hai người này có đang chấm cùng một thứ không. Nếu không, mọi điểm số của bộ eval chỉ phản ánh cách nghĩ của người đã gắn nhãn, trong khi bạn sắp đem chúng đi báo cáo như thước đo chất lượng.
Cohen’s kappa trả lời câu hỏi ấy trong vài phút, với vài dòng code. Với một FDE, đó là phép kiểm tra rẻ nhất trước khi xây cả hệ thống đo lường trên một bộ đáp án chưa ai kiểm tra lại.
Vì sao 80% đồng thuận chưa nói lên nhiều?
Tỉ lệ đồng thuận thô rất dễ tính, nhưng theo McHugh trong bài tổng quan năm 2012, điểm yếu then chốt của nó là bỏ qua khả năng người chấm đã đoán. Khi dữ liệu lệch, điểm yếu ấy trở nên nghiêm trọng.
Arize đưa ra một ví dụ gọn: 100 mẫu có 5 lỗi, một người phát hiện đủ 5 lỗi, người kia gắn pass cho tất cả. Họ vẫn đồng ý ở 95% số mẫu, dù người thứ hai chưa bắt được lỗi nào. Tính kappa cho đúng trường hợp này, kết quả là 0.
Công thức chỉ có hai đại lượng: κ = (po − pe) / (1 − pe). Trong đó po là tỉ lệ đồng thuận quan sát được, pe là tỉ lệ đồng thuận kỳ vọng do may rủi, ước lượng từ tần suất dùng từng nhãn của mỗi người. Tử số là phần vượt mức may rủi; mẫu số là phần tối đa có thể vượt.
Một ca làm từ đầu đến cuối
Thử hình dung bạn đang đánh giá chatbot giải đáp bồi thường của một công ty bảo hiểm. Trưởng nhóm bồi thường (A) và chuyên viên tuân thủ (B) chấm độc lập cùng 100 câu trả lời, với rubric một dòng: “Câu trả lời có đúng không?”. Kết quả như sau.
| B: pass | B: fail | |
|---|---|---|
| A: pass | 70 | 10 |
| A: fail | 10 | 10 |
Hai người giống nhau ở 70 + 10 = 80 câu, nên po = 0,80. Mỗi người đều gắn pass 80% và fail 20%, nên pe = 0,80 × 0,80 + 0,20 × 0,20 = 0,68. Nghĩa là hai người chấm độc lập với những tần suất này đã có thể trùng nhau 68% số câu.
Vậy κ = (0,80 − 0,68) / (1 − 0,68) = 0,12 / 0,32 = 0,375. Trừ phần trùng nhau do may rủi đi, mức đồng thuận 80% nghe rất ổn chỉ còn lại kappa 0,375.
Hàm dưới đây tính được cả trường hợp nhiều nhãn, vì theo Arize, Cohen’s kappa không chỉ dành cho pass/fail mà dùng được cho hai người chấm với nhiều lớp.
from collections import Counter

def cohen_kappa(a, b):
    n = len(a)
    po = sum(x == y for x, y in zip(a, b)) / n
    count_a, count_b = Counter(a), Counter(b)
    labels = set(a) | set(b)
    pe = sum(count_a[k] * count_b[k] for k in labels) / n**2
    return po, pe, (po - pe) / (1 - pe)

a = ["pass"] * 70 + ["pass"] * 10 + ["fail"] * 10 + ["fail"] * 10
b = ["pass"] * 70 + ["fail"] * 10 + ["pass"] * 10 + ["fail"] * 10
print(cohen_kappa(a, b))  # po≈0.80, pe≈0.68, kappa≈0.375
Nếu cả hai gắn đúng một nhãn cho mọi mẫu, pe bằng 1 và hàm sẽ chia cho 0. Khi đó vấn đề nằm ở mẫu: nó chưa đủ đa dạng để đo bất cứ điều gì.
Con số 0,375 có đủ tốt không?
Không có một ngưỡng chung cho mọi nơi. Thang của Landis và Koch, xếp 0,61–0,80 vào mức đáng kể và 0,81–1 vào mức gần như hoàn hảo, được trích dẫn rộng rãi nhưng không phải ai cũng chấp nhận. Fleiss chia khác: trên 0,75 là xuất sắc, 0,40–0,75 là khá đến tốt, dưới 0,40 là kém.
McHugh đi xa hơn và phản đối thang gốc của Cohen, vốn chỉ coi κ ≤ 0 là không đồng thuận, vì quá dễ dãi với nghiên cứu y tế. Bà xem mọi kappa dưới 0,60 là chưa đủ, và kết quả dựng trên những nhãn như vậy không đáng tin nhiều.
Lời khuyên thực tế: chốt ngưỡng với khách trước khi tính, ghi rõ theo thang nào. Với chatbot liên quan đến tiền bồi thường, 0,60 là mức sàn hợp lý để bắt đầu. Con số 0,375 dưới cả ngưỡng của Fleiss lẫn McHugh, nên bộ nhãn này chưa nên làm đáp án.
Sửa rubric, đừng đi tìm người thắng
Giờ mới đến phần có giá trị nhất: ngồi cùng hai chuyên gia, đọc 20 câu bất đồng. Giả sử bạn thấy một mẫu lặp lại: câu trả lời nêu đúng mức bồi thường nhưng thiếu điều kiện loại trừ. Người làm bồi thường cho pass vì thông tin đúng, người làm tuân thủ cho fail vì khách có thể hiểu sai.
Không ai sai cả. Rubric đã không nói điều gì được tính là “đúng”. Bạn viết thêm một quy tắc kèm ví dụ: thiếu điều kiện loại trừ có ảnh hưởng đến quyền lợi khách hàng thì là fail. Bản thân quy tắc này đã là một phát hiện về sản phẩm mà khách sẽ muốn nghe.
Giả sử vòng hai, trên 100 câu mới, cho kết quả 72 cùng pass, 18 cùng fail, 6 câu A pass còn B fail, 4 câu ngược lại. Lúc này po = 0,90 và pe = 0,78 × 0,76 + 0,22 × 0,24 = 0,6456, nên κ ≈ 0,72.
Con số này qua ngưỡng 0,60 của McHugh, thuộc mức đáng kể của Landis–Koch, nhưng vẫn chỉ “khá đến tốt” theo Fleiss. Một kappa, ba cách gọi: đó là lý do báo cáo nên ghi con số trước, rồi mới đến tính từ.
Khi lỗi hiếm, đừng đọc kappa một mình
Kappa phụ thuộc vào prevalence (các nhãn có xuất hiện đều không) và bias (hai người có dùng nhãn với tần suất khác nhau không). Với nhóm hiếm, nó có xu hướng đánh giá thấp mức đồng thuận thực. Khi chatbot đã chạy ổn và fail chỉ còn lác đác, bạn sẽ gặp đúng tình huống này.
Xét 100 câu: 94 cùng pass, 2 cùng fail, mỗi chiều bất đồng 2 câu. Đồng thuận thô là 96%, pe = 0,9232, và κ ≈ 0,48. Chỉ cần hai câu bất đồng chuyển thành đồng thuận, thành 95 cùng pass và 3 cùng fail, κ nhảy lên khoảng 0,74 trong khi pe không đổi.
Hai câu không đủ để kết luận rubric hỏng hay đã ổn. Khi gặp ca này, hãy mở bảng bất đồng rồi lọc từ log thêm những câu nghi là fail để hai người chấm mù.
Mẫu lọc như vậy có tỉ lệ fail cao hơn mẫu gốc, mà kappa lại phụ thuộc prevalence, nên hai con số không so trực tiếp được. Hãy báo cáo cả hai, kèm tỉ lệ fail của từng mẫu.
Có nhãn sạch rồi mới đến LLM judge
Mức đồng thuận giữa người với người cũng là mốc để xét bộ chấm tự động. Arize khuyên so LLM judge với từng chuyên gia theo từng cặp, và coi con số giữa hai người là mốc tham chiếu chứ không phải mức trần.
Đừng gộp nhãn của hai người thành một trước khi so. Giả sử judge đạt kappa 0,70 với A nhưng chỉ 0,40 với B: bạn biết ngay nó đang nghiêng về cách nghĩ của ai, điều mà một nhãn gộp sẽ che mất.
Quy trình mang đến khách hàng
-
Rút mẫu. Lấy một mẫu ngẫu nhiên từ log thật, thay vì những ca mà khách tự chọn để khoe.
-
Chấm độc lập. Mời hai người thực sự sẽ phải chịu trách nhiệm về chất lượng, đưa họ cùng một rubric và yêu cầu chấm riêng, không trao đổi.
-
Tính và đọc. Tính kappa, xem tần suất dùng nhãn của từng người, rồi đọc từng ca bất đồng cùng họ.
-
Sửa rubric. Biến mỗi nhóm bất đồng thành một quy tắc kèm ví dụ.
-
Chấm mẫu mới. Đừng dùng lại mẫu cũ, vì chấm lại chỉ đo xem họ nhớ đáp án đến đâu.
-
Chốt và ghi lại. Khi kappa qua ngưỡng đã thống nhất, mới dùng bộ nhãn làm đáp án và kiểm định judge.
Ghi kèm số mẫu, tỉ lệ fail, phiên bản rubric, để người tiếp quản sau này biết con số đó đến từ đâu.
Những lỗi khiến con số vô nghĩa
-
Để chuyên gia bàn nhau lúc chấm. Kappa khi đó tăng, nhưng nó đo khả năng thuyết phục của người nói nhiều hơn, chứ không đo độ rõ của rubric.
-
Chỉ báo cáo phần trăm đồng thuận trên dữ liệu lệch. Ví dụ 95% ở trên cho thấy con số ấy che được cả một người không bắt lỗi nào.
-
Xem thang phân loại như luật. Một con số rơi đúng vào ô đẹp chưa đủ để kết luận “đạt”.
-
Loại người chấm “lệch”. Người ấy có thể đang giữ một tiêu chí mà khách cần.
Kể lại ca này thế nào khi đi phỏng vấn?
Khi ứng tuyển FDE, hãy cho thấy bạn dám nghi ngờ chính thước đo của mình. Nếu mô tả công việc nhắc đến evals hay bộ dữ liệu đáp án, hãy chuẩn bị một ca cụ thể cho buổi phỏng vấn: nhãn lệch ở đâu, bạn đã phát hiện thế nào, rubric đổi ra sao.
Trên CV, một dòng kiểu “đưa kappa giữa hai chuyên gia từ X lên Y sau hai vòng sửa rubric, trước khi triển khai LLM judge” nói được nhiều hơn cả đoạn liệt kê công cụ. Nó cho thấy bạn biết đo và biết làm việc với người nắm nghiệp vụ.
Bài tập tuần này: lấy 50 mẫu từ một bộ eval bạn đang tin, nhờ một đồng nghiệp chấm mù theo đúng rubric hiện có, rồi so với nhãn cũ. Con số thu được có thể làm bạn khó chịu, nhưng thà biết sớm từ một đồng nghiệp còn hơn nghe từ khách hàng trong buổi nghiệm thu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!