FDE trong bảo hiểm: vẽ quy trình trước khi đưa AI vào hồ sơ
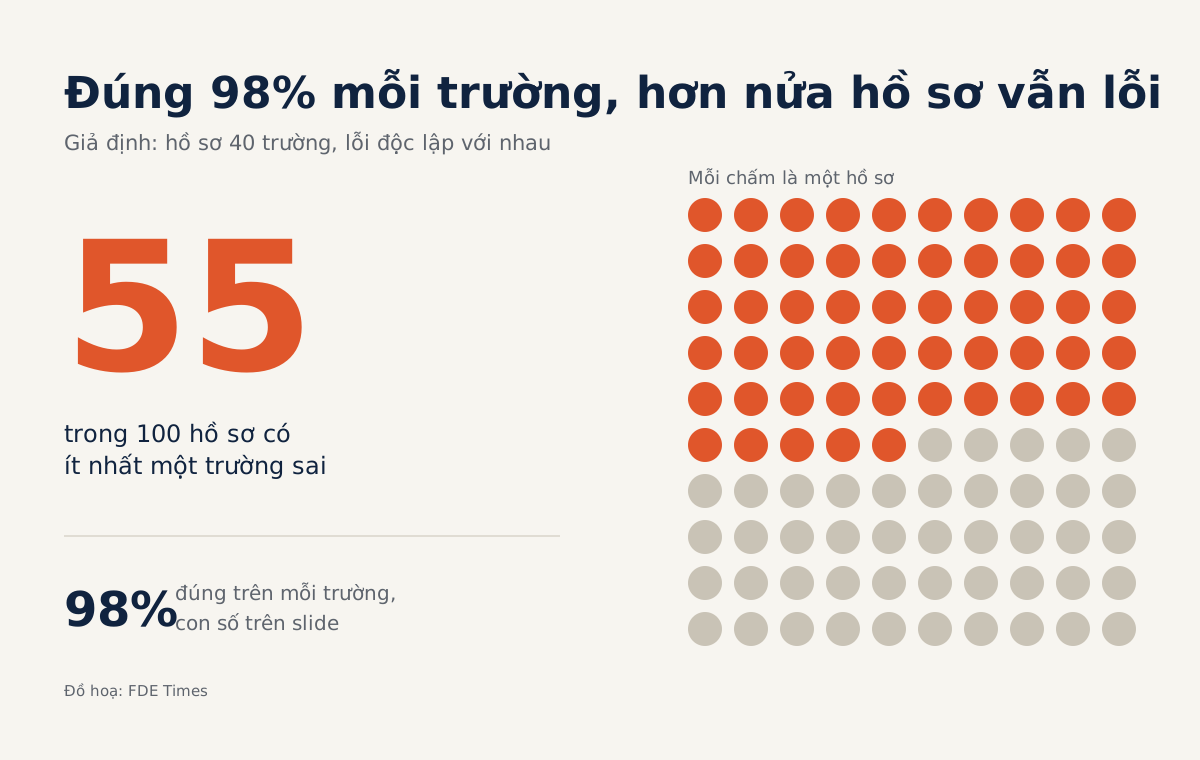
Với hồ sơ 40 trường và lỗi độc lập, đúng 98% trên mỗi trường vẫn khiến hơn nửa số hồ sơ mang lỗi, nên câu hỏi đầu tiên ở khách hàng không nằm ở model.

Tóm tắt nhanh
- Rào cản lớn nhất ở submission intake là tích hợp vào quy trình hiện có, không phải model.
- Hãy đo lỗi theo hồ sơ và lỗi lọt qua cổng kiểm tra, không chỉ đo độ chính xác từng trường.
- Con người giữ quyết định cuối, nên bước định tuyến phải nói rõ vì sao một hồ sơ cần người xem.
Thử hình dung tuần đầu của bạn tại một công ty bảo hiểm thương mại. Bản demo đọc form ACORD rất gọn, cả phòng gật đầu. Rồi một underwriter mở loss run của một nhà cung cấp chưa ai thử và hỏi: “Còn cái này thì sao?”
Phản xạ của nhiều engineer là quay về chỉnh prompt. Nhưng một phân tích trên Insurance Thought Leadership về AI trong tiếp nhận hồ sơ thương mại nói thẳng rằng rào cản lớn nhất, bỏ xa các rào cản khác, là tích hợp AI vào quy trình tiếp nhận hiện có.
Vì thế, việc đáng giá nhất của FDE trong ngành này lại nằm trước dòng code đầu tiên: hiểu hồ sơ đi qua tay ai, dừng ở đâu, ai chịu trách nhiệm ký. Nắm được điều đó, bạn sẽ biết nên tự động hóa bước nào và phải chặn ở bước nào.
Underwriting và bồi thường hỏi hai câu khác nhau
Underwriting nhìn về phía trước: rủi ro này có nên nhận không, và nhận thế nào. Bồi thường nhìn về phía sau: tổn thất đã xảy ra, có chi trả không. Dữ liệu vào, người quyết định và điểm tự động hóa đầu tiên của hai luồng vì thế khác nhau.
Underwriting (submission)
- Bắt đầu khi hồ sơ gửi đến kèm tệp đính kèm
- Tài liệu: ACORD, loss run, bảng kê giá trị tài sản
- Nên tự động trước: phân loại tệp và trích xuất dữ liệu
- Điểm chặn: underwriter duyệt đầu ra của AI
Bồi thường (claims)
- Bắt đầu từ thông báo tổn thất ban đầu (FNOL)
- Kiểm tra: quy tắc nghiệp vụ và dấu hiệu gian lận
- Nên tự động trước: các bước duyệt cấp một có quy tắc rõ
- Điểm chặn: ca không đạt chuyển sang thẩm định thủ công
Bên bồi thường, QBurst mô tả một điểm bắt đầu khá rõ: người duyệt cấp một thường làm theo quy tắc đã định sẵn, nên phần việc này hợp với tự động hóa dựa trên luật. Yêu cầu đạt quy tắc và qua kiểm tra gian lận có thể đi thẳng tới bước xác định chi trả; phần còn lại sang thẩm định có người can thiệp.
Prosper, một vendor, đi xa hơn khi nói AI có thể duyệt hoặc từ chối hồ sơ đơn giản với ít can thiệp của con người, để adjuster dành thời gian cho ca phức tạp. Đừng gộp hai cách này làm một. Trước khi để máy tự từ chối một yêu cầu bồi thường, hãy hỏi khách hàng ai sẽ đứng ra giải thích quyết định đó.
Theo một hồ sơ từ email đến hệ thống
Bây giờ hãy đi hết một ví dụ giả định bên underwriting. Một broker gửi email kèm ba tệp: ACORD, loss run và bảng kê giá trị tài sản. Đây đúng là nhóm tài liệu mà phân tích nói trên coi là điểm khởi đầu tốt cho tự động hóa.
Nghe đơn giản, cho tới khi bạn gặp loss run, vì loại báo cáo lịch sử tổn thất này khác nhau theo từng nhà cung cấp.
Giả sử ACORD khai ba tổn thất, còn loss run có bốn dòng. Model có thể đọc đúng cả hai tài liệu, không một ký tự sai, mà hồ sơ vẫn có vấn đề. Độ chính xác trích xuất không bao giờ phát hiện được mâu thuẫn kiểu này, chỉ có bước đối chiếu mới làm được.
Thêm một phép tính để mang vào buổi họp. Giả sử mỗi hồ sơ có 40 trường, mỗi trường đúng 98%, và lỗi giữa các trường độc lập với nhau. Xác suất cả hồ sơ sạch là 0,98 mũ 40, khoảng 44,6%: cứ 100 hồ sơ thì chừng 55 hồ sơ có ít nhất một trường sai.
Con số 98% trên slide và con số 55 trong hàng đợi của underwriter mô tả cùng một hệ thống. Vì vậy, thứ cần viết tiếp theo là bước định tuyến chứ không phải thêm một vòng tinh chỉnh model:
def route(sub):
    reasons = []
    if sub.loss_run_provider not in KNOWN_TEMPLATES:
        reasons.append("loss run từ mẫu chưa gặp")
    if sub.acord_loss_count != len(sub.loss_run_rows):
        reasons.append("số tổn thất giữa ACORD và loss run lệch nhau")
    missing = [f for f in REQUIRED_FIELDS if not sub.get(f)]
    if missing:
        reasons.append(f"thiếu trường: {missing}")
    if sub.min_confidence < CONFIDENCE_FLOOR:
        reasons.append("độ tin cậy dưới ngưỡng")
    queue = "exception_review" if reasons else "standard_review"
    return queue, reasons
Hãy để ý hai chi tiết. Cả hai nhánh đều kết thúc ở chỗ có người xem, vì không có đường nào để máy tự chốt.
Thiết kế này bám theo khuyến nghị của phân tích nói trên: chuyên gia con người tiếp tục giữ phán quyết cuối, còn ca độ tin cậy thấp phải chuyển cho người. FurtherAI thì coi giao diện để underwriter duyệt đầu ra là dấu hiệu của công cụ tốt.
Chi tiết thứ hai là reasons. Underwriter nhận một hồ sơ kèm câu “số tổn thất lệch nhau” sẽ biết phải mở trang nào, còn một điểm tin cậy 0,71 không nói cho họ biết gì.
Cuối cùng là đo lường. Quay lại 100 hồ sơ ở phép tính trên, trong đó chừng 55 hồ sơ có trường sai, và giả sử bước định tuyến đưa 60 hồ sơ vào hàng ngoại lệ, 40 vào hàng thường.
Bạn lấy cả 40 hồ sơ này đối chiếu thủ công và thấy 4 hồ sơ sai mà không bị gắn cờ. Đó là lỗi lọt: các hồ sơ này vẫn tới tay người trong standard_review, nhưng underwriter duyệt chúng mà không nhận được cảnh báo nào.
Cùng 4 hồ sơ ấy cho ra hai tỉ lệ, và đừng lẫn chúng với nhau. Tính trên hàng thường, 4/40 là 10%: cứ 10 hồ sơ không gắn cờ thì có 1 hồ sơ sai. Tính trên số hồ sơ có lỗi, 4/55 là khoảng 7%: đó là phần hồ sơ sai mà bước định tuyến bỏ sót.
Đó là hai con số nên đặt trước khách hàng, kèm kích thước hàng ngoại lệ. Chúng khớp với yêu cầu mà phân tích nói trên đặt ra cho production: chứng minh AI chạy tin cậy trong quy trình thật, gồm cả ngoại lệ và dữ liệu thiếu hay mâu thuẫn, thay vì chỉ báo độ chính xác của model.
Làm gì trong tuần đầu ở khách hàng?
Bắt đầu bằng việc ngồi cạnh một underwriter hoặc một người xử lý bồi thường và xem họ làm năm hồ sơ thật, gồm cả một ca họ ghét nhất. Ghi lại từng lần họ chuyển màn hình, gọi người khác hay gửi email hỏi lại, vì quy trình thật nằm ở đó chứ không nằm trong tài liệu mô tả.
Tiếp theo, vẽ bản đồ một trang và đánh dấu ba loại bước: có quy tắc rõ, cần phán đoán, và phải có chữ ký của người. Những bước có quy tắc rõ là chỗ nên cân nhắc tự động hóa trước; những bước cần chữ ký là chỗ phải có người duyệt. Mang bản đồ về cho chính người bạn đã quan sát sửa lại.
Rồi xin một mẫu loss run theo từng nhà cung cấp, đếm số định dạng và xếp hạng theo khối lượng hồ sơ. Từ đó chọn một phần việc nhỏ để bắt đầu, ví dụ chỉ vài mẫu phổ biến nhất, và cho mọi thứ còn lại đi thẳng vào hàng ngoại lệ. Phạm vi hẹp nhưng chạy thật sẽ thuyết phục hơn phạm vi rộng chỉ chạy trong demo.
Sản phẩm và khu vực pháp lý thay đổi cả thiết kế
Cùng mang nhãn “AI cho underwriting”, hai dự án có thể chịu những yêu cầu rất khác nhau. Đạo luật AI của EU xếp AI đánh giá rủi ro và định giá bảo hiểm nhân thọ, sức khỏe cho cá nhân vào nhóm rủi ro cao, theo Annex III.
Trích xuất loss run cho một hồ sơ thương mại là bài toán khác, nhưng ranh giới đó nên để bộ phận pháp chế xác nhận.
Ở Mỹ, NAIC thông qua một model bulletin về AI ngày 4/12/2023, đặt ra các tiêu chuẩn dựa trên nguyên tắc cho những thực hành mà insurer dùng AI được kỳ vọng áp dụng, và dành cho từng bang tự thông qua.
Vì thế, câu nên hỏi ngay trong buổi đầu là: sản phẩm nào, khách hàng cá nhân hay doanh nghiệp, hoạt động ở những bang hay nước nào, đã áp dụng văn bản nào.
Lời khuyên về thiết kế, dù câu trả lời ra sao: hãy lưu từ đầu phiên bản model, lý do định tuyến, ai duyệt và duyệt lúc nào. Đây là thói quen kỹ thuật để phòng xa, vì thêm các trường này từ đầu thường nhẹ việc hơn là lần ngược lại khi có người hỏi tới một hồ sơ cũ.
Những cái bẫy nằm ngay sau bản demo
Năm sai lầm này đều dễ mắc, vì lúc mới mắc chúng trông giống như tiến độ:
- Coi demo là bằng chứng. Một bản demo bằng tài liệu đẹp chưa nói được gì về production.
- Báo cáo độ chính xác trung bình theo trường. Con số này che đi cả lỗi ở cấp hồ sơ lẫn các mẫu loss run hiếm mà model chưa từng gặp.
- Chỉ nói chuyện với người mua và ban lãnh đạo. Bạn cần ngồi với người xử lý hồ sơ hằng ngày.
- Không ai phụ trách hàng ngoại lệ. Hồ sơ khó chỉ đổi từ hộp thư này sang màn hình khác và không được xử lý nhanh hơn.
- Để dữ liệu chưa duyệt chảy vào hệ thống phía sau chỉ vì tích hợp đã sẵn sàng. Hãy giữ bước nạp dữ liệu ở sau bước duyệt, ít nhất cho tới khi số lỗi lọt đủ thấp để chính underwriter đồng ý nới lỏng.
Viết gì lên CV để chứng minh kỹ năng này?
Khi đọc JD, hãy tìm dấu hiệu công ty hiểu việc này: các từ như ACORD, loss run, FNOL, exception handling hay human-in-the-loop cho thấy họ đã đụng vào quy trình thật. Nếu JD chỉ nói về model và prompt, hãy hỏi trong phỏng vấn xem ai đang xử lý ngoại lệ ở khách hàng.
Trên CV, thay câu “xây pipeline trích xuất tài liệu” bằng một câu có đủ quy trình, cổng duyệt và số đo: bạn đã định tuyến những loại ngoại lệ nào, ai duyệt, tỉ lệ lỗi lọt đo ra sao. Kỹ năng này cũng chuyển được sang ngành khác có hồ sơ và người ký duyệt.
Bài tập cho tuần này
Tự tạo hai loss run giả từ hai nhà cung cấp tưởng tượng, đặt tên cột và định dạng ngày khác nhau, cộng thêm một ACORD giả cố tình khai lệch một tổn thất. Viết hàm route như trên, chạy trên 20 hồ sơ bạn tự sinh và cấy lỗi vào, rồi đếm bao nhiêu lỗi lọt qua.
Sau đó đưa danh sách reasons cho một người không phải engineer đọc và hỏi họ sẽ làm gì tiếp theo. Nếu họ không trả lời được, hàm của bạn mới chỉ biết hồ sơ có vấn đề, chưa giúp được ai xử lý nó, và đó là khoảng cách mà một FDE được trả công để lấp.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Making AI Work in Commercial Submission Intake · 2026-07-29
- From Basic Automation to AI Agents: Transforming Insurance Submission Processing (FurtherAI) · 2026-06-19
- Automating Insurance Claim Adjudication (QBurst)
- Claims Processing AI Agent Automation Guide (Prosper) · 2025-12-30
- NAIC Model Bulletin on Use of AI by Insurers (Sullivan & Cromwell) · 2023-12
- Annex III: High-Risk AI Systems Referred to in Article 6(2) (EU AI Act)