迁移到 MongoDB Atlas,别把表原样搬成集合
逐表复制很快,难的是按应用读取数据的方式重新设计数据。
要点速览
- 不要把每张表原样复制成一个集合,而要从应用如何读取数据出发
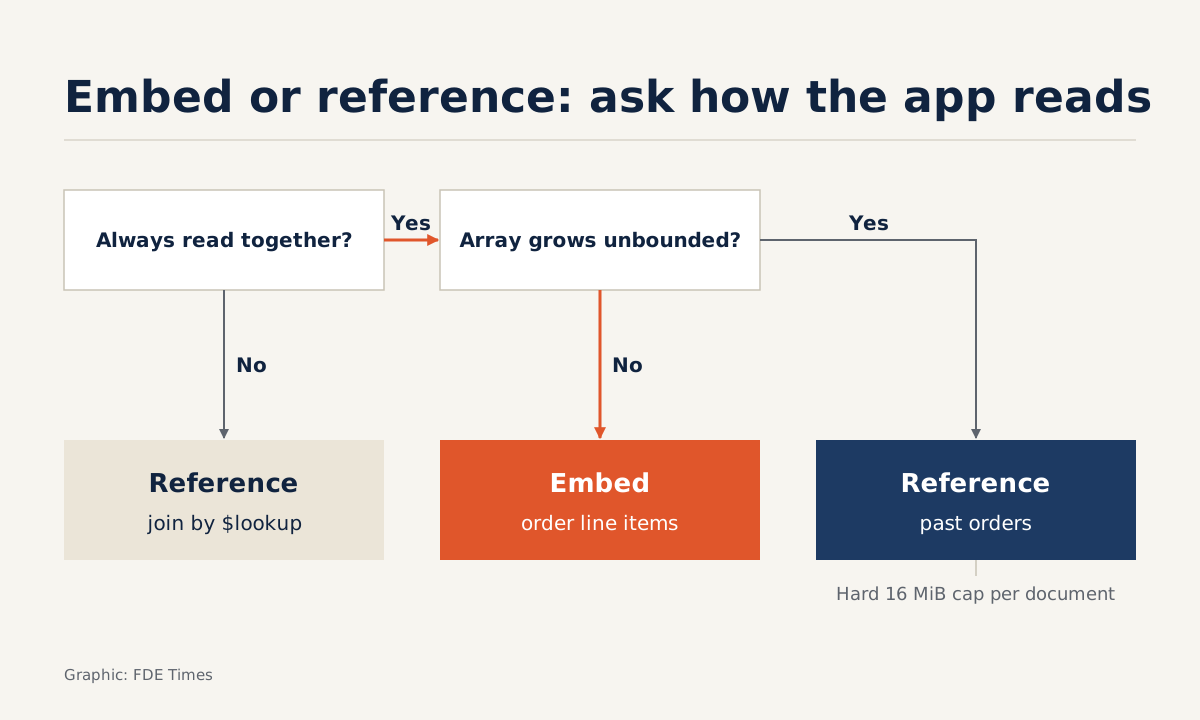
- 两个实体之间是“has-a”关系且总是一起读取时用嵌入;嵌入的数据可能无限增长时用引用
- 搬数据只是一半工作,另一半是把 SQL 转换成聚合管道,并在切换日之前完成验证
设想客户交给你一个在 SQL Server 上跑了十年的应用:几百张表,数千条查询散落在 Java 代码里,运维团队只关心一个问题:迁移到 MongoDB Atlas 要多久,有什么风险?
MongoDB 自己的招聘启事也承认,这类迁移耗时长,而且往往风险很高。
MongoDB 新组建的 Field Engineering 团队瞄准的正是这个问题,为此设立了一个专门为客户做应用现代化的前线部署工程师(FDE)岗位,职位名称为“Forward Deployed AI Engineer”。入职者要亲自参与以结果为导向的项目,从 POC、MVP 到两者之间的各种形态,并把从客户那里学到的东西带回产品路线图。
无论将来是否去 MongoDB 工作,这项技能在任何需要为遗留系统设计新数据模型的地方都用得上。最容易出错、也最值得先练的一点,是把基于表的思维原封不动地带进文档世界。
正确的问题是“应用会把哪些数据一起读取?”
关系模型讲究范式化:每个实体一张表,读取时再 JOIN 回来。文档模型恰好相反:总是一起读取的数据放进同一个文档,一次读取就够了。
MongoDB 文档给出了应当嵌入的两个信号:两个实体之间存在“has-a”或“包含”关系,并且这些数据经常被一起查询。反过来同样明确:嵌入的数据可能无限增长时,就用引用。
第二条规则背后是一个硬性限制:单个 BSON 文档不能超过 16 MiB。这不是性能建议,而是一堵墙。在生产环境中撞上它,写入就会失败。
示例:订单、订单明细和客户
设想一个销售系统有三张表:customers、orders 和 order_items。打开最频繁的页面是“订单详情”,它总是同时需要订单本身及其全部明细。背后的 SQL 如下:
SELECT o.id, o.created_at, SUM(i.qty * i.price) AS total
FROM orders o
JOIN order_items i ON i.order_id = o.id
WHERE o.customer_id = 42
GROUP BY o.id, o.created_at;
订单“包含”订单明细,两者总是一起读取。两个信号都具备,所以把明细嵌入订单。一个订单的明细行数也有天然上限,没有人会在一个购物车里放一百万件商品。
{
  "_id": 9001,
  "customerId": 42,
  "createdAt": "2026-10-01T09:30:00Z",
  "items": [
    { "sku": "A-17", "qty": 2, "price": 150 },
    { "sku": "B-03", "qty": 1, "price": 90 }
  ]
}
那客户和订单之间的关系呢?很多人会想把完整的订单历史嵌入客户文档。做个假设性的计算:如果每个订单约 2 KB,16 MiB(16,777,216 字节)只能容纳约 8,192 个订单。
一个连续多年每天下单的企业客户迟早会撞到这个上限,而订单历史恰恰属于“无限增长”的数据。因此订单放在单独的集合里,通过 customerId 引用客户。
改写成聚合管道后,上面的 SQL 查询不再需要 JOIN:
db.orders.aggregate([
  { $match: { customerId: 42 } },
  { $project: {
      createdAt: 1,
      total: { $sum: { $map: {
        input: "$items", as: "i",
        in: { $multiply: ["$$i.qty", "$$i.price"] }
      } } }
  } }
]);
当某个页面需要同时显示订单和客户信息时,用 $lookup 沿引用取数:
db.orders.aggregate([
  { $match: { _id: 9001 } },
  { $lookup: {
      from: "customers",
      localField: "customerId",
      foreignField: "_id",
      as: "customer"
  } },
  { $unwind: "$customer" },
  { $project: { createdAt: 1, items: 1, "customer.name": 1 } }
]);
一条实用规则:如果前面的 $match 已经把范围缩小到少数几个文档,而且页面不在热路径上(比如管理页面或报表),用 $lookup 完全没问题。
如果打开最频繁的页面也要不停地执行 $lookup,就说明该重新审视设计了,可以考虑把少量很少变动的字段(比如客户姓名)直接复制到订单文档中。
到了客户现场,从哪里入手?
不是从复制数据入手。AWS 与一位 MongoDB 作者共同撰写的“从关系型数据库迁移到 AWS 上的 Atlas”模式,第一步是需求调研和评估:借助 Relational Migrator 的建议,再用 db.stats() 得到索引总大小,估算工作集,并尽早规划切换。
该模式要求 MongoDB 5.0 或更高版本。
拿到这些测算结果之后,才开始映射 schema。Relational Migrator 可以读取 Oracle、Microsoft SQL Server、MySQL、DB2、Sybase 和 PostgreSQL 数据源,并支持以可视化方式把关系模型映射为文档 schema:自定义字段、拆分表、嵌入文档。
工具能提速,但嵌入还是引用的决定,仍然要依据调研阶段整理出的页面和查询清单。
schema 之后是应用代码,这是最容易被低估的部分。Relational Migrator 确实能把 SQL 转换成聚合管道,但新旧查询仍要在同一份数据集上运行,逐条比对结果,之后才能考虑切换。
就连 MongoDB 于 2025 年 9 月 16 日推出的 AI 辅助现代化平台 AMP,也配有负责监督和指导工作的交付工程师:工具加快转换速度,而设计决策和验证仍是驻场工程师的职责。
让迁移失败的常见错误
最常见的错误是把每张表原样复制成一个集合,再到处用 $lookup 替代 JOIN。结果只是一个披着 MongoDB 外衣、速度更慢的关系型数据库。
相反的错误同样危险:什么都嵌入,包括会永远增长的数组,比如日志、评论或交易历史。用样例数据做 POC 时运行得很漂亮,一年后却撞上 16 MiB 的上限。
还有一种错误是把迁移仅仅看作搬数据,忘了代码里数千条 SQL 查询也必须改写。如果跳过工作集测算,很容易选错集群规格,导致切换当天性能还不如旧系统,而那恰恰是客户盯得最紧的时候。
这项技能如何体现在简历上?
MongoDB 的招聘启事要求熟练掌握 JavaScript 以及 Java 或 C#,并了解 GenAI。这套技能组合反映了工作内容:既要读懂 SQL 所在的企业后端代码,又要用 JavaScript 编写 MongoDB 查询。
写简历时,不要只写“有 MongoDB 使用经验”,而要描述一个具体案例:源 schema 有多少张表,在哪些地方选择了嵌入、为什么,转换并验证了多少条查询。
下次面对关系型 schema 时,别问每张表该变成哪个集合,而要问:哪个页面会把哪些数据一起读取,哪些数组会持续增长。
这篇文章对你有帮助吗?
感谢你的反馈!
6 个信源
- Senior Forward Deployed AI Engineer @ MongoDB | AlleyCorp Job Board
- MongoDB Relational Migrator | MongoDB
- Best Practices for Data Modeling in MongoDB (MongoDB Database Manual)
- MongoDB Limits and Thresholds - Database Manual - MongoDB Docs
- Migrate a relational database to MongoDB Atlas on AWS
- MongoDB Launches AI-Powered Application Modernization Platform to Reduce Technical Debt and Speed Innovation · 2025-09-16