Chuyển ứng dụng sang MongoDB Atlas: đừng chép bảng thành collection
Chép từng bảng thành từng collection thì nhanh, nhưng cái khó thật của đợt migration là phải thiết kế lại dữ liệu theo đúng cách ứng dụng đọc nó, không theo cách cơ sở dữ liệu cũ lưu nó.

Tóm tắt nhanh
- Đừng chép mỗi bảng thành một collection: hãy bắt đầu từ việc ứng dụng đọc dữ liệu như thế nào
- Nhúng khi hai thực thể có quan hệ "has-a" và luôn được đọc cùng nhau; tham chiếu khi dữ liệu nhúng có thể phình ra mãi
- Chuyển dữ liệu mới xong một nửa việc, nửa còn lại là dịch câu SQL sang aggregation pipeline rồi kiểm chứng trước ngày cutover
Thử hình dung khách hàng đưa bạn một ứng dụng đã chạy mười năm trên SQL Server: vài trăm bảng, hàng nghìn câu truy vấn nằm rải rác trong code Java, và một đội vận hành chỉ hỏi đúng một câu: chuyển sang MongoDB Atlas thì bao giờ xong, có rủi ro gì không.
Chính tin tuyển dụng của MongoDB cũng thừa nhận những đợt chuyển đổi kiểu này rất tốn thời gian và thường rủi ro.
Đó là bài toán mà đội Field Engineering mới lập của MongoDB nhắm tới, với vị trí “Forward Deployed AI Engineer” chuyên hiện đại hoá ứng dụng cho khách. Người vào vị trí này tự tay làm các dự án gắn với kết quả cụ thể, từ POC, MVP đến mọi thứ ở giữa, rồi mang những gì học được ở khách về cho lộ trình sản phẩm.
Dù bạn có làm ở MongoDB hay không, kỹ năng này vẫn dùng được ở bất cứ đâu có hệ thống cũ cần đổi mô hình dữ liệu. Chỗ dễ trượt chân nhất, và cũng là chỗ đáng tập trước tiên, là mang nguyên tư duy bảng sang thế giới document.
Câu hỏi đúng là “ứng dụng đọc gì cùng nhau?”
Trong mô hình quan hệ, bạn chuẩn hoá dữ liệu: mỗi thực thể một bảng, ghép lại bằng JOIN lúc đọc. Trong document model, bạn làm điều ngược lại. Dữ liệu nào luôn được đọc cùng nhau thì đặt cùng một document, để một lần đọc là đủ.
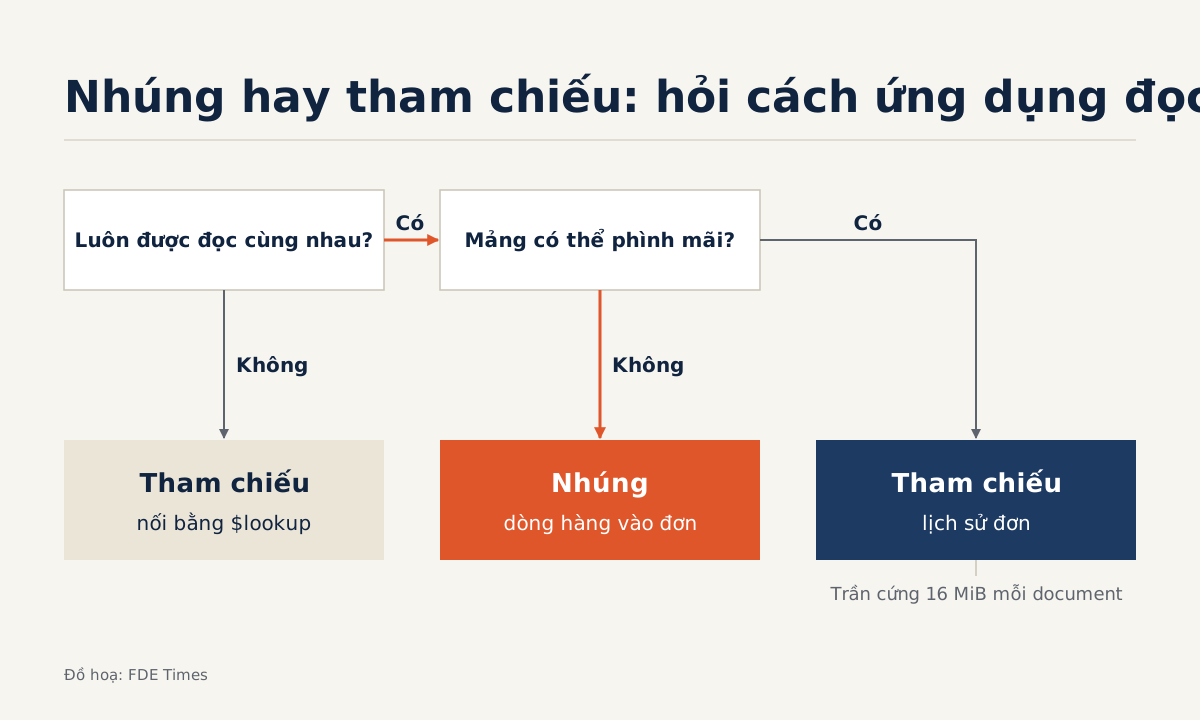
Tài liệu của MongoDB đưa ra hai dấu hiệu nên nhúng (embed): giữa hai thực thể có quan hệ “has-a” hoặc “chứa”, và dữ liệu đó thường được truy vấn cùng nhau. Chiều ngược lại cũng rõ: nên tham chiếu (reference) khi phần dữ liệu nhúng có thể phình ra không giới hạn.
Đằng sau quy tắc thứ hai là một giới hạn cứng: một document BSON không được vượt quá 16 mebibyte. Đây không phải lời khuyên về hiệu năng mà là bức tường. Chạm vào nó trên production thì thao tác ghi sẽ hỏng.
Một ví dụ: đơn hàng, dòng hàng và khách hàng
Thử hình dung một hệ thống bán hàng có ba bảng: customers, orders, order_items. Màn hình được mở nhiều nhất là “chi tiết đơn hàng”, và nó luôn cần cả đơn hàng lẫn mọi dòng hàng bên trong. Câu SQL đứng sau trông như sau:
SELECT o.id, o.created_at, SUM(i.qty * i.price) AS total
FROM orders o
JOIN order_items i ON i.order_id = o.id
WHERE o.customer_id = 42
GROUP BY o.id, o.created_at;
Một đơn hàng “chứa” các dòng hàng, và hai thứ luôn được đọc cùng nhau. Cả hai dấu hiệu đều có, nên dòng hàng được nhúng vào đơn hàng. Số dòng của một đơn thì có giới hạn tự nhiên, vì chẳng ai đặt một triệu món trong một giỏ.
{
  "_id": 9001,
  "customerId": 42,
  "createdAt": "2026-10-01T09:30:00Z",
  "items": [
    { "sku": "A-17", "qty": 2, "price": 150 },
    { "sku": "B-03", "qty": 1, "price": 90 }
  ]
}
Còn quan hệ giữa khách hàng và đơn hàng thì sao? Nhiều người sẽ muốn nhúng luôn toàn bộ lịch sử đơn vào document khách hàng. Hãy làm một phép tính giả định: nếu mỗi đơn khoảng 2 KB, thì 16 MiB (16.777.216 byte) chỉ chứa được chừng 8.192 đơn.
Một khách doanh nghiệp đặt hàng hằng ngày suốt nhiều năm sẽ chạm trần, và lịch sử đơn là thứ “phình ra không giới hạn”. Vì thế đơn hàng nằm ở collection riêng và tham chiếu tới khách qua customerId.
Câu SQL ở trên, viết lại thành aggregation pipeline, không còn JOIN nào:
db.orders.aggregate([
  { $match: { customerId: 42 } },
  { $project: {
      createdAt: 1,
      total: { $sum: { $map: {
        input: "$items", as: "i",
        in: { $multiply: ["$$i.qty", "$$i.price"] }
      } } }
  } }
]);
Khi một màn hình cần thêm thông tin khách bên cạnh đơn hàng, bạn đi theo tham chiếu bằng $lookup:
db.orders.aggregate([
  { $match: { _id: 9001 } },
  { $lookup: {
      from: "customers",
      localField: "customerId",
      foreignField: "_id",
      as: "customer"
  } },
  { $unwind: "$customer" },
  { $project: { createdAt: 1, items: 1, "customer.name": 1 } }
]);
Lời khuyên thực tế: $lookup hoàn toàn ổn khi $match đứng trước đã thu hẹp xuống vài document và màn hình đó không nằm trên đường nóng, chẳng hạn trang quản trị hay báo cáo.
Nếu màn hình được mở nhiều nhất cũng phải $lookup liên tục, đó là tín hiệu nên quay lại xem có nên chép vài field ít thay đổi như tên khách vào luôn document đơn hàng.
Ở chỗ khách, bắt đầu từ đâu?
Đừng bắt đầu bằng việc chép dữ liệu. Mẫu migration từ cơ sở dữ liệu quan hệ sang Atlas trên AWS, do AWS viết chung với một tác giả của MongoDB, mở đầu bằng discovery và đánh giá: ước lượng working set bằng gợi ý của Relational Migrator cộng với db.stats() để biết tổng dung lượng index, và lên kế hoạch cutover từ sớm.
Mẫu này yêu cầu MongoDB 5.0 trở lên.
Có số đo rồi mới đến map schema. Relational Migrator đọc được nguồn Oracle, Microsoft SQL Server, MySQL, DB2, Sybase và PostgreSQL, và cho bạn map trực quan từ mô hình quan hệ sang schema document: tuỳ chỉnh field, tách bảng, nhúng document.
Công cụ giúp bạn làm nhanh, nhưng quyết định nhúng hay tham chiếu vẫn phải đến từ danh sách màn hình và câu truy vấn bạn đã thu thập ở bước discovery.
Sau schema là code ứng dụng, phần hay bị đánh giá thấp nhất. Relational Migrator có dịch câu SQL sang aggregation pipeline, nhưng bạn vẫn phải chạy cả câu cũ lẫn câu mới trên cùng một bộ dữ liệu, so từng kết quả, rồi mới tính chuyện cutover.
Ngay cả AMP, nền tảng hiện đại hoá có AI hỗ trợ mà MongoDB ra mắt ngày 16/9/2025, cũng đi kèm các delivery engineer giám sát và dẫn dắt quá trình thực hiện: công cụ làm nhanh phần chuyển đổi, còn quyết định thiết kế và việc kiểm chứng vẫn là phần việc của người đứng ở chỗ khách.
Những lỗi khiến đợt migration đổ vỡ
Lỗi phổ biến nhất là chép nguyên si mỗi bảng thành một collection rồi dùng $lookup để thay JOIN ở khắp nơi. Kết quả là bạn có một cơ sở dữ liệu quan hệ chạy chậm hơn, mặc áo MongoDB.
Lỗi ngược lại cũng nguy hiểm không kém: nhúng mọi thứ, kể cả những mảng sẽ lớn lên mãi như log, bình luận hay lịch sử giao dịch. Nó chạy đẹp ở POC với dữ liệu mẫu, rồi một năm sau thì đâm vào giới hạn 16 MiB.
Kế đến là coi migration chỉ là chuyển dữ liệu, quên rằng hàng nghìn câu SQL trong code cũng phải đổi theo. Và nếu bỏ qua bước đo working set, bạn dễ chọn sai cỡ cluster, để hiệu năng ngày cutover tệ hơn hệ thống cũ, đúng lúc khách đang theo dõi sát nhất.
Kỹ năng này hiện lên trong CV thế nào?
Tin tuyển dụng của MongoDB yêu cầu thành thạo JavaScript cùng Java hoặc C#, thêm hiểu biết về GenAI. Bộ kỹ năng đó phản ánh đúng công việc: bạn phải đọc được code backend doanh nghiệp, nơi các câu SQL đang nằm, và viết được truy vấn MongoDB bằng JavaScript.
Khi viết CV, đừng chỉ ghi “có kinh nghiệm MongoDB”. Hãy kể một ca cụ thể: schema nguồn có bao nhiêu bảng, bạn quyết định nhúng ở đâu và vì sao, bao nhiêu câu truy vấn đã được dịch và kiểm chứng.
Lần tới khi gặp một schema quan hệ, đừng hỏi bảng này thành collection nào. Hãy hỏi màn hình nào đọc những gì cùng nhau, và mảng nào sẽ lớn lên mãi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Senior Forward Deployed AI Engineer @ MongoDB | AlleyCorp Job Board
- MongoDB Relational Migrator | MongoDB
- Best Practices for Data Modeling in MongoDB (MongoDB Database Manual)
- MongoDB Limits and Thresholds - Database Manual - MongoDB Docs
- Migrate a relational database to MongoDB Atlas on AWS
- MongoDB Launches AI-Powered Application Modernization Platform to Reduce Technical Debt and Speed Innovation · 2025-09-16