Prompt caching thực chiến: sắp xếp prompt để trúng cache rồi đo tiền và độ trễ
Chỉ một dấu thời gian đặt sai chỗ cũng làm hỏng cả cache. Hướng dẫn này giúp bạn sắp xếp lại prompt và chứng minh khoản tiết kiệm bằng chính số liệu usage của API.

Tóm tắt nhanh
- Cache bao phủ prompt theo thứ tự tools → system → messages; sửa một tầng phía trước là mọi tầng phía sau đều mất cache.
- Đặt breakpoint ở block cuối cùng còn giống hệt nhau giữa các request; lệch một ký tự là trượt.
- Đo bằng cache_read_input_tokens, cache_creation_input_tokens và input_tokens, đừng đo bằng cảm giác.
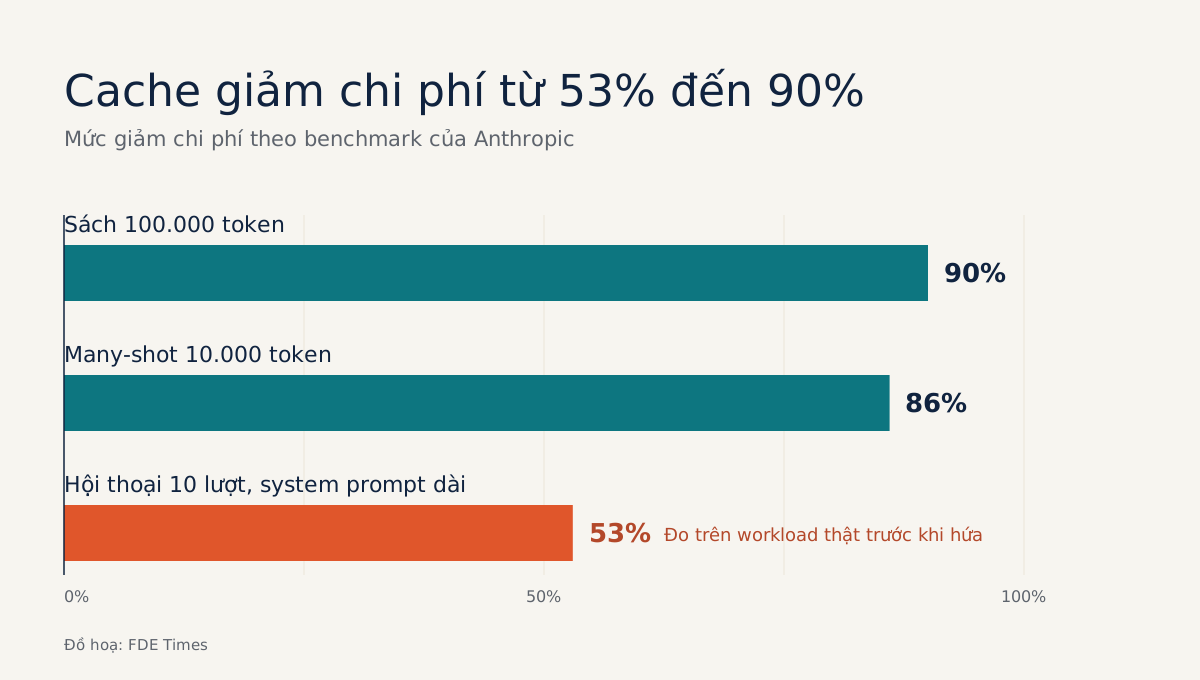
Với một prompt chứa cuốn sách dài 100.000 token, Anthropic đo được thời gian chờ token đầu tiên giảm từ 11,5 giây xuống 2,4 giây, còn chi phí giảm 90%. Hãng không cần mô hình mới để có kết quả đó. Họ chỉ cho hệ thống đọc lại phần prompt đã xử lý thay vì xử lý lại từ đầu.
Vấn đề là cache chỉ trúng khi phần đầu prompt giống hệt nhau. Thử hình dung một hệ thống ở phía khách hàng nhét ngày giờ hay tên người dùng lên dòng đầu system prompt. Khi đó, dù đã bật cache, request nào cũng trượt.
Hướng dẫn này đi qua sáu bước, từ đo baseline, sắp xếp lại prompt, đặt breakpoint, kiểm tra hit, cho tới quy đổi ra tiền. Cuối cùng bạn sẽ có một bảng trước/sau để đưa cho khách. Đó chính là thứ một FDE cần mang vào buổi review.
Bạn sẽ dựng gì, cần chuẩn bị gì?
Ta sẽ viết một script Python nhỏ, hỏi đáp trên một tài liệu chính sách dài và không đổi. Script chạy hai chế độ có và không có cache, rồi ghi lại độ trễ cùng số token của từng request. Bạn cần API key của Anthropic, SDK Python và một file văn bản đủ dài, chẳng hạn quy trình nội bộ hoặc tài liệu sản phẩm.
Code dưới đây đã được rút gọn để dễ đọc. Tên model và cú pháp chính xác của cache_control nên đối chiếu lại với tài liệu prompt caching của Anthropic trước khi chạy thật.
Bước 1: đo baseline trước khi động vào bất cứ thứ gì
Không có số “trước” thì cũng không có câu chuyện “sau”. Hãy bọc lời gọi API, ghi thời gian và các trường usage.
import time, anthropic
client = anthropic.Anthropic()
MODEL = "..."   # điền tên model bạn dùng, lấy từ tài liệu của Anthropic
DOC = open("policy.txt").read()   # phần tĩnh, không đổi giữa các request

def build_system(cached):
    system = [{"type": "text", "text": "Bạn là trợ lý tra cứu chính sách."},
              {"type": "text", "text": DOC}]
    if cached:
        system[-1]["cache_control"] = {"type": "ephemeral"}  # rút gọn
    return system

def ask(question, cached):
    t0 = time.perf_counter()
    r = client.messages.create(model=MODEL, max_tokens=300,
        system=build_system(cached),
        messages=[{"role": "user", "content": question}])
    u = r.usage
    return (time.perf_counter() - t0, u.input_tokens,
            u.cache_creation_input_tokens, u.cache_read_input_tokens)
Hàm ask đo tổng thời gian phản hồi, gồm cả thời gian sinh output. Benchmark của Anthropic lại đo thời gian tới token đầu tiên, nên muốn so trực tiếp với họ bạn cần thêm một biến thể streaming như dưới đây (bản rút gọn, đối chiếu cú pháp với tài liệu SDK).
def ask_ttft(question, cached):
    t0 = time.perf_counter()
    ttft = None   # khởi tạo trước, phòng khi không có text nào trả về
    with client.messages.stream(model=MODEL, max_tokens=300,
            system=build_system(cached),
            messages=[{"role": "user", "content": question}]) as s:
        for _ in s.text_stream:
            ttft = time.perf_counter() - t0   # token đầu tiên đã về
            break
        u = s.get_final_message().usage
    if ttft is None:   # response không có text: ghi tổng thời gian và đánh dấu lại
        ttft = time.perf_counter() - t0
    return (ttft, u.input_tokens,
            u.cache_creation_input_tokens, u.cache_read_input_tokens)
Sau bước này, hãy chạy cả ask(q, cached=False) và ask_ttft(q, cached=False) với 10 câu hỏi rồi lưu kết quả. Bạn sẽ có tổng thời gian, thời gian tới token đầu tiên và số token để làm cột “trước”. Ở các bước sau, chỉ cần đổi cached=True và chạy lại đúng hai hàm đó.
Bước 2: thứ tự nào giúp trúng cache?
Theo tài liệu của Anthropic, cache bao phủ toàn bộ prompt theo đúng thứ tự tools, rồi system, rồi messages, tính tới hết block có gắn cache_control. Thay đổi ở tầng nào sẽ làm mất hiệu lực tầng đó cùng mọi tầng phía sau. Sửa một tool definition, kể cả chỉ đổi thứ tự hai tool, là system và messages cũng mất cache.
Vì thế, quy tắc sắp xếp chỉ có một: phần ổn định đặt trước, phần động đặt sau cùng. OpenAI khuyên điều tương tự, tức là đưa chỉ dẫn ổn định và tài liệu tham khảo dùng chung lên đầu. Nếu chuyển nhà cung cấp, bạn vẫn giữ được thói quen này.
Thử hình dung một system prompt mở đầu bằng “Hôm nay là 25/10/2026, người dùng: Lan”. Mỗi người dùng, mỗi ngày lại là một prefix mới. Hãy chuyển dòng đó xuống message của người dùng, đặt sau tài liệu tĩnh.
Bước 3: đặt breakpoint ở đâu?
Anthropic khuyên đặt breakpoint ở block cuối cùng còn giống hệt nhau giữa các request. Mỗi request được dùng tối đa 4 breakpoint. Trong script trên, block đó là DOC, vì câu hỏi thay đổi liên tục và nằm trong messages sau nó.
Với hội thoại nhiều lượt, có thể suy ra một gợi ý từ hai quy tắc trên: các lượt cũ giữ nguyên giữa các request, nên chúng cũng là ứng viên cho một breakpoint thứ hai, trong giới hạn 4 breakpoint. Đây là cách áp dụng chứ không phải công thức có sẵn, vì vậy hãy kiểm chứng bằng usage ở bước 4 trước khi tin rằng nó hiệu quả.
Bước 4: làm sao biết request đã trúng cache?
Chạy cùng một câu hỏi hai lần liên tiếp với cached=True. Request đầu tiên phải có cache_creation_input_tokens lớn hơn 0 và cache_read_input_tokens bằng 0. Đến request thứ hai, vẫn cùng prefix đó, cache_read_input_tokens phải lớn hơn 0.
Nếu lần thứ hai vẫn chỉ thấy số creation, nghĩa là prefix đã thay đổi đâu đó. Chỉ cần lệch một ký tự là cache tạo một entry mới. Hãy so hai prompt bằng diff, đừng so bằng mắt.
Tổng input của mỗi request bằng cache_read_input_tokens + cache_creation_input_tokens + input_tokens. Lấy số đọc chia cho tổng đó, bạn có tỉ lệ hit, và đây là con số đáng theo dõi trên dashboard.
Bước 5: hâm nóng cache trước khi chạy song song
Một cái bẫy khi xử lý batch là bắn 50 request cùng một lúc rồi thấy request nào cũng ghi cache. Entry cache chỉ có sau khi response đầu tiên bắt đầu trả về, nên các request song song gửi cùng thời điểm đều trượt. Cách sửa là gửi một request trước, đợi nó bắt đầu trả lời, rồi mới mở song song.
Cũng cần để ý TTL. Mặc định cache sống 5 phút và được làm mới miễn phí mỗi lần trúng. Nếu traffic thưa hơn khoảng đó, bạn có thể chọn TTL 1 giờ, nhưng phải trả thêm phí ghi.
Bước 6: quy ra tiền như thế nào?
Theo bảng giá của Anthropic, ghi cache với TTL 5 phút tốn 1,25 lần giá input cơ bản, TTL 1 giờ tốn 2 lần, còn đọc cache chỉ tốn 0,1 lần. Một số model mới có giá đọc còn thấp hơn. Hàm dưới đây tính chi phí theo đơn vị “giá input cơ bản”, chưa tính token output.
def cost_units(inp, write, read, write_rate=1.25):
    # write_rate=2.0 nếu dùng TTL 1 giờ; giá đọc 0.1 có thể thấp hơn ở model mới
    return inp * 1.0 + write * write_rate + read * 0.1
Thử một ví dụ giả định: tài liệu tĩnh dài 20.000 token, có 10 câu hỏi trong vòng 5 phút, bỏ qua phần câu hỏi ngắn. Không có cache thì tốn 10 × 20.000 = 200.000 đơn vị.
Có cache thì lần đầu ghi 20.000 × 1,25 = 25.000, chín lần sau đọc 9 × 20.000 × 0,1 = 18.000, cộng lại 43.000 đơn vị, tức giảm khoảng 78,5%.
Ví dụ này cũng cho thấy khi nào cache không có lời. Nếu mỗi prefix chỉ được dùng đúng một lần, bạn trả 1,25 lần mà không đọc lại lần nào, tức là lỗ 25%.
Kết quả của bạn nên trông thế nào?
Mức cải thiện phụ thuộc vào workload. Benchmark của Anthropic ghi nhận hội thoại 10 lượt với system prompt dài giảm khoảng 75% độ trễ và 53% chi phí. Prompt many-shot dài 10.000 token giảm 31% độ trễ và 86% chi phí. Đừng hứa với khách con số 90% trước khi đo trên chính workload của họ.
| Chỉ số | Trước | Sau |
|---|---|---|
| Thời gian tới token đầu tiên (giây) | ask_ttft(..., cached=False) |
ask_ttft(..., cached=True) |
| Tỉ lệ hit | 0% | read / tổng input |
| Chi phí input (đơn vị) | cost_units |
cost_units |
Với OpenAI thì khác gì?
OpenAI tự động cache, bạn không cần gắn breakpoint. Muốn kiểm tra hit thì đọc trường cached_tokens. Trường này chỉ đếm token đọc được tính tiền, không gồm token bị tính là ghi.
Tham số prompt_cache_key chỉ ảnh hưởng tới việc định tuyến request. Nó không ghim request vào một máy và cũng không bảo đảm sẽ trúng cache. Vì vậy cách kiểm chứng vẫn là con số trong usage.
Những lỗi nào hay làm hỏng cache nhất?
Lỗi phổ biến nhất là để phần động như ngày giờ, tên người dùng hay ID nằm trước phần tĩnh, khiến prefix đổi theo từng request.
Gần giống vậy là sửa hoặc đổi thứ tự tool definition: vì tools đứng đầu, thay đổi ở đó kéo theo system và messages cũng mất cache.
Lỗi thứ ba là gắn cache_control lên một block vẫn còn thay đổi, thay vì block cuối cùng còn giống hệt nhau.
Ba lỗi còn lại nằm ở cách vận hành. Bắn batch song song khi cache chưa được hâm nóng thì request nào cũng trượt. Traffic thưa hơn TTL 5 phút làm cache hết hạn giữa hai lần gọi, còn prefix chỉ dùng một lần thì bạn trả phí ghi mà không đọc lại lần nào.
Với OpenAI, lỗi hay gặp là tin rằng đặt prompt_cache_key là đủ. Dù dùng nhà cung cấp nào, cách bắt cả sáu lỗi này vẫn chỉ có một: xem các trường usage sau mỗi thay đổi.
Kỹ năng này xuất hiện ở khách hàng ra sao?
Ở phía khách hàng, chuyện thường bắt đầu bằng một câu như “hóa đơn API tháng này tăng gấp đôi” hoặc “chatbot trả lời chậm quá”. Một FDE giỏi sẽ không đổi model ngay. Họ mở prompt ra, tìm thứ đang phá prefix, sắp xếp lại, rồi đưa bảng trước/sau ở trên cho khách.
Khi đọc job description, hãy để ý các cụm như “LLM cost optimization” hay “latency”. Trong CV, viết kèm số đo được, chẳng hạn tỉ lệ hit tăng từ bao nhiêu lên bao nhiêu và chi phí input giảm bao nhiêu phần trăm, kèm cách bạn đo. Người phỏng vấn tin vào ba trường usage hơn là tin vào tính từ.
Lần tới khi mở một prompt dài, hãy đọc dòng đầu tiên trước. Nếu dòng đó thay đổi theo từng request, bạn đã thấy chỗ đầu tiên cần sửa.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!