Vì sao Promise.all có thể làm hỏng cả buổi đồng bộ dữ liệu của khách hàng, và cách viết lại
Chỉ cần một bản ghi lỗi là cả lô bị báo thất bại, trong khi các lệnh ghi vào hệ thống của khách vẫn tiếp tục chạy mà không ai còn theo dõi.

Tóm tắt nhanh
- Promise.all reject ngay khi gặp lỗi đầu tiên nhưng không hủy các thao tác còn lại, nên các lệnh ghi vào hệ thống của khách vẫn chạy tiếp.
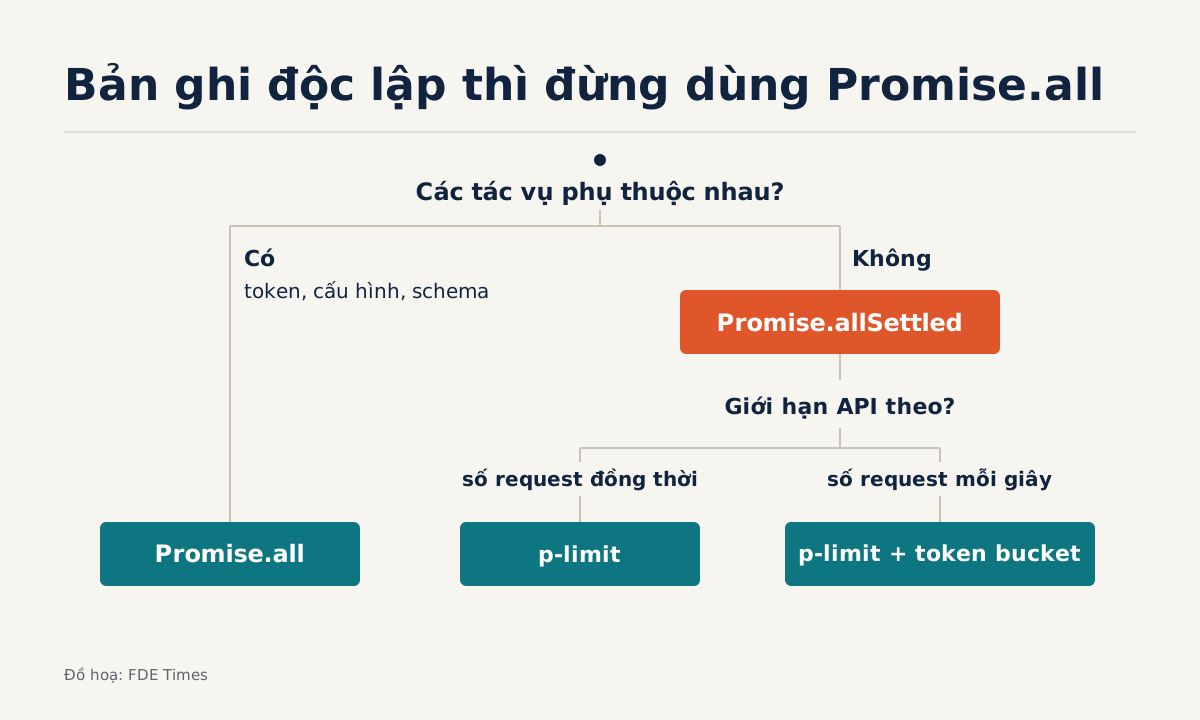
- Với các bản ghi độc lập, Promise.allSettled cho bạn kết quả của từng bản ghi để lập báo cáo và chỉ retry phần lỗi.
- p-limit chỉ giới hạn số tác vụ chạy cùng lúc. Quota tính theo số request mỗi giây cần một cơ chế riêng như token bucket, kèm retry khi gặp 429.
Thử hình dung bạn đang ở văn phòng khách hàng, chạy buổi đồng bộ đầu tiên: 5.000 contact từ hệ thống cũ sang CRM mới. Vài giây sau, terminal in ra đúng một dòng: “sync failed”. Khách hỏi bao nhiêu bản ghi đã sang, bao nhiêu bản ghi lỗi. Bạn không trả lời được.
Lỗi thường không nằm ở API của khách. Nó nằm ở một dòng code trông rất vô hại: await Promise.all(contacts.map(upsert)). Gần như ai mới viết JavaScript bất đồng bộ cũng từng viết dòng này, và nó chạy tốt khi demo với 20 bản ghi.
Với một FDE, đây là bài học về cách làm nghề nhiều hơn là về cú pháp. Khi tích hợp với khách, bạn phải trả lời được bản ghi nào đã sang, bản ghi nào lỗi và vì sao, và có chạy lại an toàn được không. Muốn trả lời ba câu đó, bạn phải hiểu rõ mỗi hàm Promise thực sự làm gì.
Promise.all được thiết kế để dừng ngay khi có lỗi
Theo tài liệu MDN, Promise.all bị reject ngay khi bất kỳ promise đầu vào nào bị reject. Đây là cơ chế fail-fast. Nếu một contact trong 5.000 contact có email sai định dạng và API trả về 400, cả lời gọi await sẽ ném lỗi, và bạn mất kết quả của 4.999 bản ghi còn lại.
Còn một chi tiết nguy hiểm hơn. MDN ghi rõ việc reject promise trả về không hủy các thao tác còn lại. Nghĩa là code của bạn đã nhảy vào catch và log “sync failed”, nhưng hàng nghìn request vẫn đang ghi vào CRM của khách mà không còn ai theo dõi.
Hệ quả là dữ liệu của khách rơi vào trạng thái không ai biết rõ. Bạn nghĩ lô đã thất bại nên chạy lại, nhưng thực ra phần lớn bản ghi đã được ghi. Nếu thao tác ghi không idempotent, lần chạy lại sẽ tạo bản ghi trùng, và lúc đó bạn phải đi dọn dữ liệu cho khách thay vì bàn bước tiếp theo.
Bản ghi độc lập thì cần một công cụ khác
MDN đưa ra một ranh giới rất rõ. Promise.allSettled thường dùng khi các tác vụ không phụ thuộc vào nhau, hoặc khi bạn luôn muốn biết kết quả của từng promise. Promise.all hợp lý hơn khi các tác vụ phụ thuộc nhau, hoặc khi bạn muốn dừng ngay khi có một tác vụ lỗi.
Phần lớn các buổi đồng bộ dữ liệu thuộc nhóm đầu: contact A lỗi không ảnh hưởng gì đến contact B. Promise.all vẫn có chỗ dùng riêng, chẳng hạn khi bạn cần lấy cả token xác thực lẫn cấu hình trước khi bắt đầu, vì thiếu một trong hai thì không làm tiếp được.
Promise.all
- Reject ngay khi có lỗi đầu tiên
- Các thao tác còn lại vẫn chạy, không ai theo dõi
- Hợp với các bước phụ thuộc nhau: token, cấu hình, schema
- Lô phải dừng nếu thiếu một phần
Promise.allSettled
- Chờ mọi tác vụ kết thúc
- Trả về status, value hoặc reason cho từng tác vụ, đúng thứ tự đầu vào
- Hợp với các bản ghi độc lập trong một buổi đồng bộ
- Có thể chỉ chạy lại phần lỗi
Theo MDN, allSettled trả về mảng kết quả theo đúng thứ tự đầu vào. Mỗi phần tử có status là “fulfilled” hoặc “rejected”. Kết quả fulfilled có trường value, kết quả rejected có trường reason. Vì giữ đúng thứ tự, bạn ghép lại được từng kết quả với bản ghi gốc qua chỉ số, và có ngay báo cáo theo từng bản ghi.
Đổi sang allSettled vẫn chưa giải quyết hết
Nếu chỉ thay all bằng allSettled, bạn vẫn bắn 5.000 request cùng một lúc. API của khách sẽ trả về hàng loạt lỗi 429, và báo cáo của bạn sẽ báo vài nghìn bản ghi lỗi chỉ vì bạn gửi quá nhanh.
Thư viện phổ biến để xử lý chuyện này là p-limit của Sindre Sorhus, dùng để chạy các hàm async với số lượng song song có giới hạn. Bạn bọc từng tác vụ bằng limit(...) rồi vẫn gom kết quả bằng Promise.all hoặc allSettled như bình thường.
Nhưng README của p-limit nói rõ thư viện chỉ giới hạn số tác vụ chạy cùng lúc. Nếu quota của API tính theo số request mỗi giây, năm request song song mà mỗi request trả về rất nhanh vẫn có thể vượt quota.
Bài viết của Anvil về giới hạn 429 cũng nhắc rằng nhiều SDK, kể cả của các nhà cung cấp API lớn, không tự xử lý rate limit, nên phần này thường do bạn tự làm.
Viết lại script đồng bộ
Đây là phiên bản viết lại, dùng p-limit, retry khi gặp 429 và báo cáo kết quả theo từng bản ghi:
import pLimit from 'p-limit';

const limit = pLimit(5); // tối đa 5 request chạy cùng lúc
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

function retryDelayMs(retryAfter, attempt) {
  if (retryAfter) {
    const value = String(retryAfter).trim();
    // Phòng thủ: giá trị chỉ gồm chữ số thì coi là số giây,
    // không đưa vào bộ đọc ngày
    if (/^\d+$/.test(value)) return Number(value) * 1000;
    // Định dạng HTTP-date (không phải ISO 8601),
    // ví dụ "Wed, 21 Oct 2026 07:28:00 GMT"
    const at = Date.parse(value);
    if (!Number.isNaN(at)) return Math.max(0, at - Date.now());
  }
  return 2 ** attempt * 1000; // không đọc được header thì dùng backoff
}

async function upsertWithRetry(contact, attempt = 0) {
  try {
    return await crm.upsertContact(contact);
  } catch (err) {
    if (err.status === 429 && attempt < 5) {
      await sleep(retryDelayMs(err.headers?.['retry-after'], attempt));
      return upsertWithRetry(contact, attempt + 1);
    }
    throw err; // lỗi 400 hay lỗi dữ liệu: không retry, ghi vào báo cáo
  }
}

const settled = await Promise.allSettled(
  contacts.map((c) => limit(() => upsertWithRetry(c)))
);

const report = settled.map((r, i) => ({
  id: contacts[i].id,
  status: r.status,
  reason: r.status === 'rejected' ? String(r.reason?.message ?? r.reason) : null,
}));

const failedIds = report.filter((x) => x.status === 'rejected').map((x) => x.id);
console.log(`OK: ${report.length - failedIds.length}, lỗi: ${failedIds.length}`);
Script này đứng vững nhờ vài chi tiết nhỏ. Vì allSettled giữ thứ tự, contacts[i] luôn khớp với settled[i]. Lỗi 429 được retry, còn lỗi dữ liệu thì không, vì gửi lại một email sai định dạng bao nhiêu lần cũng vẫn lỗi.
Hàm retryDelayMs được viết theo kiểu phòng thủ. Theo Anvil, ngày trong Retry-After dùng định dạng HTTP-date chứ không phải ISO 8601, nên hàm chỉ đọc ngày sau khi đã loại riêng những giá trị trông như một con số, và luôn có backoff dự phòng.
Đừng tin mù quáng vào kết quả của bộ đọc ngày khi đầu vào lạ, vì một độ trễ tính sai có thể khiến client retry dồn dập đúng lúc API đang bảo bạn chậm lại.
Thêm một token bucket khi quota tính theo giây
Nếu quota tính theo số request mỗi giây, Anvil cho rằng token bucket là cách tốt nhất để throttle phía client. Ý tưởng là một “xô” chứa token được nạp lại theo tốc độ cố định, mỗi request phải lấy một token trước khi được gửi. Dưới đây là một bản phác thảo tối giản:
// Phác thảo token bucket: tối đa `rate` request mỗi giây
function createBucket(rate) {
  let tokens = rate;
  let last = Date.now();
  return async function take() {
    for (;;) {
      const now = Date.now();
      tokens = Math.min(rate, tokens + ((now - last) / 1000) * rate);
      last = now;
      if (tokens >= 1) { tokens -= 1; return; }
      await sleep(((1 - tokens) / rate) * 1000); // chờ đủ một token
    }
  };
}

const take = createBucket(10); // ví dụ: quota 10 request mỗi giây
Gọi await take() ngay trước crm.upsertContact(contact) bên trong upsertWithRetry, để cả những lần retry cũng phải xếp hàng lấy token. p-limit vẫn giữ số request song song, còn bucket giữ tốc độ: hai lớp này bổ sung cho nhau chứ không thay thế nhau.
Cũng theo Anvil, giải pháp lý tưởng là giấu hẳn giới hạn này đi. Bạn bọc take() và logic retry trong một client riêng, để code đồng bộ chỉ việc gọi upsertContact mà không phải bận tâm tới quota.
Các bước khi bạn ngồi với code của khách
Đầu tiên, phân loại công việc. Bước nào phụ thuộc nhau (xác thực, đọc schema) thì giữ Promise.all. Phần đồng bộ từng bản ghi thì chuyển sang allSettled. Tiếp theo, hỏi khách hoặc đọc tài liệu để biết quota tính theo số request song song hay theo số request mỗi giây, rồi chọn p-limit, token bucket hoặc dùng cả hai.
Sau đó, quyết định lỗi nào đáng retry. 429 thì retry, có giới hạn số lần, và tôn trọng Retry-After. Lỗi dữ liệu thì đưa vào báo cáo. Cuối cùng, ghi báo cáo ra file và chuẩn bị một lệnh chỉ chạy lại failedIds, để lần chạy lại không đụng tới những bản ghi đã ghi thành công.
Những lỗi hay gặp
Lỗi đầu tiên là bọc Promise.all trong try/catch rồi tin rằng đã an toàn. Catch không dừng được các request đang chạy dở. Lỗi thứ hai là coi p-limit như một rate limiter, rồi ngạc nhiên khi vẫn gặp 429. Lỗi thứ ba là retry mọi lỗi, kể cả lỗi 400, khiến một bản ghi hỏng kéo dài cả buổi đồng bộ.
Lỗi cuối cùng ít được nhắc tới nhưng gây hại nhất: chỉ log “sync failed” mà không có báo cáo theo từng bản ghi. Khách không quan tâm bạn dùng hàm Promise nào. Họ quan tâm 37 bản ghi nào chưa sang và vì sao.
Bài tập: tự tái hiện lỗi trước khi khách gặp
Viết một API giả bằng Express hoặc một hàm mock: cứ 100 bản ghi thì một bản ghi trả về 400, và nếu có quá 5 request cùng lúc thì trả về 429 kèm Retry-After, lúc là một con số, lúc là một HTTP-date.
Chạy phiên bản Promise.all, đếm số lệnh ghi vẫn diễn ra sau khi catch đã chạy, rồi chạy phiên bản viết lại ở trên và so sánh hai báo cáo.
Bài tập này cũng là chất liệu cho hồ sơ. Khi phỏng vấn FDE, hãy kể bạn phát hiện lỗi thế nào, đo được gì và sửa ra sao.
Trong CV, nên mô tả cụ thể việc đã làm, kiểu “đồng bộ dữ liệu có báo cáo theo từng bản ghi, throttle và retry khi gặp 429”, thay vì một dòng chung chung như “thành thạo JavaScript”.
Khi đọc một JD có nhắc tới integration, hãy chuẩn bị sẵn câu chuyện này để kể.
Ở chỗ khách, thứ tạo được lòng tin không phải một buổi đồng bộ chưa bao giờ lỗi. Đó là một buổi đồng bộ mà khi có lỗi, bạn nói được chính xác bản ghi nào lỗi và vì sao.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!