Cuốn sách không dạy thuật toán mà FDE nên đọc trước sách ML
Provost và Fawcett dạy cách nghĩ bằng dữ liệu, thứ FDE cần trước dòng code đầu tiên ở chỗ khách.
Tóm tắt nhanh
- Data Science for Business (O'Reilly, 2013) dạy nguyên lý rút tri thức từ dữ liệu, không dạy thuật toán.
- Ba ý đáng giữ: nguyên lý quan trọng hơn thuật toán, data mining là nghề có quy trình, dữ liệu là tài sản cần đầu tư.
- Nên đọc trước sách kỹ thuật ML, nhất là khi bạn chuyển từ SWE sang FDE.
Trang chính thức của cuốn sách nói thẳng ngay từ những dòng đầu: đây không phải sách về thuật toán. Một cuốn của O’Reilly có chữ “data mining” ngay trên bìa mà nói vậy thì khá lạ. Với một FDE, đó lại chính là lý do nên đọc nó.
Cuốn sách là Data Science for Business, với phụ đề nói về data mining và tư duy phân tích dữ liệu. Foster Provost và Tom Fawcett viết, O’Reilly Media phát hành năm 2013.
Sách được phát triển từ một môn học đông sinh viên mà Provost dạy ở NYU. Theo NYU Stern, hơn một chục trường đại học ở tám quốc gia đã dùng nó làm giáo trình, và Fortune đưa nó vào danh sách sách bắt buộc phải đọc cho MBA.
Một cuốn sách 13 năm tuổi có ích gì cho FDE năm 2026? Ở chỗ khách, phần khó nhất thường không nằm ở việc chọn model. Nó nằm ở việc biến một câu nói mơ hồ của khách thành một bài toán đo được.
Hai tác giả muốn trình bày những nguyên lý nền tảng để rút ra tri thức hữu ích từ dữ liệu. Họ viết cả cho người không trực tiếp làm, chỉ muốn rèn tư duy phân tích dữ liệu.
Khách mang đến một nỗi lo, không phải một bài toán
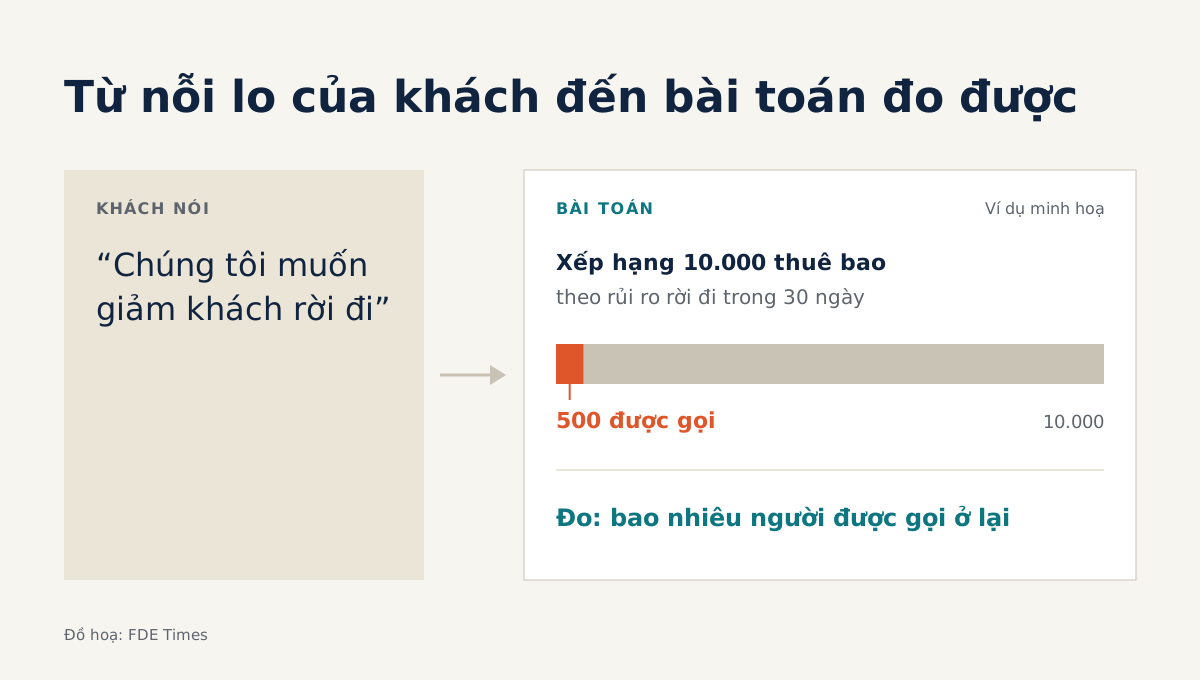
Thử hình dung một công ty bán gói thuê bao nói với bạn: “Chúng tôi muốn giảm khách rời đi”. Câu đó chưa phải bài toán dữ liệu. Nó chưa nói ai sẽ hành động, hành động trong bao lâu, và thế nào thì gọi là thành công.
Hỏi thêm vài câu, bạn biết đội chăm sóc khách hàng chỉ đủ người gọi điện cho 500 trong số 10.000 thuê bao mỗi tháng. Lúc này bài toán đã rõ: xếp hạng 10.000 thuê bao theo khả năng rời đi trong 30 ngày tới, rồi chọn 500 người đáng gọi nhất.
Bài toán có quyết định cụ thể (gọi ai), có mục tiêu đo được (bao nhiêu người trong nhóm được gọi ở lại), và cho bạn biết cần dữ liệu gì (lịch sử thuê bao, ai đã rời đi, rời đi khi nào).
Đó là kiểu tư duy mà sách gọi là “data-analytic thinking”. Theo mô tả của nhà xuất bản, sách minh họa từng nguyên lý bằng các bài toán kinh doanh có thật. Đó là lý do người làm việc với khách thấy sách gần với công việc của mình hơn một giáo trình toán.
Ý thứ nhất: nguyên lý sống lâu hơn thuật toán
Thuật toán thay đổi theo từng năm. Nhưng câu hỏi “quyết định nào sẽ thay đổi nếu ta có câu trả lời này” thì vẫn vậy, dù bạn dùng cây quyết định năm 2013 hay một agent dùng LLM năm 2026. Sách chọn dạy phần không thay đổi đó.
Sinan Aral, giáo sư ở MIT Sloan, nhận xét rằng trong mảng khoa học dữ liệu ứng dụng cho kinh doanh, chưa có cuốn nào vừa uy tín vừa dễ hiểu được như cuốn này.
Với FDE, sự dễ hiểu ấy dùng được ngay: bạn có thêm từ vựng để giải thích cho một giám đốc vận hành vì sao “dự đoán khách rời đi” và “chọn ai để gọi” là hai bài toán khác nhau.
Khi khách đưa yêu cầu, việc đầu tiên nên làm là viết ra quyết định mà kết quả phân tích sẽ ảnh hưởng tới. Nếu chưa viết được câu đó thì cũng chưa nên mở notebook.
Ý thứ hai: data mining có quy trình, không trông vào may rủi
Provost gọi data mining là một craft, tức là việc làm bằng tay nghề chứ không phải bấm nút là xong. Theo thông cáo của O’Reilly, việc này có một quy trình xác định giúp tăng khả năng thành công. Ý đó đáng giá với FDE vì nó gạt bỏ ý nghĩ rằng chỉ cần có dữ liệu và model là kết quả sẽ tự đến.
Quy trình cũng là thứ bạn mang được từ khách này sang khách khác. Ở ví dụ thuê bao, cách đi gồm làm rõ quyết định, định nghĩa “rời đi”, tìm dữ liệu rồi đo kết quả trên đúng 500 cuộc gọi. Ở một ngân hàng hay một công ty logistics, các bước vẫn y như vậy. Chỉ có danh từ là khác.
Bạn nên ghi quy trình của mình thành một checklist ngắn, dùng cho mọi buổi discovery. Sau ba khách hàng, bạn sẽ thấy những lần dự án trượt thường đã trượt từ bước nào.
Ý thứ ba: dữ liệu là tài sản, và tài sản thì tốn tiền
Nhà xuất bản tóm một bài học của sách: hãy coi dữ liệu là tài sản kinh doanh, và phải đầu tư cẩn thận mới thu được giá trị thật. Ở chỗ khách, ý này thường dẫn tới một việc khó mở lời: báo với khách rằng dữ liệu họ đang có chưa đủ.
Quay lại ví dụ trên, giả sử công ty không ghi lại ngày khách hủy gói mà chỉ có trạng thái hiện tại. Khi đó bạn chưa thể xây model.
Việc cần làm trước là đề xuất khách đầu tư ghi lại dữ liệu đó, và nói rõ nó tốn bao nhiêu công. Một FDE nói được điều này ngay từ tuần đầu sẽ tránh được ba tháng hứa hẹn suông.
Câu hỏi phỏng vấn nào lộ ra cách ứng viên nghĩ?
Mô tả của nhà xuất bản nhắc tới một ứng dụng ít người để ý: dùng nguyên lý khoa học dữ liệu khi phỏng vấn ứng viên data. FDE thường phải đánh giá đội data của khách hoặc tham gia tuyển người cho đội mình, nên đây là kỹ năng dùng thật.
Thử hình dung bạn đưa ứng viên đúng tình huống thuê bao ở trên: “Công ty muốn giảm khách rời đi, bạn bắt đầu từ đâu?”. Câu trả lời yếu đi thẳng vào model: thử vài thuật toán, so độ chính xác, chọn cái cao nhất. Nghe rất kỹ thuật, nhưng ứng viên chưa hỏi một câu nào về khách.
Câu trả lời tốt bắt đầu bằng câu hỏi ngược lại: ai sẽ hành động dựa trên kết quả, mỗi tháng gọi được bao nhiêu người, “rời đi” được định nghĩa thế nào, hệ thống có lưu ngày hủy gói không.
Chỉ sau khi biết đội chăm sóc gọi được 500 người, ứng viên mới nói tới việc xếp hạng và đo trên đúng nhóm đó. Một câu hỏi như vậy cho bạn biết nhiều hơn mọi câu đố về thuật toán.
Ai nên đọc, và đọc vào lúc nào
Nếu bạn là kỹ sư phần mềm đang chuyển sang FDE, hãy đọc cuốn này trước các sách kỹ thuật ML. Nếu bạn đã là FDE, hãy đọc lại những phần gắn với loại bài toán khách hay mang đến nhất.
Kỹ năng này cũng nên hiện ra trong CV của bạn. Thay vì ghi “xây model dự đoán churn”, hãy ghi câu hỏi kinh doanh ban đầu, bài toán bạn đã định nghĩa lại và con số đo kết quả. Một dòng như vậy cho người đọc CV thấy cách bạn nghĩ, không chỉ công cụ bạn dùng.
Các model sẽ còn thay đổi nhiều lần nữa. Còn câu hỏi “quyết định nào sẽ thay đổi” thì vẫn là câu đầu tiên bạn nên hỏi khi đến chỗ khách.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!