Khoá Semantic Caching for AI Agents: nên học phần đo lường, đừng tin con số tiết kiệm
Khoá ngắn 1h24m do kỹ sư Redis dạy chỉ bạn cách bớt các lần gọi mô hình bị lặp, nhưng kỹ năng đáng mang tới khách hàng là biết lúc nào cache trả lời sai.

Tóm tắt nhanh
- Khoá Intermediate dài 1h24m của DeepLearning.AI, cả hai giảng viên đều làm ở Redis
- Ba video dài nhất xoay quanh việc đo và cải thiện hiệu quả cache, rồi gắn cache vào agent
- Mức tiết kiệm 'từ 50% trở lên' là con số Redis tự nêu, bạn phải đo lại trên log của khách
Hai khách hàng gõ “Làm sao đổi mật khẩu?” và “Tôi quên mật khẩu, reset kiểu gì?”, và agent của bạn gọi mô hình hai lần chỉ để ra cùng một câu trả lời.
Khoá ngắn Semantic Caching for AI Agents của DeepLearning.AI dạy cách bỏ lần gọi thứ hai. Với FDE, phần đáng học nhất lại nằm ở chỗ khác: biết khi nào lần bỏ qua đó làm khách nhận câu trả lời sai.
Thử hình dung một tình huống quen thuộc: khách hỏi hoá đơn mô hình có giảm được không, và agent có nhanh hơn được không. Cache là câu trả lời dễ nghĩ tới nhất. Nhưng nếu không đo, nó cũng là cách nhanh nhất để đánh mất lòng tin của người dùng cuối.
Ai dạy, và vì sao cần nghe có chọn lọc?
Đây là một Short Course trình độ Intermediate, dài 1h24m theo trang khoá, làm cùng đối tác Redis. Khoá dành cho developer và ML engineer đã quen Python, embedding và ứng dụng LLM cơ bản, không cần biết gì về caching từ trước.
Cả hai giảng viên đều là người của Redis: Tyler Hutcherson, quản lý nhóm Applied AI Engineering, và Iliya Zhechev, Senior Research Engineer. Nhà cung cấp dạy công cụ của mình không có gì sai, miễn là bạn tách được nguyên lý dùng chung khỏi phần quảng bá sản phẩm.
Dùng lại câu trả lời theo nghĩa, không theo chữ
Cơ chế khá gọn. Truy vấn được chuyển thành embedding rồi so cosine similarity với các truy vấn đã lưu. Theo blog của Redis, nếu độ tương đồng vượt ngưỡng, thường trong khoảng 0.85-0.95, hệ thống trả câu trả lời đã lưu và không gọi LLM nữa.
Cái giá cố định của cách này hay bị bỏ qua. Mỗi lần tìm vector tốn thêm 5-20ms, đổi lại một lần hit tiết kiệm được 1-5 giây. Khi miss, người dùng vẫn chờ đủ thời gian của LLM, cộng thêm phần overhead đó, nên cache chỉ có lợi khi lượng truy vấn lặp lại đủ lớn.
Precision quan trọng hơn hit rate
Cách khoá phân bổ thời lượng đã nói lên trọng tâm. Trong 7 video, ba bài dài nhất là “Measuring Cache Effectiveness” (13 phút), “Enhancing Cache Effectiveness” (12 phút) và “Fast AI Agent with Semantic Cache” (16 phút): 41 phút dành cho việc đo, cải thiện, rồi mới gắn cache vào agent.
Ba chỉ số khoá dạy là hit rate, precision và latency. Hit rate cho biết bạn tiết kiệm được bao nhiêu. Precision cho biết trong số đó có bao nhiêu lần trả đúng, phần còn lại là trả sai.
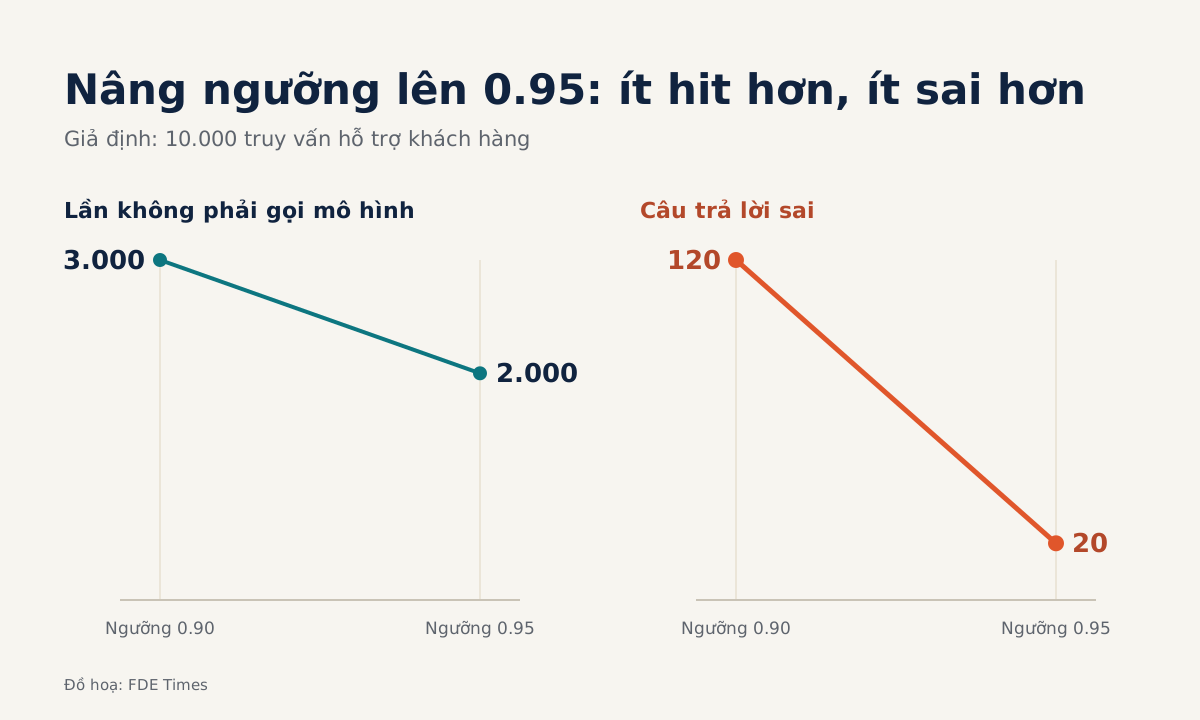
Thử hình dung 10.000 truy vấn hỗ trợ khách hàng ở ngưỡng 0.90, hit rate 30%, tức 3.000 lần không phải gọi mô hình. Nếu 4% số hit đó là false positive, 120 người đã nhận câu trả lời cho một câu hỏi họ không hỏi.
Giờ giả sử bạn nâng ngưỡng lên 0.95, hit rate tụt xuống 20% và false positive còn 1%. Bạn chỉ còn 2.000 lần tiết kiệm, mất 1.000 lần so với trước. Đổi lại, số câu trả lời sai giảm từ 120 xuống 20.
Các con số trong ví dụ là giả định, nhưng phép đổi chác thì có thật, và chỉ log của khách mới cho bạn biết điểm cân bằng nằm ở đâu. Redis khuyên bắt đầu ở ngưỡng 0.90-0.95 và theo dõi false positive. Nếu tỷ lệ này vượt 3-5%, chỉnh ngưỡng không còn đủ, phải đổi kiến trúc.
Việc đầu tiên ở khách vì thế rất cụ thể: lấy một mẫu log thật, gán nhãn các cặp truy vấn cùng nghĩa và khác nghĩa, đo cả hai ngưỡng như trên rồi chọn theo precision. Đừng chọn ngưỡng theo cảm giác trong lúc demo.
Dữ liệu đổi thì cache phải đổi theo
Bản demo hiếm khi đụng tới vấn đề dữ liệu thay đổi. Với dữ liệu biến động nhanh như giá hay tồn kho, Redis gợi ý TTL 5-15 phút, hoặc xoá cache ngay khi nguồn dữ liệu đổi. Nếu không, agent sẽ tự tin báo một mức giá đã hết hiệu lực.
Semantic caching cũng không thay thế prompt caching. Prompt caching dành cho phần ngữ cảnh lớn và cố định, còn semantic caching dành cho các truy vấn lặp lại cùng ý. Redis gọi việc kết hợp hai lớp này là “double caching”, và đáng cân nhắc khi khách vừa có system prompt dài vừa có nhiều câu hỏi lặp lại.
Nên bỏ gì, và nên học theo thứ tự nào?
Thứ nên bỏ là con số. Redis viết rằng các nhóm dùng semantic caching thường giảm chi phí LLM “từ 50% trở lên”, tuỳ mức lặp của truy vấn. Đó là số liệu nhà cung cấp tự nêu, không phải kết quả đo độc lập, nên với khách hãy hứa một phép đo trên log của họ chứ đừng hứa một phần trăm.
Về thứ tự học, bạn có thể xem các video theo trình tự, nhưng nên xem lại hai bài về đo lường và cải thiện hiệu quả trước khi làm project tuỳ chọn 10 phút. Sau đó đọc bài so sánh prompt caching với semantic caching trên blog của Redis để thấy toàn cảnh.
Về nghề nghiệp, một dòng CV kiểu “dựng semantic cache, chọn ngưỡng 0.92 dựa trên precision đo trên tập cặp truy vấn đã gán nhãn, giữ false positive dưới 3%” có sức nặng hơn hẳn câu “có kinh nghiệm với Redis”. Các con số trong câu đó phải là số bạn tự đo.
Khoá học dạy bạn cách làm agent nhanh hơn. Khi khách hỏi “tiết kiệm được bao nhiêu”, câu trả lời chỉ có được từ log của chính họ.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!