Machine Learning in Production của Andrew Ng: 11 giờ học phần việc mà notebook không dạy
Điểm số đẹp ngày bàn giao chưa nói được gì về những tuần sau đó, và khoá học ngắn này cho bạn khung tư duy để lo chuyện ấy ngay từ khâu xác định phạm vi.

Tóm tắt nhanh
- Khoá trung cấp, khoảng 11 giờ, cần Python trung cấp và phù hợp với kỹ sư phần mềm đang hướng tới công việc FDE.
- Ba ý đáng giữ: có baseline trước khi có model, coi drift là việc thường xuyên, và làm dự án có thể tái lập, truy vết, kiểm chứng.
- Khoá cho bạn khung tư duy; năng lực chỉ thành hình khi bạn áp dụng khung đó vào một dự án có số đo thật.
Một model có thể đúng vào ngày bàn giao rồi sai dần từ tuần sau, dù không ai sửa một dòng code. Machine Learning in Production, khoá học của DeepLearning.AI do Andrew Ng giảng, đi thẳng vào nghịch lý đó: khác với modeling thông thường, hệ thống production phải đối phó với dữ liệu biến đổi không ngừng.
Với FDE, chuyện này có thể xảy ra ngay khi bạn đang ở chỗ khách, và câu hỏi đầu tiên sẽ không phải về kiến trúc model mà là “vì sao, và từ bao giờ”.
Khoá này đáng 11 giờ của bạn vì nó dạy thiết kế hệ thống end-to-end, dựng baseline và xử lý concept drift. Phép đo cụ thể cho từng khách thì bạn vẫn phải tự dựng.
Ai nên học, và học theo thứ tự nào?
Ng là người sáng lập DeepLearning.AI và đồng sáng lập Coursera. Khoá học bắt nguồn từ MLOps Specialization ra mắt năm 2021, do ông dạy cùng Robert Crowe và Laurence Moroney của Google, với lý do rằng xây và triển khai hệ thống production vẫn đòi hỏi rất nhiều việc thủ công.
Theo trang chính thức, khoá ở trình độ trung cấp, dài khoảng 11 giờ, thường mất 3 tuần với nhịp 5 giờ mỗi tuần.
Bạn cần biết Python ở mức trung cấp, và khoá được viết cho người mới vào nghề ML hoặc kỹ sư phần mềm. Coursera xếp đây là khoá độc lập, có MLOps và model deployment trong danh sách kỹ năng, điểm đánh giá 4.8.
Tuần 1 nói về vòng đời dự án và deployment, tuần 2 về các thách thức của modeling, tuần 3 về định nghĩa dữ liệu và baseline. Nếu có thời gian, hãy học đúng thứ tự.
Nếu tuần sau đã gặp khách, nên xem tuần 1, nhảy sang tuần 3 rồi mới quay lại tuần 2.
Tuần 2 xoay quanh những khó khăn của chính việc xây model, nên chưa gấp: buổi đầu bạn chưa có model, còn baseline thì cần ngay để biết model sau này phải vượt mốc nào.
Chỉ là hoãn chứ không bỏ, nên hãy học tuần 2 trước khi bắt tay huấn luyện.
Cũng nên biết khoá này không dạy gì. Đề cương ba tuần không dành tuần nào riêng cho LLM hay agent, nên ai đang làm RAG cho khách sẽ nhận được cách nghĩ về vận hành chứ chưa có công thức dùng ngay.
Baseline là câu trả lời đầu tiên cho khách
Khoá học dạy thiết kế end-to-end, từ phạm vi dự án, nhu cầu dữ liệu, chiến lược modeling đến yêu cầu deployment, và dạy dựng baseline cho model. Ý này đáng giữ nhất, vì nó đổi cả cuộc nói chuyện với khách.
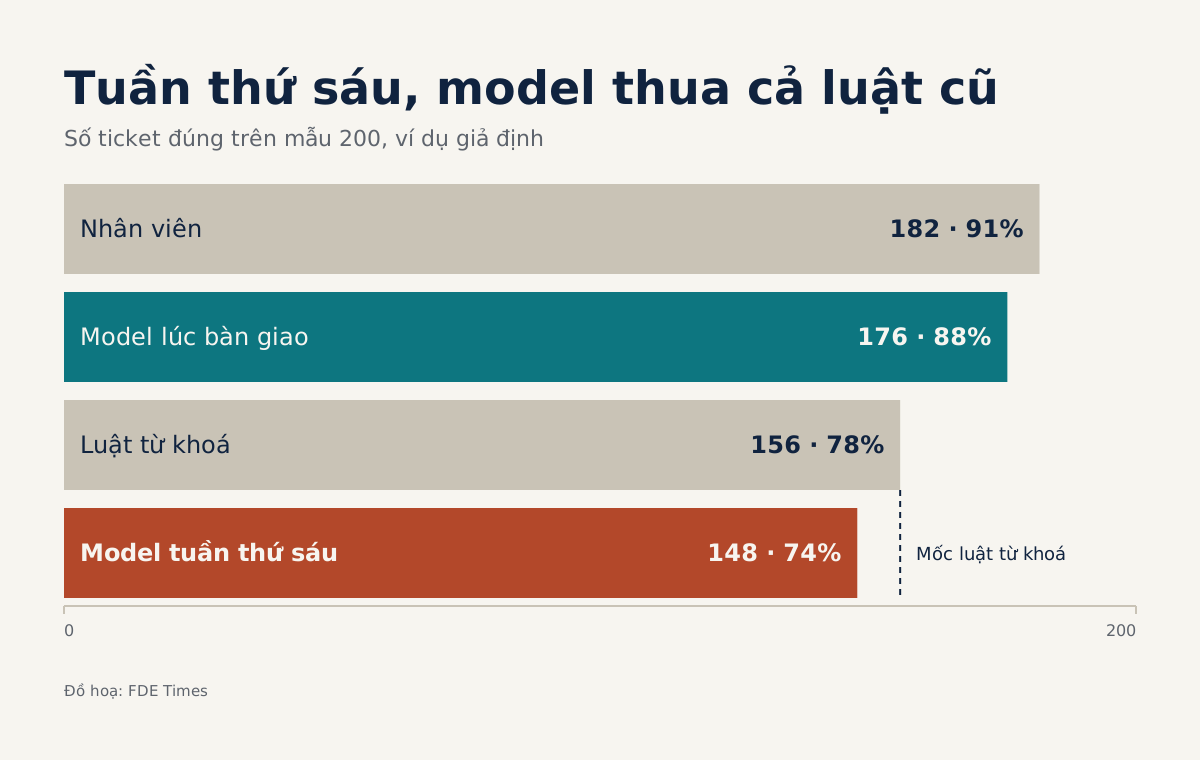
Thử hình dung một công ty muốn tự động định tuyến ticket hỗ trợ. Bạn lấy 200 ticket đã gán nhãn: luật từ khoá hiện tại đúng 156 (78%), nhân viên đúng 182 (91%), model của bạn đúng 176 (88%). Đứng một mình, 88% chẳng nói lên điều gì. Đặt cạnh hai mốc kia, nó hơn luật 20 ticket nhưng vẫn thua người 6 ticket.
Lúc này cuộc họp có câu hỏi đáng bàn: cứ 200 ticket lại sai thêm 6, đổi lại nhân viên đỡ được bao nhiêu thời gian, và khách có chấp nhận không? Vì thế, khi đến chỗ khách, hãy xin mẫu dữ liệu thật và đo cách họ đang làm trước, rồi mới mở notebook.
Drift là việc thường ngày, không phải sự cố
Trong bài giới thiệu năm 2021, Ng xếp việc phát hiện và sửa lỗi dữ liệu, nhận ra data drift và concept drift vào nhóm nhiệm vụ của MLOps. Hai loại drift dễ bị gộp làm một, nhưng cách xử lý khác nhau.
Quay lại ví dụ ticket. Khách ra sản phẩm mới, ticket xuất hiện những từ model chưa từng thấy: đầu vào đã đổi, đó là data drift. Cách sửa là gán nhãn một lô ticket về sản phẩm mới, thêm vào tập huấn luyện rồi huấn luyện lại; nhãn cũ vẫn đúng nên vẫn giữ được.
Rồi khách tổ chức lại phòng ban, khiếu nại thanh toán chuyển sang đội khác: ticket y như cũ nhưng đáp án đúng đã đổi, đó là concept drift. Thêm dữ liệu kiểu cũ không cứu được, vì chính nhãn cũ đã sai. Phải sửa nhãn theo sơ đồ phòng ban mới hoặc bỏ các mẫu lỗi thời trước khi huấn luyện lại.
Muốn thấy sớm cả hai, hãy dựng một phép đo hằng tuần. Mỗi tuần lấy ngẫu nhiên 200 ticket mới, nhờ nhân viên của khách gán nhãn mà không nhìn đáp án của model, rồi đếm số ticket model làm đúng.
Ghi con số đó cạnh hai mốc đã có: 176 ticket lúc bàn giao và 156 ticket của luật từ khoá. Có thể đặt sẵn ngưỡng: dưới 168 (84%) thì điều tra, dưới 156 (78%) thì bàn với khách việc tạm quay lại luật cũ.
Giả sử đến tuần thứ sáu, mẫu chỉ còn đúng 148 ticket, tức 74%, thấp hơn cả luật từ khoá mà model được mua về để thay thế. Hãy đọc 52 ticket sai: nhiều từ mới thì nghiêng về data drift, còn ticket quen mà đáp án đã đổi thì nghiêng về concept drift.
Không có phép đo này, bạn sẽ biết chuyện từ cuộc gọi phàn nàn của khách. Vì thế hãy thoả thuận ngay từ đầu ai gán nhãn mẫu và ai nhận cảnh báo.
Không lần lại được thì không bảo vệ được kết quả
Mục tiêu khoá học nêu rõ là một dự án ML có thể tái lập, truy vết và kiểm chứng cho production. Nghe khô khan, cho đến khi khách hỏi vì sao hôm thứ Ba ticket của họ bị chuyển sai đội, mà bạn không biết khi đó model nào đang chạy, trên dữ liệu nào.
Cách bắt đầu rất rẻ: mỗi lần deploy ghi lại phiên bản dữ liệu, commit code và kết quả đánh giá. Ba dòng đó biến một cuộc tranh cãi thành một cuộc điều tra có đầu mối.
Khoá học còn đặt ra một ràng buộc mà FDE nên đọc thật kỹ: hệ thống phải chạy không ngừng, với chi phí tối thiểu và hiệu năng tối đa. Trên thực tế ba đích này kéo nhau, nên yêu cầu deployment chỉ thực sự xong khi khách đã nói rõ họ ưu tiên gì và chấp nhận hy sinh gì.
Biến 11 giờ thành bằng chứng khi đi xin việc
Đừng dừng lại ở tấm chứng chỉ. Hãy dùng khung này trên một bài toán có số đo, kể cả bài toán tự chọn với dữ liệu công khai, để có thứ cụ thể mà kể.
Hãy viết một dòng CV theo mẫu: đo baseline, kết quả so với baseline, cách phát hiện drift. Khi đọc mô tả công việc FDE, chú ý các từ như model deployment, MLOps, drift, rồi chuẩn bị sẵn một câu chuyện cho từng từ.
Phỏng vấn mà kể được lúc model tụt xuống dưới baseline và bạn đã làm gì, người nghe sẽ hiểu bạn không chỉ biết huấn luyện model.
Khoá học chỉ mất ba tuần, nhưng phép thử của nó đến muộn hơn: vào tuần thứ sáu ở chỗ khách, khi dữ liệu đã đổi còn bạn vẫn phải trả lời bằng số.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!