Đọc sách Site Reliability Engineering của Google như một FDE: SLO, error budget và postmortem
Không hệ thống nào giữ nổi lời hứa "sẽ không bao giờ sập". Cuốn sách năm 2017 này dạy bạn đổi lời hứa đó thành một con số mà cả bạn lẫn khách hàng đều đo được.
Tóm tắt nhanh
- Sách do Google giữ bản quyền, O'Reilly Media xuất bản năm 2017, đọc trực tuyến tại sre.google.
- FDE nên đọc trước chương 3, chương 4 và chương 15, rồi xem chính sách error budget mẫu trong SRE Workbook.
- Ba ý đáng giữ: mục tiêu 100% là sai, SLO nên bắt đầu lỏng rồi siết dần, postmortem để học chứ không để phạt.
Betsy Beyer, một trong bốn người biên tập cuốn sách, nói thẳng về chính sách error budget: nó phải rõ ràng, phải được viết ra và phải được thống nhất từ trước. Nói cách khác, quy tắc “hỏng quá mức thì làm gì” phải có trước khi hệ thống hỏng, không phải đợi hỏng rồi mới bàn.
Một Forward Deployed Engineer gặp đúng câu hỏi đó ở mọi khách hàng. Bạn đưa hệ thống vào production, khách hàng hỏi “nó có ổn định không”, mà câu trả lời “khá ổn” thì không ai đo được.
Cuốn sách dày, nhưng FDE không cần đọc hết. Phần dưới đây chọn ra những chương đáng đọc nhất cho công việc ở khách hàng, thứ tự nên đọc, và ba ý nên mang theo khi bước vào phòng họp.
Một cuốn sách Google viết về cách mình vận hành
Sách do Google giữ bản quyền, O’Reilly Media xuất bản năm 2017, và đọc được trực tuyến tại sre.google. Nhóm biên tập gồm Betsy Beyer, Chris Jones, Jennifer Petoff và Niall Richard Murphy.
Có một điều bạn nên biết trước. Một bài review của người làm nghề nhận xét đây không phải cuốn dễ đọc, nhưng vẫn khuyên hầu hết kỹ sư, dù làm SRE hay không, nên đọc.
Vì thế đừng đọc từ trang đầu đến trang cuối. Với FDE, thứ tự hợp lý là chương 3 (Embracing Risk), chương 4 (Service Level Objectives), rồi chương 15 (Postmortem Culture: Learning from Failure). Sau đó, sang SRE Workbook đọc ví dụ chính sách error budget.
Vì sao 100% là mục tiêu sai?
Chương 3 lập luận rằng 100% gần như không bao giờ là mục tiêu độ tin cậy đúng. Thay vào đó, sách đưa ra error budget. Theo các tác giả, nó đặt đội SRE và đội phát triển sản phẩm về cùng một phía: hai bên có chung lợi ích và cùng giữ một ngân sách lỗi.
Ở khách hàng, hai phía đó thường là bạn và đội vận hành của họ. Bạn muốn ship tính năng mới mỗi tuần; họ muốn không ai đụng vào hệ thống. Error budget biến cuộc cãi nhau cảm tính thành một phép trừ.
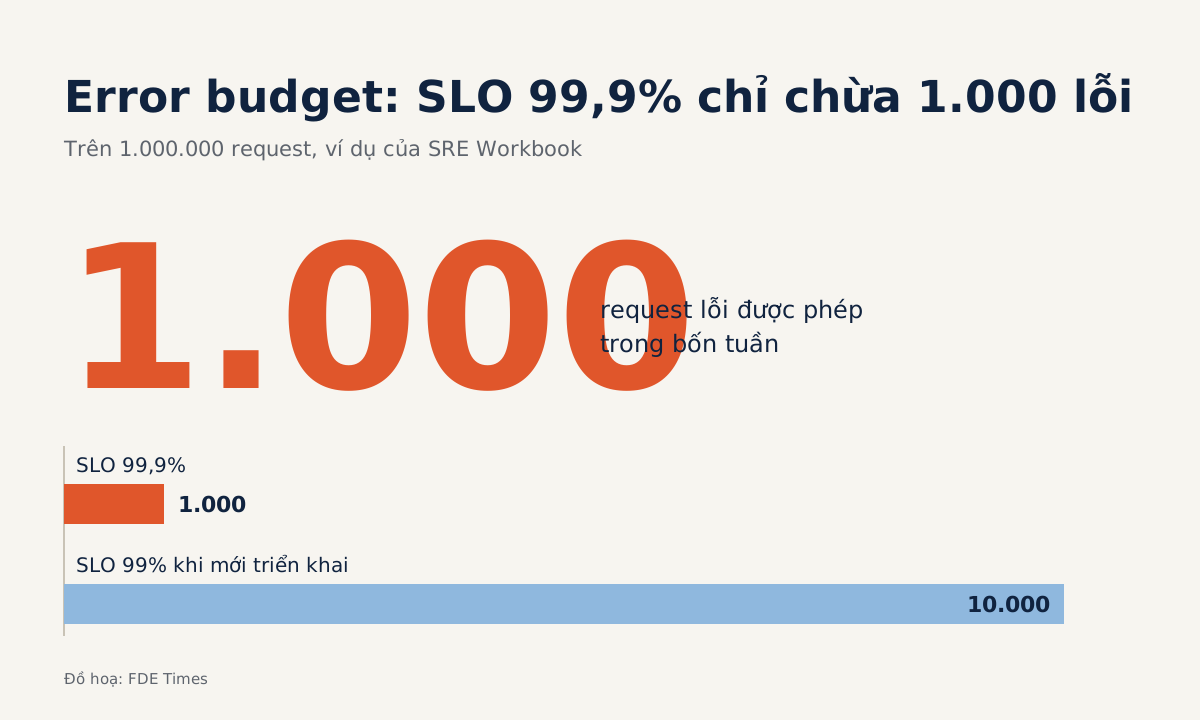
SRE Workbook đưa ra phép tính cụ thể: SLO khả dụng 99,9% nghĩa là budget 0,1%. Nếu dịch vụ nhận 1.000.000 request trong bốn tuần, bạn được phép có 1.000 request lỗi trong khoảng đó.
Còn budget thì cứ release. Hết budget thì chính sách mẫu yêu cầu dừng mọi thay đổi và release, trừ sự cố P0 và bản vá bảo mật.
Đó cũng là lý do Beyer nhấn mạnh việc thống nhất trước. Việc đầu tiên nên làm ở khách hàng là viết quy tắc dừng release này thành văn bản và để cả hai bên đồng ý với nó, trước khi có sự cố.
SLI, SLO và cái bẫy đặt mục tiêu quá chặt
Chương 4 tách bạch ba khái niệm hay bị dùng lẫn. SLI là con số đo một mặt cụ thể của dịch vụ, và phải được định nghĩa thật cẩn thận. SLO là mức bạn muốn con số đó đạt tới, có thể là một ngưỡng hoặc một khoảng; còn SLA là cam kết với người dùng, kèm hệ quả khi đạt hay trượt các SLO trong đó.
Thiếu sự phân biệt này, cuộc họp với khách hàng dễ trôi thành tranh luận cảm tính. “Hệ thống nhanh” không phải SLI. “Tỷ lệ request trả về dưới một ngưỡng độ trễ, đo ở load balancer” mới là SLI; con số phần trăm bạn đặt cho nó là SLO.
Lời khuyên thực dụng nhất của chương nằm ở một câu: nên bắt đầu với mục tiêu lỏng rồi siết dần. Với FDE, điều này rất đáng nhớ, vì khách hàng thường đòi con số đẹp ngay từ tuần đầu, khi bạn chưa có dữ liệu nền.
Thử hình dung tuần đầu triển khai một API ở khách hàng. Bạn chưa biết hệ thống thực sự chạy ra sao, nên đặt SLO 99% cho bốn tuần đầu: với 1.000.000 request, budget là 10.000 lỗi, đủ rộng để đội học cách vận hành mà không phải dừng release liên tục.
Hết bốn tuần, giả sử dữ liệu cho thấy tỷ lệ thành công thực tế luôn quanh 99,95%. Lúc này bạn có cơ sở để siết SLO nội bộ lên 99,9%, tức budget còn 1.000 lỗi, trong khi con số cam kết với khách hàng vẫn giữ ở mức thấp hơn.
Khoảng chênh đó là chủ ý. Sách khuyên giữ SLO nội bộ chặt hơn SLO công bố cho người dùng, để còn chỗ xử lý các vấn đề kéo dài trước khi chạm vào lời hứa với khách hàng.
Postmortem: sửa hệ thống, không sửa người
Chương 15 coi postmortem blameless là nền tảng của văn hóa SRE: viết postmortem không phải hình phạt mà là cơ hội học cho cả công ty. Chương cũng khuyên định nghĩa tiêu chí khi nào cần postmortem trước khi sự cố xảy ra.
Thử hình dung một sự cố ngay sau khi bạn đưa bản cập nhật vào hệ thống của khách hàng: API trả lỗi trong 40 phút vì một file cấu hình sai.
Bản postmortem kiểu đổ lỗi sẽ ghi: “Nguyên nhân: kỹ sư triển khai đẩy cấu hình sai lên production mà không kiểm tra.” Đọc xong, hành động duy nhất là “lần sau cẩn thận hơn”, và lần sau lỗi vẫn lặp lại.
Bản blameless kể cùng sự việc nhưng hỏi vì sao hệ thống cho phép nó xảy ra. “Nguyên nhân: pipeline cho phép đẩy cấu hình lên production mà không qua bước kiểm tra tự động; không có rollout từng phần nên lỗi chạm tới toàn bộ người dùng.” Hành động đi kèm giờ là việc cụ thể: thêm bước validate bắt buộc, rollout theo từng nhóm nhỏ.
Bản thứ hai không khiến ai phải chống chế, kể cả đội khách hàng, nên mọi người dám kể đúng chuyện đã xảy ra. Beyer cũng cho rằng đổ lỗi chỉ khiến sự thật bị che đi. Khi viết, hãy rà phần nguyên nhân: câu nào có chủ ngữ là một con người, viết lại cho chủ ngữ là một quy trình hay một công cụ.
Biến ba chương thành một dòng trong CV
Khi chuẩn bị ứng tuyển FDE, đừng dừng ở việc ghi rằng bạn đã đọc sách SRE. Hãy cho thấy bạn đã đưa hệ thống vào production và giữ nó chạy ổn định ra sao.
Kỹ năng này có xuất hiện trong tin tuyển dụng thật. Một tin tuyển vị trí Deployed Engineer của Paladin Drones yêu cầu tham gia xử lý sự cố, nộp RCA trong thời hạn SLA, duy trì SLO và theo dõi các hành động khắc phục đến khi đóng.
Khi đọc mô tả công việc, cứ thấy chữ sự cố, RCA hay SLO là bạn có chỗ đem ba chương này ra nói.
Trong CV, hãy viết một dòng cụ thể kiểu “đặt SLO và chính sách error budget cho hệ thống triển khai tại khách hàng, dẫn dắt postmortem blameless dẫn tới thay đổi quy trình release”. Trong phỏng vấn, hãy sẵn sàng đi qua một phép tính budget như ví dụ 99,9% ở trên, và kể lại một sự cố theo cách viết blameless.
Làm được phép trừ đó trên bảng trắng có sức nặng hơn nhiều so với dòng “đã đọc sách SRE”.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Google SRE - Site reliability engineering book (Table of Contents)
- Chapter 4 - Service Level Objectives, Google SRE Book
- Chapter 3 - Embracing Risk, Google SRE Book
- Example Error Budget Policy, Google SRE Workbook · 2018-02-19
- Chapter 15 - Postmortem Culture: Learning from Failure, Google SRE Book
- Interview with Betsy Beyer, Stephen Thorne of Google · 2018-10-09
- Book Review: Site Reliability Engineering · 2020-05-12
- Deployed Engineer - Paladin Drones (Built In)