Khoá LLMOps của DeepLearning.AI và Google Cloud: học gì trong 1 giờ 31 phút, và bỏ gì khi khách không dùng GCP
Khoá học dạy trên BigQuery và Google Cloud, nhưng thứ đáng mang tới chỗ khách là một pipeline fine-tuning chạy lại được và có version cho từng thứ.
Tóm tắt nhanh
- LLMOps là short course của DeepLearning.AI, làm cùng Google Cloud, do Erwin Huizenga dạy; trang khoá học hiện ghi thời lượng 1 giờ 31 phút.
- Phần lõi là sửa một pipeline supervised fine-tuning mã nguồn mở, có đánh version dữ liệu và model.
- Gặp khách không dùng GCP thì thay BigQuery bằng kho dữ liệu của khách và giữ lại Kubeflow Pipelines, vốn chạy được trên mọi backend tương thích KFP.
Một bản fine-tune mới bắt đầu trả lời khách tệ hơn bản tuần trước. Nếu không biết nó được train trên bộ dữ liệu nào, bạn chỉ còn cách đoán. Khoá LLMOps của DeepLearning.AI ra đời để dạy cách tránh đúng tình huống này, và học hết chưa tới hai giờ.
Khoá được công bố ngày 17/1/2024, làm cùng Google Cloud. Người dạy là Erwin Huizenga, lúc ra mắt giữ chức Machine Learning Technical Lead tại Google. Analytics India Magazine đưa tin rằng khoá miễn phí khi phát hành, còn trang khoá học tại deeplearning.ai/short-courses/llmops được cập nhật lần cuối ngày 8/10/2025.
Với FDE, giá trị của khoá không nằm ở bộ công cụ Google. Khách của bạn có thể chạy AWS, Azure hoặc một cụm Kubernetes tự dựng. Vì vậy, khi xem từng bài, hãy luôn hỏi: phần nào là thói quen làm việc mang sang được khách khác?
Ba bài 21 phút mới là phần lõi
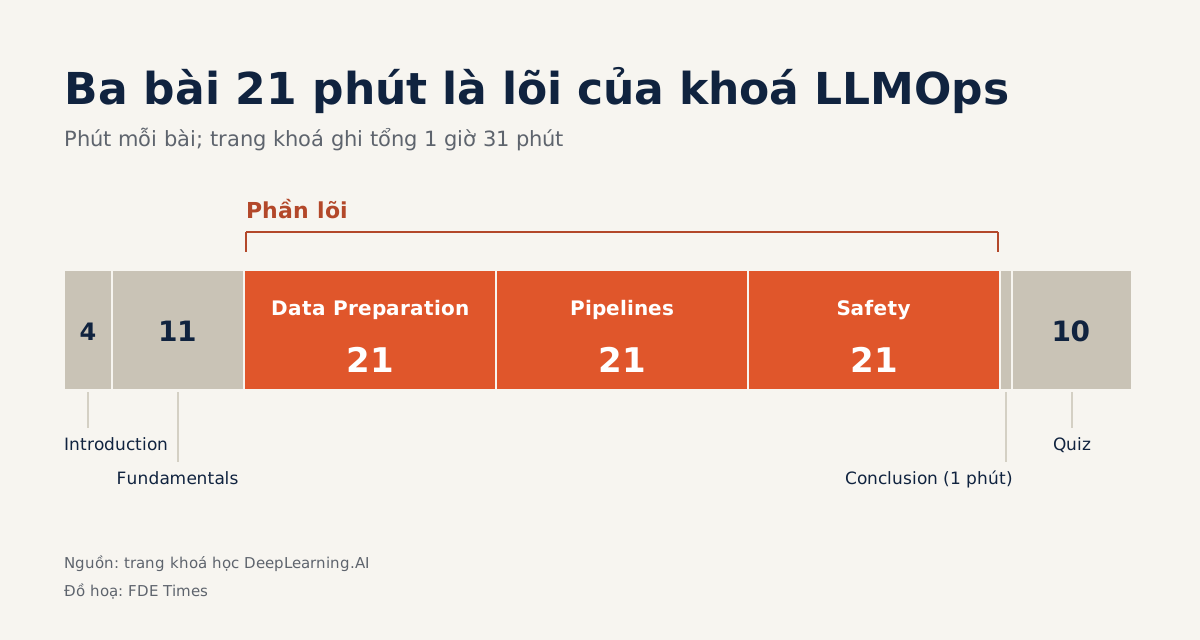
Trang khoá học ghi 1 giờ 31 phút, chia thành Introduction 4 phút, Fundamentals 11, Data Preparation 21, Automation and Orchestration with Pipelines 21, Prediction, Prompts, Safety 21, Conclusion 1 và một bài quiz 10 phút.
Mục tiêu chính được trang khoá học nêu rõ: sửa một pipeline mã nguồn mở dùng supervised fine-tuning để LLM trả lời câu hỏi người dùng tốt hơn. Bạn học trên BigQuery, Kubeflow Pipelines và Google Cloud.
Ý thứ nhất: pipeline có giá trị hơn notebook
Bài Automation and Orchestration with Pipelines dạy cách biến các bước rời rạc thành một luồng chạy tự động. Ở chỗ khách, khác biệt này quyết định việc bàn giao: notebook chỉ người viết ra mới chạy lại được, còn pipeline thì đội của khách cũng chạy lại được sau khi bạn rời dự án.
Kubeflow Pipelines, theo tài liệu chính thức, là nền tảng để dựng và triển khai workflow ML chạy được ở nhiều môi trường và dễ mở rộng khi quy mô tăng. Nó dựa trên container và chạy trên Kubernetes. Pipeline sau khi compile có thể chạy trên mọi backend tương thích KFP, và Vertex AI Pipelines của Google chỉ là một trong số đó.
Ý thứ hai: đánh version cả dữ liệu lẫn model
Khoá học coi việc đánh version dữ liệu và model là best practice, và báo chí cũng nhấn mạnh điểm này khi đưa tin. Một repo ghi chú không chính thức trên GitHub (ksm26/LLMOps) cho thấy bài lab này làm bằng Kubeflow, theo dõi từng lần thử tuning, chứ không dùng dịch vụ độc quyền nào của GCP.
Quay lại tình huống ở đầu bài, giả sử model v3 kém hơn v2. Nếu mỗi lần chạy đều gắn với một version dataset, bạn so được ngay hai bộ dữ liệu và có thể phát hiện, chẳng hạn, đợt export mới đã lẫn các ticket chưa được xử lý. Không có version, cuộc họp với khách sẽ thành buổi đoán mò.
Ý thứ ba: an toàn là một con số được ghi lại
Bài Prediction, Prompts, Safety dạy cách xuất điểm an toàn cho từng nhóm nội dung độc hại. Mỗi nhóm có điểm riêng, chứ không bị gộp thành một nhãn “an toàn/không an toàn”. Chính chi tiết này biến an toàn thành thứ thương lượng được với khách.
Thử hình dung một ngân hàng, với các nhóm và con số chỉ để minh hoạ. Họ chặn câu trả lời khi điểm ngôn từ thù ghét từ 0,3 trở lên, quấy rối từ 0,5, còn nội dung nguy hiểm, như hướng dẫn lách quy trình xác minh, chỉ cần từ 0,2 là chặn, vì đó là rủi ro họ sợ nhất.
Giờ một câu trả lời nhận điểm 0,1 cho thù ghét, 0,2 cho quấy rối và 0,35 cho nội dung nguy hiểm. Lấy trung bình ba nhóm chỉ ra khoảng 0,22, trông như vô hại. Nhưng xét theo từng nhóm, nó vượt ngưỡng 0,2 của nhóm nguy hiểm và bị chặn: đó là thứ một nhãn gộp chung sẽ bỏ sót.
Vì thế, hãy đưa bảng ngưỡng theo nhóm vào tiêu chí nghiệm thu ngay từ đầu dự án, để khách ký duyệt từng con số, thay vì hứa chung chung rằng model “an toàn”.
Khách không dùng GCP thì bỏ gì, giữ gì?
BigQuery và nền tảng Google Cloud là phần gắn với một hãng. Khi khách dùng kho dữ liệu khác, bạn thay bước đọc dữ liệu trong bài Data Preparation bằng kho của họ. Logic làm sạch và định dạng dữ liệu thì giữ nguyên.
Kubeflow Pipelines thì giữ lại, vì nó là mã nguồn mở và chạy được trên bất kỳ backend tương thích KFP nào. Việc đầu tiên nên làm ở chỗ khách là hỏi đội hạ tầng xem họ đã có cụm Kubernetes chưa, rồi mới quyết định dùng KFP hay chuyển các bước sang công cụ orchestration họ đang dùng.
Còn đánh version và chấm điểm an toàn là cách làm, không phụ thuộc công cụ, nên mang theo ở mọi dự án.
Ai nên học, học theo thứ tự nào?
Khoá hợp với kỹ sư đã gọi API LLM nhưng chưa từng đưa một bản fine-tune lên production. Nên xem Fundamentals trước, sau đó học Data Preparation và Pipelines liền một buổi vì hai bài nối tiếp nhau, rồi mới đến Safety. Nếu đã quen MLOps cổ điển, bạn có thể lướt nhanh phần nền tảng.
Về nghề, khi đọc JD FDE hay applied AI, hãy để ý các từ khoá như pipeline orchestration, Kubeflow, model versioning. Trong CV, một dòng như “dựng pipeline fine-tune chạy lại được, có version cho dữ liệu và model, kèm ngưỡng an toàn theo nhóm nội dung” có sức nặng hơn nhiều so với một chứng chỉ khoá học.
Bài tập sau khi học xong
Lấy pipeline trong khoá và giả định khách của bạn không dùng GCP. Viết lại trên một trang: bước nào đổi sang kho dữ liệu của khách, bước nào giữ nguyên trên KFP, mỗi lần chạy ghi những ID version nào, và bảng ngưỡng an toàn theo nhóm bạn sẽ đưa khách ký.
Nếu trang đó đủ rõ để một kỹ sư bên khách tự chạy lại mà không cần hỏi bạn, bạn đã học được điều khoá học thật sự muốn dạy. Và câu hỏi “bản này được train trên dữ liệu nào?” thì khách nào cũng sẽ hỏi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!