ChatGPT Prompt Engineering for Developers: 100 phút để FDE gọi LLM từ code
Một khoá ngắn từ năm 2023 vẫn là chỗ dễ bắt đầu nhất cho kỹ sư muốn biến prompt thành một hàm có thể kiểm thử, rồi mang hàm đó đến khách hàng.

Tóm tắt nhanh
- Khoá của DeepLearning.AI làm cùng OpenAI, phần lớn nội dung do Isa Fulford (OpenAI) soạn, Andrew Ng dẫn dắt; khoảng 1 giờ 40 phút, chỉ cần Python cơ bản.
- Thứ đáng giữ nhất là cách làm: coi prompt như code, sửa nó qua từng vòng lặp, rồi dùng cho bốn kiểu việc lặp lại mãi ở chỗ khách hàng.
- Học xong trong một buổi tối, rồi tự làm một dự án nhỏ có dữ liệu thật để bỏ vào CV.
Khoá học chỉ dài khoảng 1 giờ 40 phút, gồm 9 video và 7 code example. Với một kỹ sư chưa từng gọi mô hình ngôn ngữ lớn từ code, đó có thể là lần đầu họ rời khung chat. ChatGPT Prompt Engineering for Developers của DeepLearning.AI dạy đúng một việc đó và dạy khá gọn.
Rời khung chat là bước mà FDE nào cũng phải qua. Ở chỗ khách hàng, chẳng ai trả tiền để bạn chat giỏi. Họ cần một đoạn code chạy trên dữ liệu của họ, chạy lặp lại được và sửa được khi kết quả sai.
Ai dạy, và khoá có từ bao giờ?
Trang khoá học ghi tên hai người. Isa Fulford là Member of Technical Staff tại OpenAI. Andrew Ng là nhà sáng lập DeepLearning.AI và đồng sáng lập Coursera. Theo I Programmer, Ng là người dẫn dắt, còn phần nội dung cốt lõi là của Fulford, tức là do một người ở OpenAI soạn.
Khoá ra mắt khoảng cuối tháng 4 hoặc đầu tháng 5/2023. Ngày 3/5/2023, một bài trên diễn đàn OpenAI Developer Community viết rằng khoá mới ra được vài ngày. Lúc ra mắt, khoá được DeepLearning.AI và OpenAI cho học miễn phí.
Ba năm là khá lâu trong ngành này, nên đừng coi từng dòng code mẫu là chuẩn API hiện tại. Thứ còn giá trị là cách nghĩ. Trang khoá học nói nó dành cho người mới, chỉ cần biết Python cơ bản. DeepLearning.AI cũng viết rằng kỹ sư machine learning nhiều kinh nghiệm muốn tiếp cận những gì mới nhất của prompt engineering vẫn học được khoá này.
Khoá đi theo thứ tự nào?
Có chín bài: Introduction, Guidelines, Iterative, Summarizing, Inferring, Transforming, Expanding, Chatbot, Conclusion, cuối cùng là một bài quiz có chấm điểm. Theo mô tả của I Programmer, khoá mở đầu bằng hai nguyên tắc viết prompt, sang phần sửa prompt qua nhiều vòng, rồi đến bốn use case, và kết thúc bằng bài dựng một chatbot riêng.
Thứ tự đó hợp lý, và bạn nên học đúng như vậy. Nếu nhảy thẳng tới bài Chatbot vì thấy hấp dẫn, bạn sẽ bỏ lỡ bài Iterative. Đó lại là bài sát với công việc FDE nhất.
Prompt nằm trong code, không nằm trong khung chat
Theo trang khoá học, nội dung gồm các best practice khi viết prompt và cách đưa API của LLM vào ứng dụng. Vế sau mới là chỗ đáng giữ. Khi prompt nằm trong một hàm Python, nó có đầu vào, đầu ra, và chạy được trên một nghìn bản ghi chứ không chỉ một.
Thử hình dung một khách hàng có hàng trăm ticket hỗ trợ mỗi ngày. Bản demo trong khung chat chỉ cho thấy mô hình xử lý được một ticket. Một hàm summarize_ticket(text) thì cho thấy nó có xử lý được cả ngày hôm qua hay không. Đó cũng là thứ khách hàng sẽ hỏi bạn.
Đừng mong viết đúng prompt ngay lần đầu
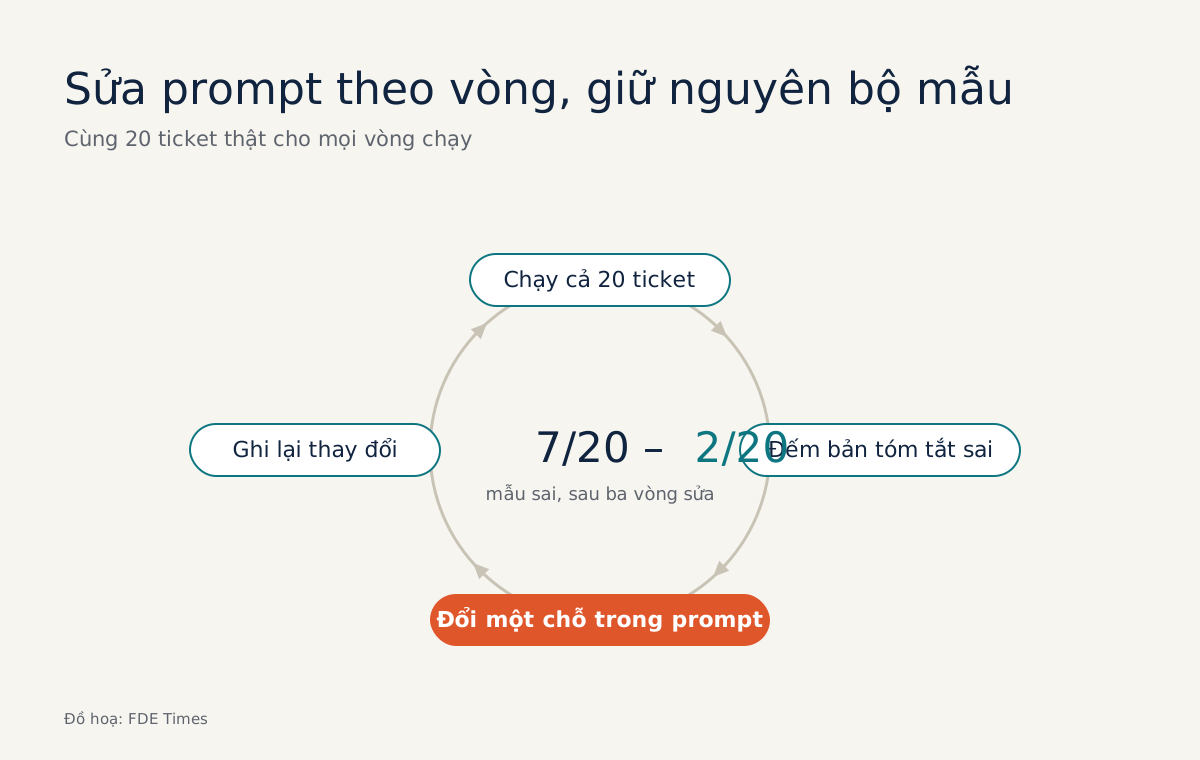
Khoá dành hẳn một bài cho việc sửa prompt qua nhiều vòng. Bài học thực dụng rút ra từ đó: prompt là thứ được chỉnh dần, không phải viết một lần là xong. Ở chỗ khách hàng, cách làm này cần một bộ mẫu cố định để so sánh giữa các vòng.
Lấy 20 ticket thật làm bộ mẫu. Vòng đầu, giả sử 7 bản tóm tắt bỏ sót mã đơn hàng. Bạn thêm một yêu cầu rõ ràng vào prompt rồi chạy lại cả 20 ticket. Ghi lại số lỗi sau mỗi vòng, bạn sẽ có một con số để báo cáo thay vì một cảm giác.
Sửa prompt thì hay sai ở đâu?
Lỗi phổ biến nhất là chỉ chạy lại 7 ticket hỏng. Chúng có thể đã ổn, nhưng câu yêu cầu mới lại làm hỏng vài bản tóm tắt trước đó đang đúng, và bạn sẽ không biết nếu không chạy lại cả 20.
Lỗi thứ hai là đổi nhiều thứ một lúc: thêm yêu cầu về mã đơn hàng, đổi giọng văn, rút ngắn độ dài, tất cả trong một vòng. Số lỗi có giảm thì bạn cũng không biết chỉnh sửa nào có tác dụng. Mỗi vòng chỉ đổi một chỗ, và ghi lại chỗ đó.
Lỗi thứ ba là đổi bộ mẫu giữa chừng. Nếu vòng sau chạy trên 20 ticket khác, con số 7 của vòng đầu không còn để so sánh với cái gì nữa.
Bốn kiểu việc gặp ở mọi khách hàng
Bốn bài Summarizing, Inferring, Transforming và Expanding nghe như bài tập, nhưng thực ra chúng ứng với những yêu cầu bạn sẽ gặp đi gặp lại trong các dự án deployment.
Vẫn lấy ví dụ đội hỗ trợ: tóm tắt ticket dài, suy ra cảm xúc hoặc loại vấn đề, chuyển văn bản sang ngôn ngữ hay định dạng khác, và mở rộng vài ý thành bản nháp trả lời khách.
Khi ngồi customer discovery, bạn có thể dùng bốn kiểu này làm câu hỏi: trong quy trình của họ, chỗ nào đang có người đọc để tóm tắt, phân loại, chuyển đổi hoặc viết nháp? Câu trả lời thường cho bạn use case đầu tiên. Bài Chatbot khép lại khoá bằng việc dựng một chatbot riêng từ mô hình ngôn ngữ.
Ai nên học, và học xong thì làm gì?
Nếu bạn là software engineer chưa từng gọi API của LLM, hãy học khoá này trước mọi khoá về agent hay RAG. Nếu đã quen API, bạn có thể xem lướt các bài use case, nhưng vẫn nên làm kỹ bài Iterative.
Về CV, chứng chỉ của một khoá 100 phút không nói lên nhiều. Một kết quả cụ thể nói được nhiều hơn, chẳng hạn một dòng kiểu “viết script phân loại ticket bằng LLM API, giảm lỗi từ 7/20 xuống 2/20 sau ba vòng sửa prompt”, kèm link tới nhật ký sửa prompt trên GitHub.
Khi đọc JD, hãy để ý những cụm như “prototype with LLM APIs” hay “iterate with customers”, vì khoá này chính là bước đầu của những việc đó.
Một buổi tối là học xong khoá. Phần còn lại, tức chạy prompt trên dữ liệu thật và đếm xem nó sai bao nhiêu lần, là phần bạn phải tự làm.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!