Build a Large Language Model (From Scratch): tự viết GPT trong 368 trang để hiểu model bạn mang đến cho khách
Đọc cuốn sách của Sebastian Raschka không biến bạn thành nhà nghiên cứu, nhưng giúp bạn trả lời được những câu khách hay hỏi về latency, fine-tuning và cách đo kết quả.
Tóm tắt nhanh
- Sách dày 368 trang, Manning xuất bản tháng 09/2024. Các chương 2 đến 7 đi từ dữ liệu văn bản, attention, ráp GPT, pretraining đến hai kiểu fine-tuning.
- Code trong repo chính thức chạy được trên laptop thường. KV cache nằm trong phần bonus của chương 4, LoRA ở phụ lục E.
- Sách khó và tốn thời gian hơn bạn nghĩ. Đọc kỹ chương 2-4, sau đó chọn chương 6 hoặc 7 tùy loại bài toán khách hay gặp.
Thử hình dung một khách hàng hỏi bạn: tại sao prompt dài hơn thì chi phí tính toán lại tăng nhanh hơn độ dài prompt? Nếu bạn mới chỉ gọi model qua API, câu trả lời sẽ khá mơ hồ. Nếu bạn đã tự viết cơ chế attention, bạn vẽ được nó lên bảng trắng trong hai phút.
Cuốn Build a Large Language Model (From Scratch) của Sebastian Raschka hứa đúng điều đó. Sách dày 368 trang, Manning xuất bản tháng 09/2024 (ISBN 9781633437166). Theo Manning, bạn tự viết một base model mà không dựa vào thư viện LLM nào có sẵn, rồi biến nó thành một bộ phân loại và một chatbot làm theo chỉ dẫn.
Nếu bạn triển khai LLM cho khách, đây không phải sách lý thuyết. Cuốn sách giúp bạn hiểu thứ mình triển khai đủ sâu để chẩn đoán lỗi, ước lượng chi phí và chọn đúng cách tùy biến model.
Một cuốn sách để gõ, không phải để đọc
Repo chính thức rasbt/LLMs-from-scratch đi theo đúng trình tự của người phải làm cho model chạy được. Chương 2 xử lý dữ liệu văn bản, chương 3 là attention, chương 4 ráp một model GPT, chương 5 pretraining, chương 6 và 7 là hai kiểu fine-tune. Phụ lục E nói về LoRA.
Code được viết để chạy trên laptop thường trong thời gian chấp nhận được, và tự dùng GPU nếu máy có. Manning chỉ yêu cầu Python trình độ trung bình và chút kiến thức machine learning. Raschka còn có một khóa học miễn phí trên YouTube đi kèm sách, hữu ích khi bạn kẹt ở một chương.
Vì sao prompt dài gấp đôi, attention tốn gấp bốn?
Chương về attention bắt bạn tự tính điểm giữa mọi cặp token. Làm một phép tính nhỏ: chuỗi n token cho ra ma trận n×n. Với 1.000 token, ma trận có 1 triệu ô. Với 2.000 token, nó có 4 triệu ô.
Phần bonus của chương 4 trong repo có KV cache. Raschka giải thích rằng cache lưu lại các vector key và value đã tính, để dùng lại khi sinh token mới.
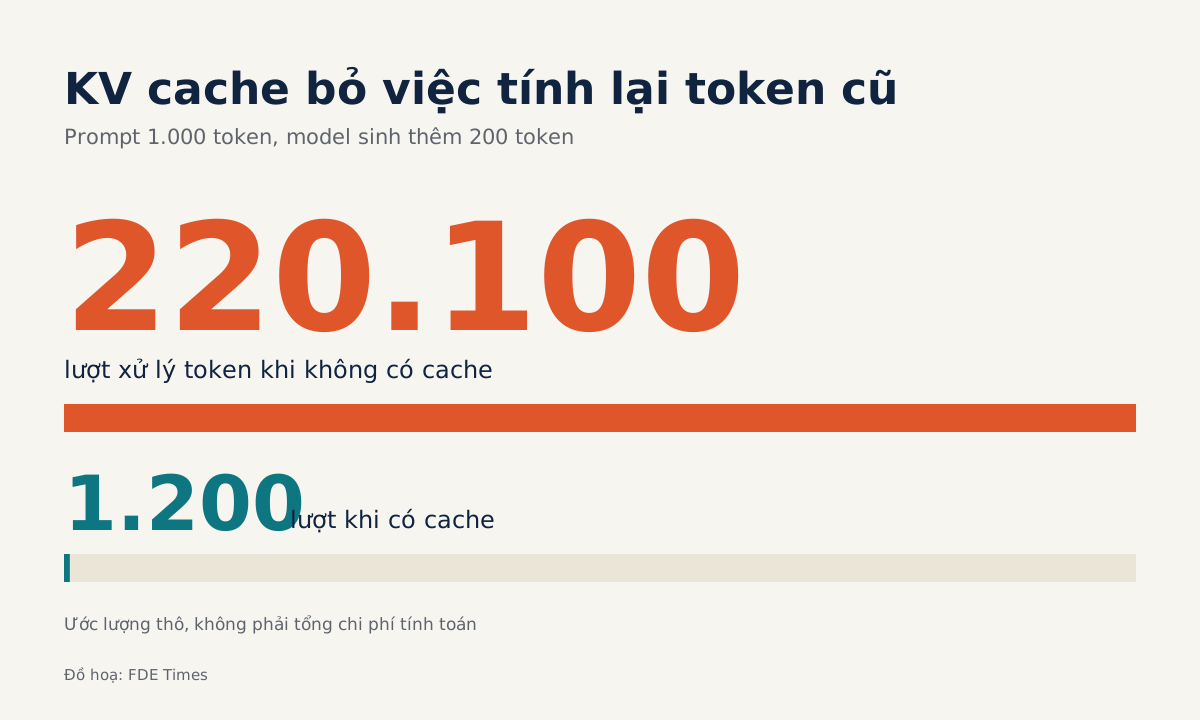
Một ước lượng thô cho thấy khác biệt: prompt 1.000 token, model sinh thêm 200 token. Không có cache, mỗi bước sinh lại xử lý cả chuỗi từ 1.001 đến 1.200 token, cộng lại là 220.100 lượt xử lý token.
Có cache, model xử lý 1.000 token một lần rồi thêm 200 bước, mỗi bước một token mới: tổng cộng 1.200 lượt. Con số này không phải tổng chi phí tính toán. Mỗi token mới vẫn phải attend tới mọi key đã lưu, nên phần tiết kiệm nằm ở việc không tính lại key và value của các token cũ, chứ attention không mất đi.
Cái giá cũng được Raschka nói thẳng: code phức tạp hơn, và bộ nhớ tăng theo độ dài chuỗi. Vì thế khi khách phàn nàn về latency, bạn biết phải hỏi gì: prompt dài bao nhiêu, output dài bao nhiêu, cache có bật không và máy còn bao nhiêu bộ nhớ.
Khách cần gán nhãn hay cần sinh văn bản?
Chương 6 và 7 tách bạch hai việc khác nhau. Fine-tune để phân loại biến model thành một bộ gán nhãn. Fine-tune theo chỉ dẫn dạy model trả lời theo yêu cầu. Khách muốn tự động chia ticket hỗ trợ vào năm nhóm là bài toán của chương 6, đo bằng accuracy trên một tập kiểm tra.
Nếu khách lại muốn một trợ lý viết câu trả lời cho ticket, bạn đang ở chương 7, và việc đo khó hơn nhiều. Đầu ra càng tự do thì càng không có một đáp án đúng duy nhất để so. Vì thế bạn cần một cách chấm lặp lại được trước khi dám nói model sau fine-tune tốt hơn model gốc.
Ở chỗ khách, trước khi bàn đến fine-tune, hãy viết ra bài toán của họ là gán nhãn hay sinh văn bản. Câu trả lời quyết định cả cách làm lẫn cách đo.
Hai cái bẫy: đọc lướt và fine-tune vội
Một người đọc độc lập viết trên DEV Community rằng sách đòi hỏi nhiều công sức, và đọc hết có thể mất nhiều thời gian hơn bạn nghĩ. Đừng đọc chỉ để biết. Phép tính n×n chỉ thật sự ngấm khi bạn tự đổi độ dài chuỗi và nhìn kích thước ma trận thay đổi trên màn hình.
Cái bẫy thứ hai xuất hiện khi mang sách đến chỗ khách: nhảy thẳng vào fine-tune theo chỉ dẫn. Bạn có thể mất cả tuần cho chương 7, trong khi thứ khách cần chỉ là một bộ chia ticket đo được bằng accuracy.
Cũng nên biết sách bỏ qua những gì. Một bài review khác gọi đây là hướng dẫn đi từ nguyên lý gốc, từng dòng code. Nhưng người viết lưu ý vài chủ đề như top-p sampling hay RLHF chỉ được nhắc qua hoặc bị bỏ hẳn.
Đọc theo thứ tự nào?
Đọc thật kỹ chương 2 đến chương 4 và gõ lại code. Chương 5 về pretraining có thể đọc nhanh hơn. Sau đó chọn chương 6 hoặc 7 tùy loại bài toán khách hay mang tới, rồi kết thúc bằng LoRA ở phụ lục E.
Phần thưởng đến muộn nhưng có thật. Người review trên DEV Community nói sau khi đọc xong, họ dễ hiểu hơn hẳn các bài viết về attention hay KV cache. Với FDE, đó là kỹ năng để theo kịp tài liệu kỹ thuật mới mỗi tuần.
Về sự nghiệp, đừng để quá trình học nằm im trong notebook. Hãy đưa lên GitHub một model đã fine-tune trên dữ liệu công khai, kèm một trang ghi rõ cách đo và kết quả. Trong CV, một dòng như “tự cài đặt model kiểu GPT, fine-tune phân loại và đo accuracy trên tập kiểm tra” thuyết phục hơn nhiều so với “có kinh nghiệm với LLM”.
Lần tới khách hỏi vì sao model chậm hay vì sao fine-tune không cải thiện kết quả, bạn sẽ không phải đoán. Bạn đã từng tự viết lại chính phần code đó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Build a Large Language Model (From Scratch) – Manning Publications · 2024-09
- Sebastian Raschka – Manning Publications
- rasbt/LLMs-from-scratch – GitHub
- Books – Sebastian Raschka
- Understanding and Coding the KV Cache in LLMs from Scratch – Sebastian Raschka · 2025-06-17
- Book Review: Build a Large Language Model (From Scratch) by Sebastian Raschka – DEV Community · 2025-10-08
- Building an LLM from scratch – dpranantha · 2025-04-10