Software Architecture: The Hard Parts dạy FDE cân đánh đổi khi tách và nối hệ thống của khách hàng
Ở site khách hàng, câu hỏi khó nhất hiếm khi là "làm thế nào". Câu hỏi khó hơn là bạn chấp nhận mất gì để đổi lấy gì, và cuốn sách khoảng 450 trang của bốn kiến trúc sư này tập cho bạn trả lời nó.
Tóm tắt nhanh
- Sách do O'Reilly xuất bản ngày 5 tháng 11 năm 2021, của Neal Ford, Mark Richards, Pramod Sadalage và Zhamak Dehghani, dùng nhóm hư cấu Sysops Squad làm case study xuyên suốt.
- Sách không đưa ra đáp án. Sách dạy cách cân đánh đổi khi chọn độ chi tiết của service, loại hợp đồng, cách tách dữ liệu vận hành và giao dịch phân tán.
- Với FDE, giá trị lớn nhất nằm ở hai chủ đề tách dữ liệu và chọn hợp đồng, vì đây là hai việc bạn đụng đến ngay khi nối vào hệ thống của khách.
“Trong kiến trúc phần mềm, không có quyết định nào dễ.” Lời giới thiệu của nhà xuất bản mở đầu bằng câu gần như lời thú nhận ấy, cho một cuốn sách có cái tên rất thật thà: Software Architecture: The Hard Parts, phụ đề là phân tích đánh đổi hiện đại cho kiến trúc phân tán, do Neal Ford, Mark Richards, Pramod Sadalage và Zhamak Dehghani viết.
Với một Forward Deployed Engineer, câu đó mô tả đúng ngày làm việc bình thường. Bạn đến site khách và thấy một hệ thống cũ, một database dùng chung, vài đội không muốn ai đụng vào phần của mình. Rồi bạn phải nối sản phẩm của công ty mình vào đó trong vài tuần.
Cuốn sách này không dạy bạn công nghệ nào tốt nhất. Nó dạy một việc khó hơn: cân xem mỗi lựa chọn được gì, mất gì, rồi nói được điều đó với khách bằng lý lẽ rõ ràng.
Cuốn sách này đến từ đâu?
O’Reilly phát hành bản in ngày 5 tháng 11 năm 2021, dày khoảng 450 trang, ISBN 978-1-4920-8689-5. Nội dung không được viết một mạch. Theo trang đào tạo của Neal Ford, các tác giả đã dạy workshop và lớp đào tạo suốt vài năm, chỉnh dần cả nội dung lẫn cách kể trước khi in thành sách.
Vì lớn lên từ lớp học, sách được kể như một khóa học có nhân vật. Thay vì liệt kê pattern, sách theo chân một đội hư cấu tên Sysops Squad qua chuỗi quyết định: tách service to hay nhỏ, hợp đồng giữa các service nên thế nào, xử lý giao dịch phân tán ra sao, và các đặc tính vận hành bị ảnh hưởng thế nào.
Lời hứa của sách rất thẳng: giúp bạn rèn tư duy phản biện về những đánh đổi trong kiến trúc phân tán. Ford còn nhấn mạnh rằng kiến trúc sư nào cũng hưởng lợi khi học cách phân tích đánh đổi, không riêng gì chuyên gia.
FDE thường là người phải đứng ra giải thích những quyết định như vậy trước khách, nên đây là kỹ năng bạn dùng gần như mỗi tuần.
Ý thứ nhất: hợp đồng chặt hay lỏng là một quyết định, không phải thói quen
Đề cương khóa học của Ford có một phần riêng tên “Strict Versus Loose Contracts”. Với FDE, đây có lẽ là chủ đề dùng được ngay ngày mai, vì gần như mọi deployment đều bắt đầu bằng việc đọc dữ liệu từ hệ thống của khách.
Thử hình dung API đơn hàng của khách trả về payload 40 field, còn agent của bạn chỉ cần 3: mã đơn, trạng thái, thời gian cập nhật.
Nếu validate chặt cả 40 field, chỉ cần đội bên khách đổi tên một field bạn không hề dùng là pipeline của bạn gãy lúc nửa đêm. Nếu chỉ đọc 3 field cần thiết và bỏ qua phần còn lại, hệ thống của bạn sống sót qua những thay đổi đó.
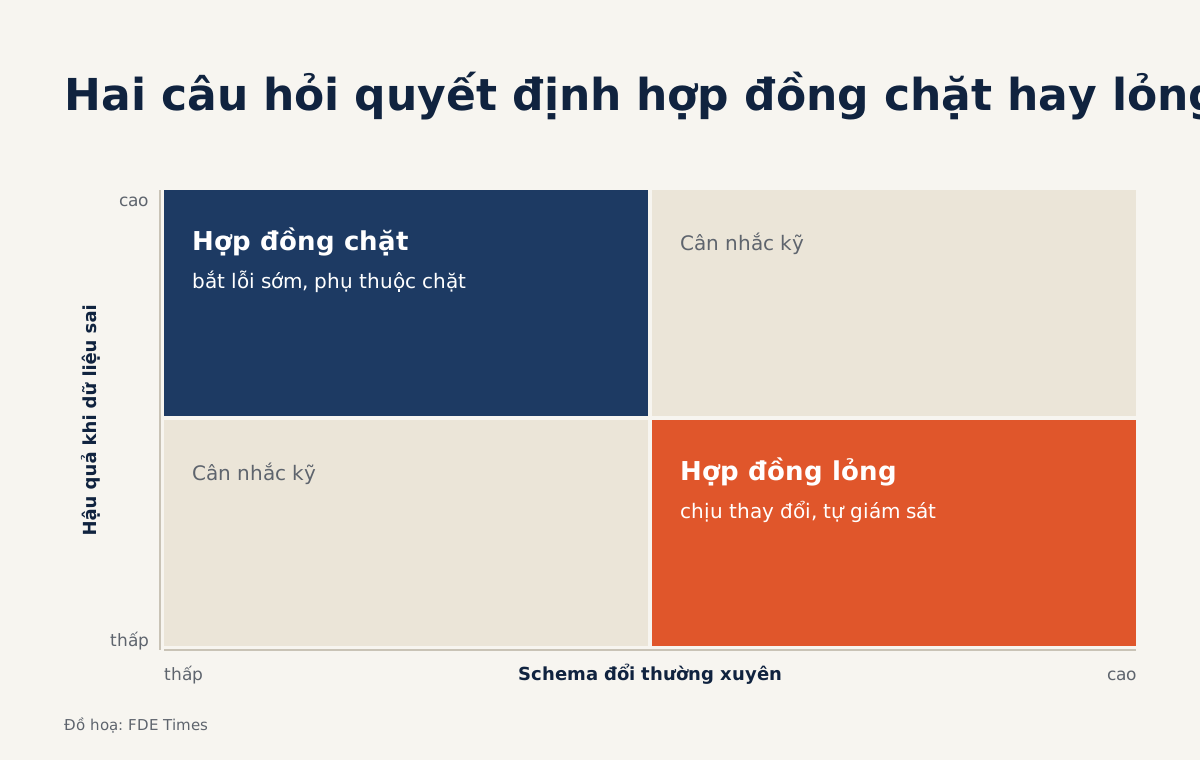
Nhưng hợp đồng lỏng cũng có giá. Lỗi có thể lọt qua mà không ai hay, chẳng hạn khi field trạng thái đổi giá trị mà không báo trước. Hợp đồng chặt bắt lỗi sớm nhưng buộc hai bên phụ thuộc chặt vào nhau; hợp đồng lỏng chịu được thay đổi, đổi lại bạn phải tự giám sát dữ liệu.
Ở site khách, việc đầu tiên nên làm là hỏi đội sở hữu API xem họ đổi schema thường xuyên đến đâu, và dữ liệu sai thì hậu quả lớn cỡ nào. Hai câu trả lời đó quyết định bạn nghiêng về phía nào.
Bài tập nhỏ: lấy một response thật từ API bạn đang dùng, đếm số field code của bạn thực sự đọc. Với mỗi field, ghi một dòng: nếu field này đổi tên hoặc đổi giá trị, bạn muốn hệ thống gãy ngay hay chạy tiếp và cảnh báo?
Ý thứ hai: tách nhỏ đến mức nào mới vừa?
Đề cương còn có phần “Service Granularity”, tức câu hỏi nên chia hệ thống thành những mảnh lớn cỡ nào. Khi khách có một monolith và muốn hiện đại hóa, phản xạ thường gặp là đề xuất microservices ngay. Sách buộc bạn dừng lại một nhịp.
Hãy lấy một ví dụ giả định: luồng đặt hàng được tách thành ba service riêng cho đơn hàng, thanh toán và tồn kho. Trong monolith, ba bước này nằm gọn trong một giao dịch database. Sau khi tách, nếu thanh toán thành công mà trừ kho thất bại, không còn lệnh rollback nào gom cả ba lại.
Đó là bài toán giao dịch phân tán, một trong những chủ đề sách đề cập. Bạn được thêm sự độc lập nhưng phải trả bằng gọi mạng, điều phối, logic bù trừ khi một bước hỏng, và gỡ lỗi khó hơn.
Trước khi vẽ sơ đồ tách cho khách, hãy hỏi phần nào thực sự thay đổi với tốc độ khác nhau và phần nào bắt buộc phải nhất quán cùng lúc. Nếu ba phần luôn đổi cùng nhau và phải đúng cùng nhau, tách chúng ra chỉ thêm việc.
Bài tập nhỏ: chọn một luồng nghiệp vụ của khách, liệt kê từng bước và đánh dấu những bước phải đúng cùng lúc. Nhóm nào luôn đi cùng nhau thì giữ chung một service; chỉ ranh giới giữa các nhóm mới là chỗ đáng cân nhắc tách.
Ý thứ ba: dữ liệu là thứ khó tách nhất
Một phần trong đề cương có tên “Pulling Apart Operational Data”, tức tách dữ liệu vận hành. Tách code tương đối dễ. Tách một database mà billing, kho vận và báo cáo cùng đọc ghi thì khó hơn nhiều, và đây thường là nơi các dự án tích hợp bị kẹt lâu nhất.
Giả sử bạn cần agent đọc trạng thái đơn hàng. Đọc thẳng từ database dùng chung thì nhanh, nhưng bạn bị trói vào schema nội bộ mà không ai cam kết giữ nguyên. Xin khách mở một API thì chậm hơn vài tuần, đổi lại ranh giới rõ ràng. Không phương án nào sai, và sách dạy bạn nói rõ cái giá của từng phương án.
Bài tập nhỏ: với mỗi bảng mà agent của bạn đọc, ghi lại đội nào sở hữu nó và còn ai khác ghi vào. Bảng nào có nhiều bên cùng ghi nhất là chỗ bạn nên xin một API trước, thay vì đọc thẳng.
Ai nên đọc, và đọc theo thứ tự nào?
Sách hợp nhất với kỹ sư đã có vài năm kinh nghiệm, đã quen với service, API và database, và bắt đầu phải tự đưa ra quyết định kiến trúc. Nếu bạn mới ra trường, 450 trang bàn về đánh đổi sẽ khá trừu tượng khi bạn chưa từng tự mình trả giá cho một quyết định nào.
Cách đọc hiệu quả là bám theo mạch truyện Sysops Squad từ đầu để thấy các quyết định nối với nhau thế nào. Sau đó quay lại đọc kỹ những đoạn bàn về tách dữ liệu vận hành và hợp đồng, hai chủ đề FDE gặp nhiều nhất. Các chủ đề độ chi tiết service và giao dịch phân tán để dành khi khách hỏi về hiện đại hóa.
Về sự nghiệp, kỹ năng này thể hiện được ra ngoài. Khi đọc JD có cụm “integrate with customer systems”, hãy hiểu đó là việc phải cân những đánh đổi kiểu này mỗi tuần.
Trong CV, đừng chỉ ghi “tích hợp với hệ thống ERP”. Hãy viết rõ bạn chọn đọc qua API thay vì đọc thẳng database, và chấp nhận chậm hai tuần để đổi lấy ranh giới ổn định.
Khi luyện system design, hãy tập thói quen nói thành tiếng phương án của mình mất gì, chứ không chỉ kể tên công nghệ. Cuốn sách không cho bạn đáp án, nhưng nó giúp bạn tự đặt ra những câu hỏi ấy trước khi khách hàng kịp hỏi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
4 nguồn
- Software Architecture: The Hard Parts: Modern Trade-Off Analyses for Distributed Architectures
- Software Architecture: The Hard Parts (Ford et al.) - Schweitzer · 2021-11-05
- Software Architecture: The Hard Parts (GOTO Gotopia Bookclub, Neal Ford & Mark Richards) · 2023-02
- Neal Ford - Architecture: The Hard Parts training