Post-training of LLMs của DeepLearning.AI: 76 phút để biết khi nào nên dùng SFT, DPO hay RL
Khoá ngắn của Banghua Zhu không dạy bạn vận hành cụm GPU, nhưng dạy câu hỏi FDE hay gặp nhất ở chỗ khách hàng: có nên fine-tune không, và nếu có thì bằng cách nào.

Tóm tắt nhanh
- Khoá dài 1h26m, gồm cả quiz 10 phút, nên phần video còn khoảng 76 phút; giảng viên là Banghua Zhu (University of Washington, Nvidia, Nexusflow).
- Giá trị lớn nhất của khoá là dạy khi nào và vì sao chọn SFT, DPO hay RL; phần GRPO với verifiable reward là phần sát việc FDE nhất.
- Đừng chờ khoá dạy hạ tầng: lab chạy trên mô hình nhỏ, còn post-training ở quy mô hàng trăm GPU là một mảng kiến thức khác.
Ở chỗ khách hàng, FDE hiếm khi bị hỏi “chạy GRPO thế nào”. Câu hỏi thường gặp hơn nhiều là “có nên fine-tune không, và nếu có thì theo cách nào”. Trả lời sai, cả team có thể mất hàng tuần huấn luyện một mô hình cho một vấn đề mà prompt tốt hơn đã giải được.
“Post-training of LLMs” của DeepLearning.AI xoay quanh đúng câu hỏi đó. Khoá đi qua ba kỹ thuật: Supervised Fine-Tuning (SFT), DPO và online RL. Theo trang khoá học, mục tiêu là hiểu khi nào và vì sao dùng từng phương pháp, chứ không chỉ học cách chạy riêng một kỹ thuật.
Vì thế khoá này đáng học, kể cả khi bạn chưa bao giờ phải tự huấn luyện mô hình. Khoá được xếp ở trình độ Intermediate, và trang chính thức tóm mục tiêu là học cách post-train và tuỳ biến một LLM.
Ai dạy, và khoá dành cho ai?
Giảng viên là Banghua Zhu. Theo tiểu sử trên trang khoá, ông là Assistant Professor tại University of Washington, Principal Research Scientist tại Nvidia và đồng sáng lập Nexusflow. DeepLearning.AI công bố khoá trên diễn đàn cộng đồng ngày 9/7/2025, còn trang khoá ghi lần cập nhật gần nhất là 17/7/2026.
Thời lượng khá gọn. Trang khoá ghi tổng cộng 1h26m, gồm một bài quiz chấm điểm dài 10 phút. Trừ quiz đi thì phần bài giảng còn khoảng 76 phút, khớp với con số 1h16m ở một bản liệt kê cũ hơn của chính khoá này.
Theo mô tả, khoá nhắm tới những người làm AI “sẵn sàng đi xa hơn pre-training”. Nói cách khác, bạn nên nắm LLM căn bản trước khi vào học. Với một FDE, thứ tự hợp lý là làm quen với prompting, retrieval và eval trước, rồi mới học khoá này. Fine-tuning chỉ đáng bàn khi bạn đã đo được rằng các cách rẻ hơn không đủ.
Ba phương pháp, ba loại tín hiệu
Mỗi phần của khoá đều có bài thực hành. Ở phần SFT, bạn tải một mô hình pretrained rồi dựng pipeline biến base model thành instruct model. Ở phần DPO, ví dụ là đổi “danh tính” của một chat assistant. Ở phần RL, bạn học cách PPO và GRPO hoạt động, cách thiết kế reward function, rồi huấn luyện bằng GRPO với verifiable reward để mô hình giỏi toán hơn.
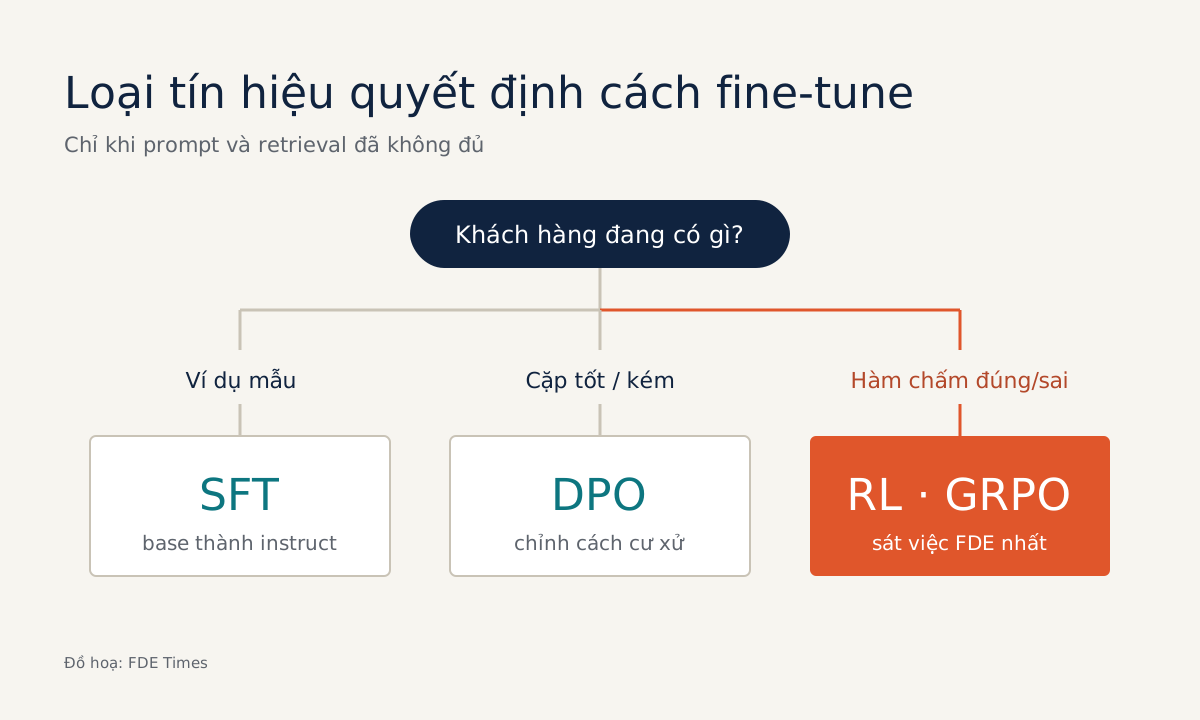
Nhìn ba bài thực hành cạnh nhau sẽ thấy ý đầu tiên đáng giữ: mỗi phương pháp cần một loại tín hiệu khác nhau. SFT học từ ví dụ mẫu gồm đầu vào và đầu ra chuẩn. DPO học từ việc so sánh câu trả lời tốt với câu trả lời kém. RL học từ một hàm chấm điểm.
Thử hình dung một khách hàng logistics muốn mô hình đọc email và trích ra mã vận đơn. Nếu họ đã có vài nghìn email được nhân viên gán nhãn, đó là dữ liệu kiểu SFT.
Nếu họ chỉ có nhật ký nhân viên sửa lại câu trả lời của bot, đó là cặp tốt/kém, gần với DPO hơn. Việc đầu tiên khi đến chỗ khách hàng là kiểm kê xem họ đang có loại dữ liệu nào, chưa vội bàn đến mô hình.
DPO dùng để chỉnh cách mô hình cư xử
Bài lab đổi danh tính chat assistant khá nhỏ, nhưng nó cho thấy DPO thay đổi hành vi của mô hình. Đây là ý thứ hai đáng giữ.
Những yêu cầu như “bot phải xưng tên công ty”, “bot phải từ chối câu hỏi ngoài phạm vi” hay “giọng văn phải ngắn gọn” đều là chuyện cư xử, và có thể diễn đạt thành cặp câu trả lời nên chọn và nên tránh.
Nếu khách hàng muốn mô hình “biết” thêm tài liệu nội bộ, bạn nên cân nhắc kỹ trước khi nghĩ ngay đến DPO, vì retrieval thường là chỗ đáng thử trước. Tách bạch hai loại yêu cầu này trong buổi discovery sẽ tiết kiệm cho cả hai bên rất nhiều vòng huấn luyện vô ích.
Reward kiểm chứng được là phần sát việc FDE nhất
Ý thứ ba, cũng là lý do chính để học khoá này, nằm ở phần GRPO với verifiable reward. Bài toán toán học có đáp án đúng hoặc sai, nên phần thưởng có thể tính tự động mà không cần người chấm. Nhiều task của khách hàng cũng có tính chất đó.
Quay lại với khách hàng logistics ở trên. Reward có thể đơn giản như sau: được 1 điểm nếu đầu ra là JSON hợp lệ và mã vận đơn khớp với hệ thống, ngược lại 0 điểm.
Nếu bài toán là đọc hoá đơn, bạn có thể thêm điều kiện tổng tiền phải bằng tổng các dòng. Viết reward kiểu này buộc bạn định nghĩa “đúng” bằng code. Đó cũng là kỹ năng bạn cần để dựng eval, kể cả khi cuối cùng không huấn luyện gì cả.
Mặt trái là reward viết lỏng tay thì mô hình sẽ tìm cách ăn điểm mà không thật sự làm đúng việc. Vì thế bạn nên cho khách hàng xem trước reward function như một bản đặc tả, trước khi chạy dù chỉ một bước huấn luyện.
Những gì nên bỏ qua
Đừng chờ khoá dạy bạn hạ tầng. Lab chạy trên một mô hình pretrained nhỏ tải từ Hugging Face. Trong khi đó, thư viện post-training NeMo RL của NVIDIA được thiết kế cho mô hình từ rất nhỏ đến hơn 100B tham số, chạy từ 1 GPU đến hàng trăm GPU.
Khoảng cách giữa hai thứ đó là cả một mảng kỹ năng riêng mà 76 phút không thể lấp được.
Với phần lớn FDE, chỗ thiếu đó chấp nhận được. Việc của bạn thường là quyết định đúng phương pháp và chứng minh nó có hiệu quả. Khi một dự án thật cần huấn luyện ở quy mô lớn, tài liệu của NeMo RL là bước học tiếp theo, chứ không phải xem lại khoá này lần nữa.
Nếu job description bạn nhắm tới có nhắc đến fine-tuning gắn với việc làm cùng khách hàng, đừng ghi vào CV chung chung là “đã học post-training”. Hãy ghi một quyết định cụ thể: task nào, tín hiệu nào, vì sao chọn SFT hay bỏ fine-tuning, và điểm eval thay đổi bao nhiêu.
Thứ đáng mang về từ 76 phút này không phải cách chạy GRPO. Đó là thói quen hỏi “đúng nghĩa là gì, và ta kiểm chứng nó bằng cách nào” trước khi đụng tới GPU nào.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!