Pandera: viết schema cho DataFrame để chặn dữ liệu lỗi của khách ngay ở bước đầu pipeline
Ở site khách hàng, file CSV đầu tiên bạn nhận hiếm khi khớp với tài liệu mô tả. Một thư viện mã nguồn mở nhỏ giúp bạn thấy chỗ lệch ngay tại cột bị lỗi.

Tóm tắt nhanh
- Pandera là dự án mã nguồn mở của Union.ai, giấy phép MIT, do Niels Bantilan viết và bảo trì.
- Schema được viết như một class kế thừa DataFrameModel, nhưng muốn kiểm tra lúc chạy thì phải có decorator check_types.
- Khi dữ liệu sai, lỗi nêu rõ tên cột, check bị hỏng và giá trị gây lỗi, đủ để FDE hỏi lại khách một câu cụ thể.
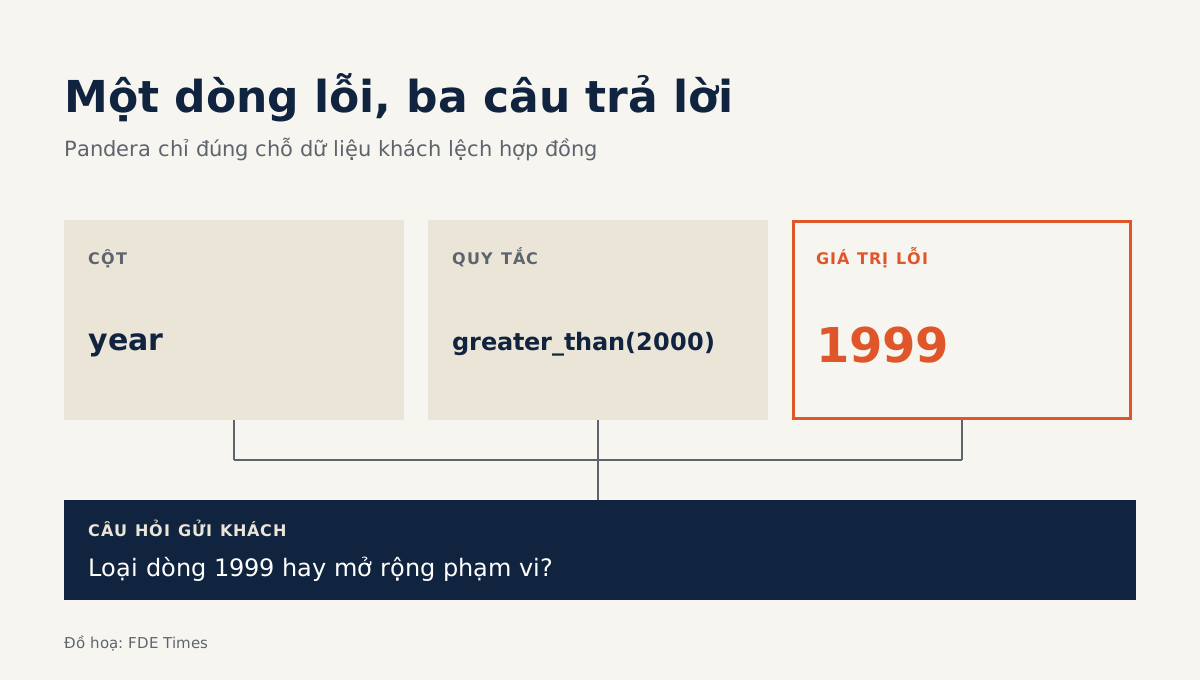
Một giá trị 1999 trong cột year thường chẳng ai để ý. Rồi một tuần sau, báo cáo cho khách lệch số liệu và cả nhóm mất hai ngày để truy ngược lại nó. Pandera giúp bạn bắt lỗi kiểu này ngay từ đầu: khi dữ liệu không qua được kiểm tra, thư viện báo đúng cột, đúng quy tắc bị vi phạm và đúng giá trị gây lỗi.
Với FDE, chuyện này quan trọng hơn với kỹ sư làm sản phẩm. Ở công ty mình, bạn kiểm soát được nguồn dữ liệu. Ở site khách hàng thì ngược lại: dữ liệu đi qua hệ thống của người khác, bị export bằng công cụ của người khác, và tài liệu mô tả thường đã cũ hơn dữ liệu thật.
Repo unionai-oss/pandera tự giới thiệu là một thư viện kiểm thử dữ liệu thống kê gọn nhẹ, do Niels Bantilan viết và bảo trì, với mục tiêu làm cho pipeline xử lý dữ liệu dễ đọc và vững hơn. Cách nhanh nhất để hiểu nó là viết một schema.
Một schema trông như thế nào?
Thử hình dung khách là một chuỗi bán lẻ gửi cho bạn file đơn hàng. Hợp đồng nói chỉ lấy dữ liệu từ sau năm 2000. Việc bạn cần làm là biến câu này thành code, để pipeline tự từ chối file sai thay vì âm thầm xử lý nó.
Với pandas, bạn cài bằng pip install 'pandera[pandas]'. Sau đó khai báo schema theo kiểu giống pydantic: viết một class kế thừa DataFrameModel, và mỗi cột là một thuộc tính của class.
import pandas as pd
import pandera.pandas as pa
from pandera.typing import DataFrame, Series

class Orders(pa.DataFrameModel):
    order_id: Series[str]
    year: Series[int] = pa.Field(gt=2000)

@pa.check_types
def load_orders(df: DataFrame[Orders]) -> DataFrame[Orders]:
    return df

raw = pd.DataFrame({"order_id": ["A1", "A2"], "year": [2021, 1999]})
load_orders(raw)
Khi chạy đoạn code này, dòng thứ hai bị chặn lại. Tài liệu Pandera đưa ra một thông báo lỗi tương tự: cột year hỏng ở validator greater_than(2000), và failure case là 1999. Trong một dòng, bạn có đủ ba thông tin: cột nào, quy tắc nào, giá trị nào.
Bẫy đầu tiên: annotation không tự kiểm tra gì cả
Nhiều người mới dùng nghĩ rằng chỉ cần ghi DataFrame[Orders] vào chữ ký hàm là xong. Thực ra không phải vậy. Tài liệu Pandera nói rõ phải có decorator check_types() thì DataFrame mới được kiểm tra lúc chạy, nên nếu thiếu dòng @pa.check_types ở ví dụ trên, giá trị 1999 sẽ lọt qua mà không có cảnh báo nào.
Lỗi này nguy hiểm vì đọc code thấy rất yên tâm. Người review thấy có type annotation, thấy có schema, và cho rằng dữ liệu đã được bảo vệ. Khi audit pipeline ở site khách, hãy tìm xem decorator có thật sự được gắn ở các hàm nhận dữ liệu vào hay không, đừng chỉ kiểm tra xem schema có tồn tại.
Bẫy thứ hai: tưởng schema đã phủ hết mọi thứ
Schema chỉ canh giữ những quy tắc bạn viết ra. Trong ví dụ trên, year có điều kiện gt=2000, còn order_id chỉ được khai báo kiểu chứ không có ràng buộc nào khác. Nếu báo cáo cuối cùng còn dựa vào một cột doanh thu mà bạn chưa đưa vào class, thì cột đó không được bảo vệ, dù pipeline vẫn chạy “xanh”.
Cách tránh là đi ngược từ đầu ra: liệt kê những cột mà con số gửi khách phụ thuộc vào, rồi kiểm tra từng cột đã có quy tắc trong schema hay chưa.
Bẫy thứ ba: một bản nâng cấp đổi hành vi kiểm tra
Trên PyPI, bản mới nhất của Pandera là 0.35.0, tức thư viện vẫn chưa lên 1.0. Với một thư viện ở giai đoạn 0.x, nên tính đến khả năng API còn thay đổi giữa các bản.
Vì thế, khi đưa Pandera vào repo của khách, hãy ghim cứng phiên bản trong file dependencies. Bạn sẽ không muốn một lần cài lại môi trường làm schema của mình kiểm tra khác đi mà không ai hay.
Thông báo lỗi chính là câu hỏi gửi khách
Giá trị lớn nhất của Pandera với FDE nằm ở bước sau khi lỗi xuất hiện. Một câu như “dữ liệu của anh chị có vấn đề” sẽ không đi đến đâu. Một câu như “cột year có giá trị 1999, trong khi phạm vi thỏa thuận là sau 2000; anh chị muốn loại dòng này hay mở rộng phạm vi?” thì khách trả lời được ngay trong ngày.
Như vậy, schema làm hai việc cùng lúc. Nó là hàng rào kỹ thuật trong code, và cũng là bản ghi lại những gì bạn và khách đã thống nhất về dữ liệu. Khi khách đổi ý, bạn sửa một dòng trong class, và lịch sử commit cho thấy rõ ai đã đồng ý điều gì, vào lúc nào.
Nên học gì trước?
Hãy bắt đầu từ chỗ nhỏ nhất có tác dụng: một DataFrameModel cho bảng quan trọng nhất của khách, cộng với check_types ở hàm load đầu tiên. Chưa cần phủ kín mọi cột.
Về mặt sự nghiệp, kỹ năng này dễ thể hiện. Trong CV, thay vì ghi “có kinh nghiệm pandas”, bạn có thể mô tả rằng mình đã đặt kiểm tra schema ở đầu vào pipeline dữ liệu của khách, và nêu loại lỗi nó đã chặn được. Khi đọc job description có cụm “data quality” hoặc “messy customer data”, đó là chỗ để kể câu chuyện này trong phỏng vấn.
Tuần đầu ở site khách nào cũng sẽ có một giá trị 1999 ở đâu đó. Câu hỏi là bạn phát hiện nó ngay ở bước load, hay đến lúc khách hỏi vì sao báo cáo sai.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!