Firecrawl: biến website và tài liệu công khai của khách hàng thành Markdown cho agent và RAG
Trang trợ giúp viết bằng SPA, một đống PDF và không ai biết sitemap nằm ở đâu: Firecrawl lo phần lấy dữ liệu, còn bạn vẫn phải tự chốt phạm vi bằng regex theo pathname, giới hạn chi phí bằng limit và giữ dữ liệu mới bằng maxAge.

Tóm tắt nhanh
- Firecrawl gánh phần khó của việc lấy dữ liệu web: proxy, anti-bot, render JavaScript. Kết quả trả về là Markdown hoặc JSON.
- Crawl mặc định đi tối đa 10.000 trang, mỗi trang tốn một credit. Vì vậy luôn đặt limit và đường dẫn trước khi chạy.
- Scrape lấy kết quả từ cache theo mặc định, cửa sổ cache là 2 ngày. Muốn có bản mới thì đặt maxAge=0.
Trang trợ giúp của khách được dựng bằng JavaScript nên lệnh curl chỉ nhận về một khung HTML rỗng, còn tài liệu sản phẩm lại nằm rải rác trong các file PDF và DOCX.
Firecrawl được làm ra để giải quyết đúng bước này. Công ty tự gọi sản phẩm của mình là “context API” cho AI agent: đưa vào một trang web đang chạy, nhận lại Markdown sạch hoặc dữ liệu có cấu trúc.
Với FDE, việc này rút ngắn đáng kể đoạn đường từ “khách gửi link” đến “agent trả lời được câu hỏi đầu tiên”. Nhưng muốn dùng tốt thì phải hiểu ba thứ: phạm vi crawl, chi phí và độ tươi của dữ liệu.
Nó gánh phần việc nào?
Theo tài liệu của Firecrawl, công cụ xử lý những phần khó nhất khi truy cập web: proxy, anti-bot, render JavaScript và nội dung động. Đầu ra là Markdown, JSON có cấu trúc, ảnh chụp màn hình và một số định dạng khác, đều đã ở dạng LLM đọc được ngay. Bạn không phải tự dựng một headless browser chỉ để đọc trang FAQ của khách.
Endpoint /scrape làm việc với từng URL. Nó tự nhận diện PDF, DOCX và các loại tài liệu khác từ URL rồi chuyển chúng sang Markdown. Vì vậy, khi khách đưa một trang hướng dẫn sử dụng dạng PDF đang công khai trên web, bạn dùng cùng một lệnh gọi như với một trang HTML.
Crawl làm việc với cả một site. Bạn gửi một URL gốc, Firecrawl dựa vào sitemap và các đường link để tìm, rồi scrape mọi trang con mà nó tới được.
Ví dụ: crawl đúng mục tài liệu của khách
Thử hình dung khách là một công ty phần mềm. Site của họ có /blog, /careers, /docs/api và /docs/guides, nhưng agent hỗ trợ khách hàng chỉ cần hai mục /docs. Nếu bạn crawl từ trang chủ mà không giới hạn gì, Firecrawl sẽ đi tới mức mặc định là 10.000 trang, và mỗi trang tốn một credit.
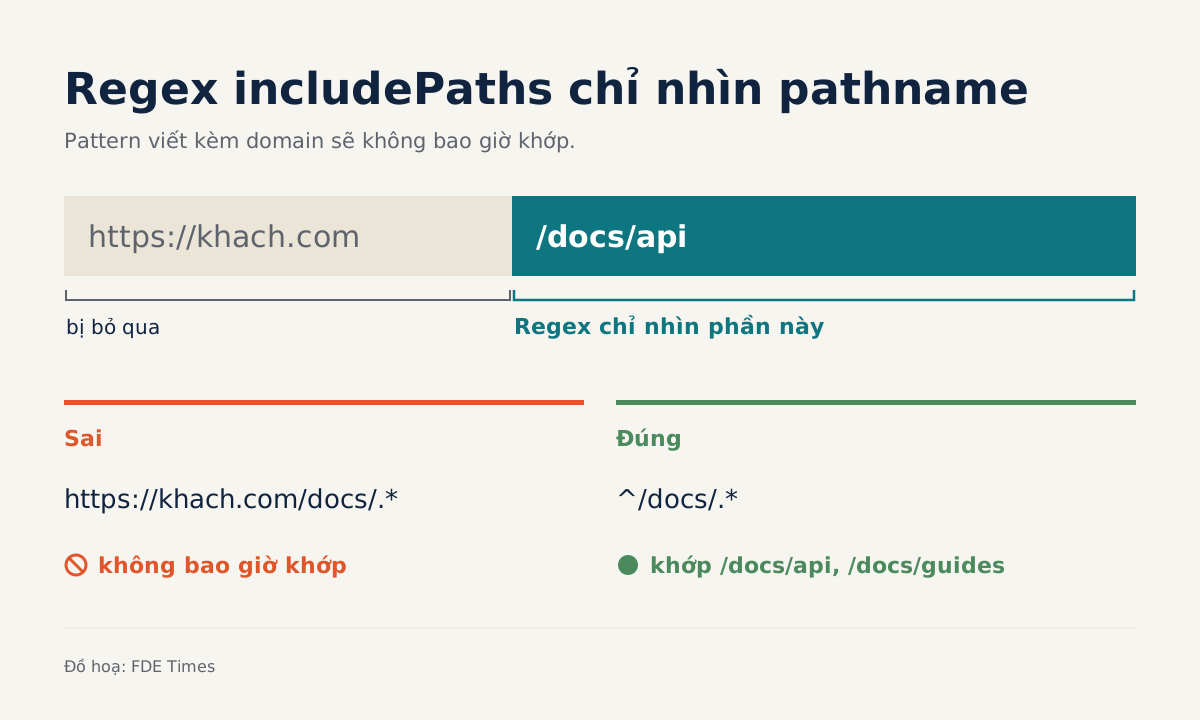
Bạn giới hạn phạm vi bằng includePaths và excludePaths. Lỗi hay gặp nhất nằm ở đây: hai tham số này là regex chỉ so khớp với pathname của URL, không so với URL đầy đủ và cũng không so với query parameter. Một pattern viết kiểu https://khach.com/docs/.* sẽ không bao giờ khớp; cách viết đúng là ^/docs/.*.
Phần thân request cho lần crawl thử, ở dạng minh hoạ, chỉ cần ba tham số:
{
  "url": "https://khach.com",
  "includePaths": ["^/docs/.*"],
  "limit": 50
}
Cũng vì regex chỉ nhìn pathname, bạn không thể dùng includePaths để lọc theo kiểu ?version=2. Nếu tài liệu của khách phân phiên bản bằng query string, hãy tìm hiểu cấu trúc URL trước khi chạy. Quy trình an toàn là: scrape thử vài trang, crawl với limit nhỏ như trên, đếm số trang nhận về, rồi mới nâng giới hạn.
Dữ liệu cũ là cái bẫy âm thầm
Mặc định, Firecrawl trả kết quả từ cache nếu có bản sao gần đây, với cửa sổ cache là 2 ngày. Bản v2 nhấn mạnh caching thông minh và Firecrawl nói nó giúp scrape nhanh gấp 10 lần. Với phần lớn tài liệu, điều này có lợi: nhanh hơn và ít phải gọi lại trang web của khách.
Nhưng hãy nghĩ đến trang bảng giá hay changelog. Vì cache có thể giữ bản sao tới 2 ngày, nếu khách vừa cập nhật giá sáng nay thì agent của bạn vẫn có thể trả lời bằng giá cũ. Với những URL như vậy, hãy đặt maxAge=0 để bỏ qua cache:
{
  "url": "https://khach.com/pricing",
  "maxAge": 0
}
Nên ghi rõ quy ước này, URL nào đọc từ cache và URL nào luôn lấy bản mới, trong tài liệu bàn giao cho khách.
Ai được crawl, và ai được tự host?
Crawl tôn trọng robots.txt theo mặc định. Chỉ gói Enterprise mới bật được ignoreRobotsTxt. Ngay cả khi tính năng đó có sẵn, quyền crawl site của khách vẫn phải là chuyện thỏa thuận bằng văn bản, không phải chuyện cấu hình; với site của bên thứ ba, robots.txt là ranh giới không nên vượt qua.
Về giấy phép, kho mã trên GitHub mô tả Firecrawl là API mã nguồn mở. Phần lõi dùng AGPL-3.0, còn SDK và một số thành phần giao diện dùng MIT. Nếu khách muốn tự host bên trong hạ tầng của họ, hãy để bộ phận pháp lý của khách xem AGPL trước, và bạn nên là người nêu câu hỏi đó ra trước.
Firecrawl có kể tên Zapier, Shopify và Replit trong số khách hàng, nhưng thứ thuyết phục khách của bạn là bản Markdown chạy thử trên chính site của họ.
Nên học gì trước
Bắt đầu bằng /scrape trên một trang khó: một SPA và một file PDF. Mục đích là để biết Markdown đầu ra trông thế nào trước khi đưa vào bước chunking. Tiếp theo, học cách viết regex theo pathname và đặt limit, vì đây là chỗ quyết định chi phí, rồi mới đến chiến lược cache cho từng nhóm URL.
Khi đưa kinh nghiệm này vào CV, đừng chỉ viết “dùng Firecrawl”. Hãy mô tả việc bạn đã dựng pipeline ingest tài liệu cho RAG: giới hạn phạm vi crawl ra sao, ước lượng chi phí thế nào, làm mới dữ liệu theo quy tắc gì. Cách viết đó cho người đọc CV thấy bạn biết cân nhắc dữ liệu của khách, thay vì chỉ liệt kê tên công cụ.
Firecrawl cho bạn Markdown nhanh. Quyết định nên lấy trang nào và lấy lại lúc nào vẫn là việc của bạn.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!