Grafana cho FDE: một dashboard cho mọi site của khách, cảnh báo chỉ khi người dùng bị ảnh hưởng
Khi bạn đã triển khai cho khách ở mười hai site, câu hỏi không còn là có giám sát hay không, mà là còn ai theo dõi nổi 48 dashboard copy ra từ một bản gốc.
Tóm tắt nhanh
- Một dashboard có biến chọn site thay được hàng chục bản copy và tránh được cảnh dashboard mọc lan không kiểm soát
- RED (Rate, Errors, Duration) cho biết người dùng đang gặp gì, còn USE soi CPU, bộ nhớ và mạng
- Cảnh báo theo triệu chứng, gắn nhãn theo site và định tuyến bằng notification policy để chỉ gọi người khi thật sự cần
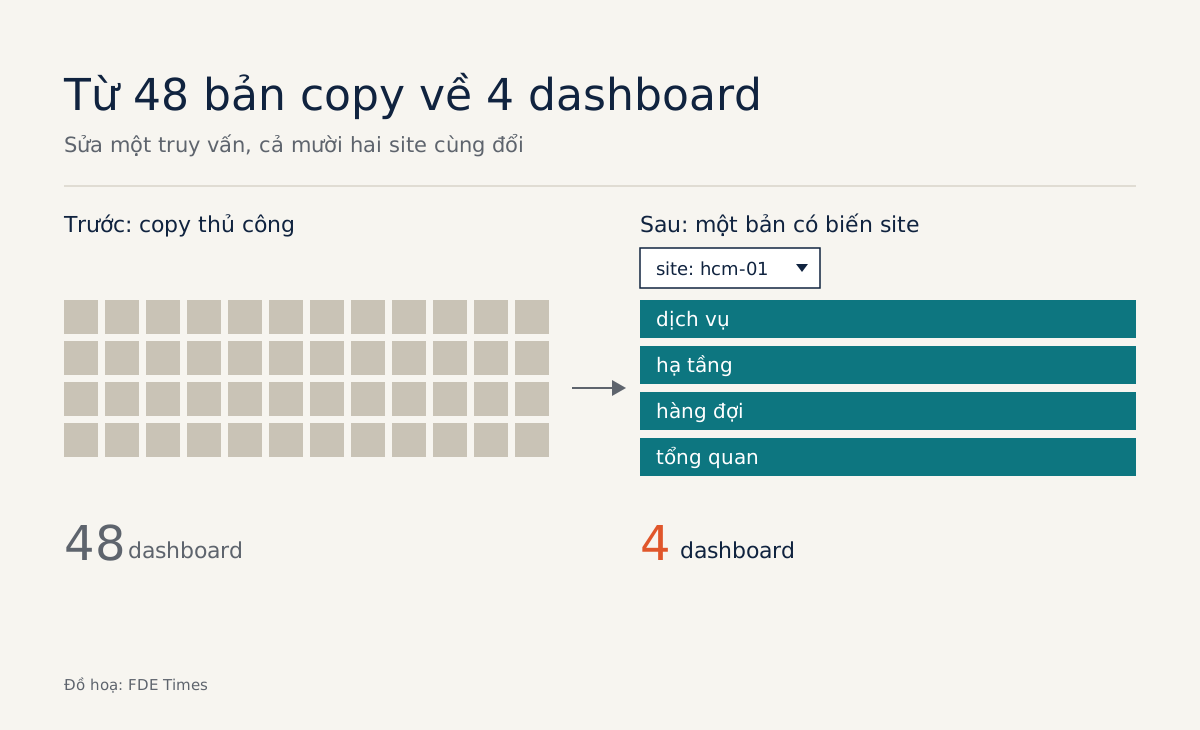
Thử hình dung bạn vừa đưa hệ thống lên mười hai site của cùng một khách. Mỗi site cần bốn dashboard: dịch vụ, hạ tầng, hàng đợi, tổng quan. Copy thủ công, bạn có 48 dashboard, và mỗi lần sửa một truy vấn, gần như chắc chắn sẽ có vài bản copy bị bỏ sót.
Đây là lúc FDE tìm đến Grafana. Không phải vì công cụ này vẽ biểu đồ đẹp, mà vì nó cho bạn hai thứ một deployment nhiều site cần: một cách nhìn sức khoẻ thống nhất cho mọi site, và một hệ thống cảnh báo báo đúng người, đúng lúc.
Một dashboard, mười hai site
Tài liệu của Grafana nói thẳng cách làm: dựng một dashboard rồi dùng biến để đổi thứ bạn đang xem. Biến được định nghĩa một lần và dùng lại khắp dashboard, nên một ô chọn site ở góc trên là đủ để mọi panel chuyển theo.
Hướng dẫn best practice của chính Grafana khuyên dùng template và biến để tái sử dụng dashboard và giữ sự nhất quán. Cùng tài liệu đó cảnh báo về dashboard sprawl, tức số dashboard tăng lên không kiểm soát.
Với FDE, sprawl không chỉ là chuyện bừa bộn. Khi khách hỏi vì sao site số 7 chậm, bạn cần chắc rằng panel ở site 7 đo đúng cùng một thứ với panel ở site 1.
Một ví dụ tối giản, giả sử dịch vụ xuất metric Prometheus tên http_requests_total với nhãn site và status. Biến site lấy danh sách giá trị từ chính nhãn đó:
label_values(http_requests_total, site)Panel tỉ lệ lỗi khi đó dùng biến thay cho tên site viết cứng:
sum(rate(http_requests_total{site="$site", status=~"5.."}[5m]))
/
sum(rate(http_requests_total{site="$site"}[5m]))
Trong ví dụ trên, 48 bản copy rút lại còn 4 dashboard, mỗi cái có biến site. Sửa một truy vấn là cả mười hai site được sửa. Việc đầu tiên nên làm ở khách: thống nhất tên nhãn site trong metric ngay từ ngày triển khai, vì biến chỉ chạy đúng khi dữ liệu được gắn nhãn nhất quán.
Nên đặt panel nào lên trước?
Grafana gợi ý dashboard RED cho tầng dịch vụ: Rate, Errors, Duration. Phương pháp này do Tom Wilkie của Grafana Labs đưa ra trong bài viết năm 2018, với Rate là số request mỗi giây. Tài liệu Grafana gọi một dashboard RED được thiết kế tốt là thước đo gián tiếp cho trải nghiệm người dùng.
Nhưng site của khách còn có máy chủ thật bên dưới. Phương pháp USE, theo Grafana, hợp nhất với tài nguyên phần cứng như CPU, bộ nhớ và thiết bị mạng. Vì thế một dashboard site tốt thường có hai tầng: RED ở trên để biết người dùng đang gặp gì, USE ở dưới để tìm vì sao.
Nếu cần một danh sách kiểm tra, sách SRE của Google liệt kê bốn golden signal: latency, traffic, errors và saturation. Ba cái đầu khớp với RED, cái cuối gần với USE. Hàng panel đầu tiên cho mỗi site nên trả lời đủ bốn câu đó.
Cảnh báo: báo triệu chứng, không báo nguyên nhân
Trong Grafana Alerting, alert rule là tập điều kiện quyết định khi nào một cảnh báo được bắn. Phần khó không nằm ở cú pháp mà ở việc chọn điều kiện. Hướng dẫn của Prometheus khuyên cảnh báo theo triệu chứng thay vì nguyên nhân để giảm nhiễu.
Lấy ví dụ site số 7. Rule “CPU trên 90%” là cảnh báo nguyên nhân: CPU có thể cao mà người dùng vẫn ổn. Rule “tỉ lệ lỗi của site vượt ngưỡng trong nhiều phút liền” là triệu chứng: nó chỉ bắn khi người dùng thật sự bị ảnh hưởng.
Viết thành truy vấn cho alert rule, bạn không dùng biến dashboard mà gom theo nhãn, để một rule theo dõi cùng lúc mọi site. Ngưỡng 5% dưới đây chỉ là ví dụ, hãy chốt con số với khách:
sum by (customer, site) (rate(http_requests_total{status=~"5.."}[5m]))
/
sum by (customer, site) (rate(http_requests_total[5m]))
> 0.05
Giữ CPU trên dashboard để chẩn đoán, đừng để nó đánh thức ai lúc nửa đêm. Sách SRE của Google nhận xét rằng đánh thức một người dậy tốn rất nhiều thời gian quý của họ. Với FDE phụ trách nhiều khách, một alert vô nghĩa mỗi đêm là cách nhanh nhất để cả team bắt đầu lờ đi alert thật.
Định tuyến theo nhãn khách hàng
Khi alert đã đúng, nó còn phải tới đúng người. Grafana gọi notification policy là xương sống của một hệ thống cảnh báo đầy đủ: policy định tuyến và gom nhóm alert dựa trên nhãn.
Rule ở trên đã mang sẵn nhãn customer và site, nên bạn có thể đưa alert của khách A tới kênh của team phụ trách khách A. Khi cả khách gặp một sự cố chung, mười hai alert cùng lúc có thể được gom thành một thông báo.
Thứ tự làm việc ở khách vì thế khá rõ: thống nhất nhãn, dựng dashboard có biến, viết vài rule triệu chứng, rồi mới tới policy định tuyến. Đảo thứ tự, bạn sẽ phải viết lại rule khi nhãn thay đổi.
Những lỗi hay gặp ở site của khách
Lỗi phổ biến nhất là copy dashboard cho từng site “cho nhanh”, rồi vài tháng sau không ai biết bản nào là bản đúng. Đó chính là sprawl mà Grafana cảnh báo, và cách chữa là quay về một bản có biến.
Lỗi thứ hai là đặt nhãn tuỳ tiện. Site tên hcm-01 ở chỗ này và HCM1 ở chỗ khác sẽ thành hai site trong ô chọn, và rule gom theo site cũng tách đôi. Lỗi thứ ba là cho mọi alert gọi on-call, kể cả cảnh báo CPU hay disk, thay vì chỉ gọi khi triệu chứng xuất hiện.
Cũng nên nhớ giới hạn của công cụ: Grafana chỉ hiển thị và cảnh báo trên những gì hệ thống đã đo. Nếu dịch vụ chưa xuất metric về rate, lỗi và độ trễ, không dashboard nào cứu được.
Học gì trước, ghi gì lên CV
Nếu bạn đang chuẩn bị vào vai FDE, hãy học theo thứ tự: RED và USE trước, rồi biến dashboard, rồi alert rule và notification policy. Khi phỏng vấn, nên hỏi thẳng ai trực on-call cho các site của khách và alert được định tuyến ra sao, câu trả lời sẽ cho bạn biết kỹ năng này nặng tới đâu trong công việc.
Trên CV, đừng ghi “biết Grafana”. Hãy ghi bạn gom bao nhiêu dashboard thành một bản có biến, hoặc giảm số alert gọi on-call bằng cách chuyển sang cảnh báo triệu chứng.
Bài tập: một site bị tách làm đôi
Thử hình dung ô chọn site hiện cả hcm-01 lẫn HCM1, và rule tỉ lệ lỗi bắn hai alert riêng cho cùng một nơi. Bước đầu tiên là chạy count by (site) (http_requests_total) để thấy mọi giá trị nhãn đang tồn tại.
Bước hai: tìm nơi đặt nhãn, thường là cấu hình của exporter hoặc agent thu metric ở site đó, rồi sửa về một tên duy nhất theo quy ước đã chốt. Sửa tại nguồn tốt hơn vá trong từng truy vấn, vì mọi dashboard và rule đều đọc chung một nhãn.
Bước ba: chờ dữ liệu cũ trôi khỏi khoảng thời gian của truy vấn, mở lại ô chọn và kiểm tra chỉ còn hcm-01, rồi bắn thử một alert giả để chắc notification policy vẫn đưa nó tới đúng kênh. Làm bài này một lần, bạn sẽ không để nhãn site tự do ở lần triển khai sau.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Grafana Alerting | Grafana documentation
- Variables | Grafana documentation
- Grafana dashboard best practices | Grafana documentation
- Alert rules | Grafana documentation
- Notifications | Grafana documentation
- The RED Method: How to Instrument Your Services | Grafana Labs · 2018-08-03
- Monitoring Distributed Systems (Google SRE book)
- Alerting | Prometheus