Docling: biến PDF và bảng biểu của khách thành Markdown cho RAG, chạy cục bộ
Nhiều demo RAG đã hỏng ngay từ lúc đọc tài liệu, trước khi kịp gọi tới model. Bộ công cụ mã nguồn mở do IBM Research khởi xướng này nhắm đúng vào khâu đó.

Tóm tắt nhanh
- Docling dùng DocLayNet để phân tích bố cục và TableFormer để khôi phục cấu trúc bảng, nhờ vậy giữ được bảng và thứ tự đọc khi chuyển sang Markdown.
- Công cụ chạy cục bộ trên phần cứng thông thường và dùng được trong môi trường air-gapped. Đây là điểm quyết định khi tài liệu của khách nhạy cảm.
- HybridChunker chia chunk theo cấu trúc rồi theo token và lặp lại tiêu đề bảng ở mỗi chunk; Docling có sẵn tích hợp với LangChain, LlamaIndex, Crew AI và Haystack.
Thử hình dung tuần đầu ở chỗ khách. Họ đưa bạn một thư mục hợp đồng nhà cung cấp dạng PDF, file nào cũng có một bảng giá nhiều cột, kèm một yêu cầu: tài liệu không được rời khỏi máy chủ nội bộ.
Dù bạn chọn model nào, demo RAG vẫn sẽ trả lời sai nếu bước đọc PDF dàn phẳng bảng giá thành một chuỗi chữ, các cột trộn lẫn vào nhau.
Docling nhắm thẳng vào chỗ hỏng này. Đây là package mã nguồn mở do nhóm AI for knowledge của IBM Research Zurich khởi xướng.
Báo cáo kỹ thuật của dự án trên arXiv, đăng ngày 19/8/2024 bởi nhóm tác giả IBM gồm Auer, Lysak, Nassar, Dolfi, Staar và cộng sự, mô tả nó là công cụ dễ dùng, tự chứa và theo giấy phép MIT. Tháng 4/2025, IBM đóng góp Docling cho LF AI & Data thuộc Linux Foundation.
Với FDE, khâu này đáng để tâm vì nó nằm ở đầu pipeline. Ingestion ít khi được nhắc tới, nhưng mọi câu trả lời phía sau đều dựa vào nó. Ai làm chủ được khâu này thường là người cứu được buổi demo.
Docling làm gì khác một trình đọc PDF thông thường?
Trình trích xuất văn bản thông thường chỉ đọc ký tự theo vị trí trên trang. Docling thì cố hiểu trang đó trông ra sao, dựa trên hai model chuyên biệt: DocLayNet phân tích bố cục, TableFormer nhận các vùng bảng đã phát hiện và khôi phục cấu trúc của chúng.
Nhờ vậy, theo trang GitHub của dự án, Docling hiểu được bố cục trang, thứ tự đọc và cấu trúc bảng. Cũng vì hiểu cấu trúc nên nó xuất ra được Markdown đúng nghĩa: tiêu đề vẫn là tiêu đề, bảng vẫn là bảng.
Còn một lý do khiến nó hợp với công việc ở chỗ khách. Báo cáo kỹ thuật cho biết Docling chạy được trên phần cứng thông thường, và tài liệu chính thức nêu rõ khả năng chạy cục bộ cho dữ liệu nhạy cảm lẫn môi trường air-gapped.
Vì thế trong buổi đầu gặp đội bảo mật của khách, bạn trả lời được ngay câu “dữ liệu có đi ra ngoài không”.
Ví dụ tối thiểu: từ file PDF ra Markdown
Trang hướng dẫn chính thức cho thấy chỉ cần vài dòng Python: tạo một DocumentConverter, chuyển tài liệu rồi gọi export_to_markdown():
from docling.document_converter import DocumentConverter

source = "hop_dong_nha_cung_cap.pdf"
converter = DocumentConverter()
doc = converter.convert(source).document
print(doc.export_to_markdown())
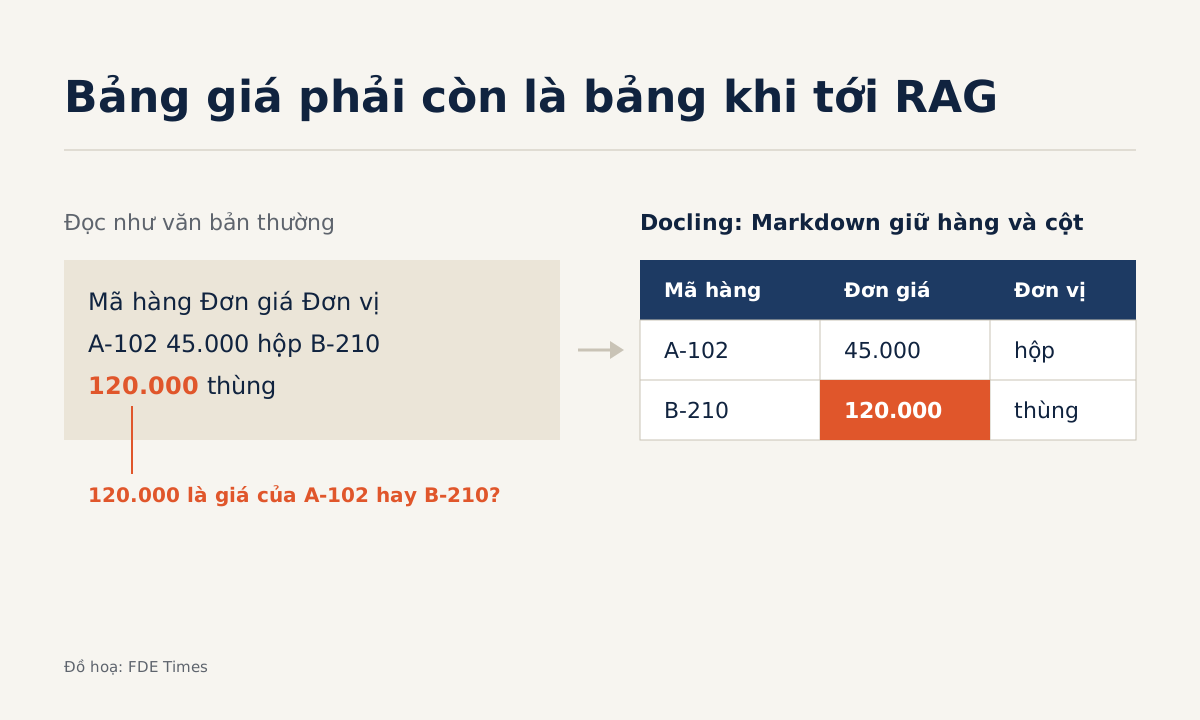
Quay lại bảng giá trong hợp đồng. Thử hình dung một bảng ba cột (mã hàng, đơn giá, đơn vị tính). Khi bị đọc như văn bản thường, nó có thể thành một dòng chữ liền mạch như thế này:
Mã hàng Đơn giá Đơn vị A-102 45.000 hộp B-210 120.000 thùngNhìn dòng đó, LLM không có cách nào biết chắc 120.000 là giá của A-102 hay B-210. Thứ bạn muốn thấy sau khi chạy Docling là một bảng Markdown giữ nguyên hàng và cột:
| Mã hàng | Đơn giá | Đơn vị |
|---------|---------|--------|
| A-102   | 45.000  | hộp    |
| B-210   | 120.000 | thùng  |
Các con số trên chỉ để minh hoạ, nhưng phép kiểm tra thì dùng được thật. Đừng dừng ở chỗ code chạy được: mở Markdown đầu ra và soát từng bảng, xem mã hàng có nằm cạnh đúng đơn giá, đơn vị tính có bị dồn sang cột bên cạnh không.
Markdown không phải định dạng xuất duy nhất; tài liệu chính thức liệt kê thêm HTML, WebVTT và DocLang. Markdown hợp để đưa thẳng vào prompt và soát bằng mắt.
Soát một bảng thì dễ, đo cả lô mới thuyết phục
Soát bằng mắt chỉ đủ cho vài file. Khi khách hỏi “nó đọc bảng tốt đến đâu”, bạn cần một con số trên cả lô tài liệu của chính họ.
Cách đơn giản nhất: chọn một mẫu bảng, tự gõ lại bảng chuẩn cho từng cái, rồi đếm bảng nào ra đúng số hàng, số cột và ô nào cũng đúng chỗ.
Giả sử mẫu có 40 bảng và 31 bảng đạt, tỷ lệ bảo toàn là 31/40, tức 77,5%. Chạy cùng mẫu đó qua trình trích xuất khách đang dùng, bạn có ngay cặp số “trước và sau”.
Tỷ lệ đúng/sai có nhược điểm: một bảng lệch đúng một ô cũng bị tính là hỏng hoàn toàn. Muốn mịn hơn, hãy dùng TEDS (Tree-Edit-Distance-based Similarity), chỉ số do một nghiên cứu năm 2019 đề xuất cho bài toán nhận dạng bảng.
TEDS so bảng dự đoán với bảng chuẩn theo cả cấu trúc hàng, cột lẫn nội dung từng ô, cho ra một điểm tương đồng; lấy trung bình trên các mẫu là được điểm của cả lô. Báo cáo cho khách cả hai con số: tỷ lệ bảng hoàn hảo để họ dễ hiểu, điểm TEDS để thấy mức hỏng nặng hay nhẹ.
Chunk theo cấu trúc, không theo số ký tự
Chuyển đổi xong mới đi được nửa đường. Cắt tài liệu thành từng khúc 500 ký tự là cách dễ nhất để chẻ đôi bảng giá vừa giữ được, hoặc tách một điều khoản khỏi tiêu đề của nó.
HybridChunker của Docling xử lý chỗ này. Nó chia theo cấu trúc phân cấp của tài liệu trước, rồi tinh chỉnh theo tokenizer, thường là tokenizer khớp với model embedding: chỉ tách những chunk quá cỡ và gộp các chunk nhỏ liền kề, để mỗi chunk vừa với giới hạn token mà model chấp nhận.
from docling.chunking import HybridChunker

chunker = HybridChunker()
for i, chunk in enumerate(chunker.chunk(dl_doc=doc)):
    print(i, chunk.text[:80])
Với bảng dài buộc phải tách qua nhiều chunk, Docling mặc định lặp lại dòng tiêu đề bảng ở đầu mỗi chunk. Khi in kết quả ra, đó chính là thứ cần kiểm tra: chunk thứ hai của bảng giá vẫn phải bắt đầu bằng “Mã hàng | Đơn giá | Đơn vị”.
Sang bước tiếp theo bạn cũng không phải tự viết glue code. Docling có sẵn tích hợp với LangChain, LlamaIndex, Crew AI và Haystack, nên nếu khách đã dựng stack trên một trong các framework này, Docling chỉ thay đúng khâu ingestion.
Đừng hứa trước khi chạy thử trên tài liệu xấu nhất
Model chuyên biệt vẫn chỉ là model. Một bản scan nghiêng, mờ, có con dấu đè lên bảng nhiều khả năng sẽ làm khó việc phân tích bố cục và nhận dạng bảng hơn hẳn một file PDF xuất từ Word.
Vì thế đừng cam kết độ chính xác trên slide. Hãy xin khách mẫu tài liệu tệ nhất họ có, chạy qua Docling, đo tỷ lệ bảo toàn bảng như trên và cho họ xem kết quả thật, kể cả những chỗ còn sai.
Chạy cục bộ cũng có cái giá: tài nguyên tính toán giờ là việc của bạn chứ không còn là việc của một API bên ngoài. Với hàng nghìn tài liệu, hãy đo thời gian xử lý trên chính máy chủ của khách trước khi hứa lịch triển khai.
Học gì trước, và ghi gì vào CV
Nên học theo thứ tự: chuyển PDF sang Markdown, tập đọc đầu ra để phát hiện bảng hỏng, dựng một bộ mẫu bảng chuẩn để đo, rồi mới tới HybridChunker và tích hợp framework. Đọc báo cáo kỹ thuật trên arXiv giúp bạn hiểu DocLayNet và TableFormer làm gì, để giải thích được vì sao một bảng bị đọc sai.
Khi đọc job description, hãy để ý những cụm như “document ingestion”, “unstructured data” hay “on-prem deployment”; đó là dấu hiệu công ty đang gặp đúng bài toán này.
Trên CV, một dòng có con số nặng hơn nhiều so với “có kinh nghiệm RAG”, chẳng hạn: “xây pipeline ingestion cục bộ cho tài liệu nhiều bảng, nâng tỷ lệ bảng giữ đúng cấu trúc từ X% lên Y% trên mẫu có bảng chuẩn đối chiếu”.
Khách sẽ nhớ FDE nào làm demo RAG chạy đúng trên chính đống PDF lộn xộn của họ, và chứng minh được bằng con số, chứ không nhớ ai chọn model mới nhất. Docling là một trong những đường ngắn nhất để làm được việc đó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Docling Technical Report · 2024-08-19
- GitHub - docling-project/docling
- Index - Docling (official docs)
- Index - Docling (official usage docs)
- Chunking - Docling
- Docling: An open-source tool kit for advanced document processing · 2025-05-29
- AI Workflows Get New Open Source Tools to Advance Document Intelligence, Data Quality, and Decentralized AI · 2025-04-29
- Image-based table recognition: data, model, and evaluation · 2019-11-25