Ba mươi trang của khách nói đúng hơn mọi bảng xếp hạng parser
Dựng bộ chấm theo từng trường để chọn parser bằng số đo, không bằng cảm giác.
Tóm tắt nhanh
- ParseBench thử 14 phương pháp và không phương pháp nào mạnh đều trên cả năm chiều, nên phải thử trên tài liệu của chính khách.
- Điểm tương đồng văn bản dễ đánh lừa: nó chỉ nhìn chữ có khớp không và bỏ sót lỗi như bảng bị vỡ.
- Chấm theo trường, tách exact và relaxed match, rồi thêm luật nghiệp vụ như tổng tiền khớp với các dòng.
Một pipeline dùng Docling để đọc hoá đơn đạt độ chính xác tổng thể 63% trong một nghiên cứu về trích xuất hoá đơn, và lỗi chủ yếu nằm ở các con số. Docling không phải công cụ tồi. Con số đó chỉ nhắc rằng điểm trên bảng xếp hạng và điểm trên tài liệu thật của khách có thể cách nhau rất xa.
Với FDE, câu hỏi “nên dùng parser nào?” thường đến ngay tuần đầu ở chỗ khách. Trả lời bằng bài blog hay leaderboard là cách nhanh nhất để mất uy tín ba tuần sau, khi agent của khách đọc sai tổng tiền. Câu trả lời thuyết phục hơn nằm ở 30 trang tài liệu thật, một danh sách trường và một script chấm điểm chạy được trong một buổi chiều.
Bài này đi qua đúng bộ đó. Bạn cần Python 3, quyền truy cập một mẫu tài liệu (của khách, hoặc hoá đơn công khai để tập), và ít nhất hai parser để so sánh. Ví dụ dưới dùng Docling, Unstructured và Amazon Textract AnalyzeExpense.
Vì sao không tin một bảng xếp hạng?
ParseBench, benchmark gắn với LlamaIndex công bố tháng 4/2026, dùng các trang tài liệu doanh nghiệp do người kiểm tra từ bảo hiểm, tài chính và cơ quan nhà nước. Kết luận đáng nhớ nhất: trong 14 phương pháp được thử, không phương pháp nào mạnh đều trên cả năm chiều đánh giá. Parser giỏi bảng có thể kém ở trang scan, và ngược lại.
Nhóm tác giả còn chỉ ra một cái bẫy khác: các thước đo tương đồng văn bản chủ yếu chỉ nhìn chữ có khớp không, nên bỏ sót những lỗi gây hại ở khâu sau, như bảng bị vỡ.
Thử hình dung một bảng bị trộn cột: mọi chữ và số vẫn có mặt, nên điểm tương đồng chữ vẫn cao, nhưng số tiền đã nằm sai dòng. Theo ParseBench, thứ cần đo là nghĩa của dữ liệu có còn đúng không: output phải giữ được cấu trúc và ý nghĩa đủ để hệ thống tự ra quyết định.
Vì thế đơn vị chấm phải là trường dữ liệu mà khách thật sự dùng, không phải cả trang văn bản.
Bước 1: Chọn 30 trang và viết đáp án
Đừng lấy 30 trang đầu tiên trong thư mục. Hãy chia theo loại mà parser hay vấp: khoảng 10 trang PDF số, 10 trang scan, 10 trang nhiều bảng. Hỏi khách trang nào làm nhân viên của họ mất thời gian nhất, rồi đưa vài trang như thế vào.
Với mỗi trang, viết một file JSON đáp án theo đúng danh sách trường mà quy trình của khách cần:
{
  "page_id": "inv_017",
  "fields": {
    "invoice_id": "HD-2024-0193",
    "vendor_name": "Công ty TNHH Minh An",
    "invoice_date": "2024-03-14",
    "total_amount": "12450000"
  },
  "line_items": [
    {"description": "Giấy A4", "qty": "50", "amount": "4500000"},
    {"description": "Mực in", "qty": "10", "amount": "7950000"}
  ]
}
Kiểm tra sau bước này: nhờ một người phía khách soát lại 5 file bất kỳ. Ground truth sai thì mọi điểm số phía sau đều sai.
Bước 2: Ghim cấu hình từng parser
Lỗi phổ biến nhất khi so sánh parser là để mặc định. Unstructured có chiến lược rule-based (fast) và model-based (hi_res, ocr_only), còn auto là mặc định và tự chọn theo đặc điểm tài liệu. Để auto thì bạn không biết mình đang so sánh cái gì, nên hãy chạy fast và hi_res như hai ứng viên riêng.
Docling dùng mô hình phân tích layout, TableFormer cho cấu trúc bảng và OCR cho PDF scan. Xuất ra Markdown sẽ mất metadata, còn JSON thì lossless. Muốn chấm theo trường thì xuất JSON.
Textract AnalyzeExpense trả về danh mục trường chuẩn như INVOICE_RECEIPT_ID, kèm điểm Confidence cho từng giá trị. Giữ lại cả hai. Một file cấu hình cho harness của bạn (dạng giản lược, tự định nghĩa) có thể như sau:
candidates:
  docling:           {export: json}
  unstructured_fast: {strategy: fast}
  unstructured_hi_res: {strategy: hi_res}
  textract_expense:  {api: AnalyzeExpense, keep: [Confidence]}
Bước 3: Viết adapter đưa mọi output về cùng một danh sách trường
Mỗi parser trả về một cấu trúc khác nhau, nên bạn cần một hàm nhỏ cho từng parser để chuyển output thành dict giống hệt file đáp án. Với Textract việc này nhẹ nhất vì đã có danh mục chuẩn:
TEXTRACT_MAP = {
    "INVOICE_RECEIPT_ID": "invoice_id",
    # bổ sung các trường khác theo danh sách của khách
}
Với Docling và Unstructured, bạn sẽ phải tìm giá trị trong JSON hoặc danh sách element, chẳng hạn bằng nhãn (“Số hoá đơn:”) hay vị trí trong bảng. Ghi lại mọi luật tìm kiếm. Một phần đáng kể của chênh lệch giữa các parser có thể nằm ở adapter chứ không ở parser, nên hãy nói rõ điều đó với khách khi trình bày.
Bước 4: Chấm từng trường, tách strict và relaxed
Nghiên cứu hoá đơn nói trên chấm bằng field-level precision, số lần vi phạm kiểm tra nhất quán và exact match, đồng thời tách exact match với relaxed match. Cách tách này rất thực tế: tổng tiền lệch một chữ số là sai hoàn toàn, còn tên công ty thiếu dấu chấm vẫn dùng được.
import re
from difflib import SequenceMatcher

EXACT_FIELDS = {"invoice_id", "invoice_date", "total_amount"}

def norm_amount(s, dec=","):
    s = re.sub(rf"[^\d{re.escape(dec)}-]", "", s or "")
    return s.replace(dec, ".")

def exact_match(field, pred, truth):
    if field == "total_amount":
        return norm_amount(pred) == norm_amount(truth)
    return (pred or "").strip() == (truth or "").strip()

def relaxed_match(pred, truth, threshold=0.9):
    # ngưỡng relaxed: tự chọn và ghi rõ trong báo cáo
    a, b = (pred or "").lower(), (truth or "").lower()
    return SequenceMatcher(None, a, b).ratio() >= threshold

def match(field, pred, truth):
    if field in EXACT_FIELDS:
        return exact_match(field, pred, truth)
    return relaxed_match(pred, truth)
Hàm chuẩn hoá ở trên đã giản lược. Định dạng số và ngày của khách có thể phức tạp hơn, nên hãy thống nhất luật chuẩn hoá với họ trước khi chấm.
Bước 5: Chấm bảng mà không phạt việc đảo thứ tự
Thước đo TableRecordMatch của ParseBench không quan tâm thứ tự hàng và cột: bảng giữ đúng quan hệ giữa các giá trị thì không bị trừ điểm. Có thể làm phiên bản đơn giản theo cùng ý tưởng (không phải cách cài đặt gốc) bằng cách coi mỗi dòng là một tập cặp (cột, giá trị):
def table_score(pred_rows, truth_rows):
    as_set = lambda rows: {frozenset(r.items()) for r in rows}
    p, t = as_set(pred_rows), as_set(truth_rows)
    return len(p & t) / len(t) if t else 1.0
Một dòng chỉ được tính đúng khi mọi ô trong dòng đều đúng. Khắt khe, nhưng đó chính là điều agent của khách cần.
Bước 6: Thêm luật nghiệp vụ
So từng trường chưa đủ. Nghiên cứu hoá đơn đếm riêng các trường hợp dữ liệu trích ra vi phạm luật nghiệp vụ định sẵn, vì có những lỗi mà so sánh từng trường bỏ qua. Luật dễ viết nhất là tổng tiền phải bằng tổng các dòng:
def consistent(doc):
    total = float(norm_amount(doc["fields"]["total_amount"]))
    lines = sum(float(norm_amount(r["amount"])) for r in doc["line_items"])
    return abs(total - lines) < 0.01
Luật này còn chạy được trên tài liệu chưa có đáp án. Vì thế, khi hệ thống lên production, bạn có thể giữ nó lại làm cảnh báo.
Bước 7: Đọc kết quả theo trường quan trọng nhất
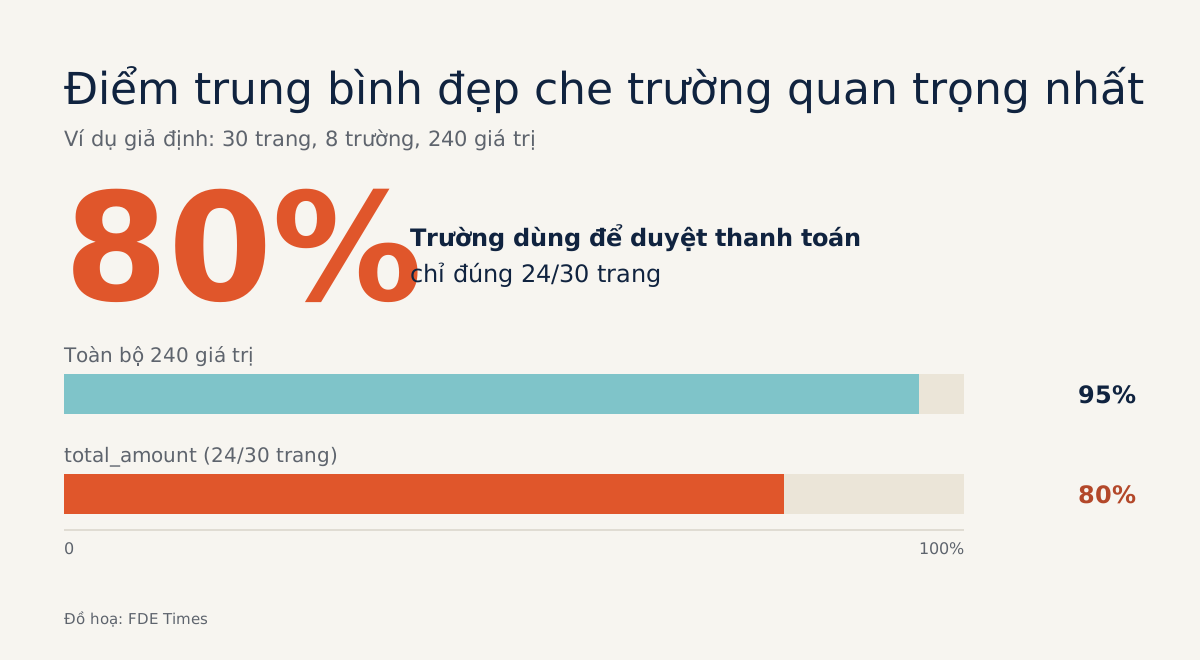
Thử hình dung 30 trang, mỗi trang 8 trường, tổng cộng 240 giá trị. Parser A đúng 228 giá trị, tức 95%. Nghe ổn, cho đến khi bạn thấy 6 trong 12 lỗi rơi vào total_amount: trường mà khách dùng để duyệt thanh toán chỉ đúng 24/30 trang, tức 80%.
Vì thế hãy in kết quả thành ma trận trường × parser, tách theo nhóm trang. Các con số trong bảng dưới là giả định, chỉ để minh hoạ cách trình bày:
| Trường | Docling | Unstructured hi_res | Textract |
|---|---|---|---|
| invoice_id (exact) | 29/30 | 27/30 | 30/30 |
| total_amount (exact) | 24/30 | 25/30 | 28/30 |
| line_items (dòng đúng) | 81% | 74% | 77% |
| Vi phạm luật tổng tiền | 5 | 4 | 2 |
Với Textract, thêm một bước: vẽ độ chính xác theo ngưỡng Confidence. Nếu giá trị có Confidence thấp hầu như đều sai, bạn có ngay luật đưa trang đó cho người duyệt.
Những lỗi hay gặp
Lỗi đầu tiên là chấm trên Markdown rồi đổ cho parser, trong khi chính bước xuất đã làm mất cấu trúc. Lỗi thứ hai là dùng một ngưỡng relaxed cho mọi trường, khiến số tiền sai vẫn được “gần đúng”. Lỗi thứ ba là chọn 30 trang sạch đẹp, rồi bất ngờ khi gặp trang scan nghiêng ngoài production.
Lỗi khó thấy nhất là chỉnh adapter cho riêng parser bạn thích. Hãy giữ một bộ quy tắc adapter viết ra giấy và áp dụng như nhau cho mọi ứng viên.
Ở chỗ khách, bộ chấm này là sản phẩm
Khi trình bày, đừng mở đầu bằng “parser X tốt nhất”. Hãy mở bằng ma trận: trường nào đã đủ tin để tự động hoá, trường nào cần người duyệt, và luật nghiệp vụ nào bắt được phần còn lại. Khách thường nhớ cách bạn đo lâu hơn cái tên parser bạn chọn.
Bộ chấm này cũng là một dự án portfolio gọn: repo có ground truth trên tài liệu công khai, adapter cho hai đến ba parser và ma trận kết quả. Trong CV, một dòng như “dựng bộ đánh giá parser theo từng trường, gồm luật nghiệp vụ và ngưỡng confidence” nói nhiều hơn một danh sách công cụ.
Parser sẽ còn được thay mới nhiều lần. Ba mươi trang đáp án và script chấm điểm thì vẫn dùng lại được mỗi lần có ứng viên mới.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- ParseBench: A Document Parsing Benchmark for AI Agents · 2026-04-09
- ParseBench: A Document Parsing Benchmark for AI Agents · 2026-04-13
- Invoice Information Extraction: Methods and Performance Evaluation · 2025-10-17
- Invoice Information Extraction: Methods and Performance Evaluation · 2025-10-22
- Docling: An Efficient Open-Source Toolkit for AI-driven Document Conversion · 2025-01-27
- Partitioning strategies - Unstructured
- Analyzing Invoices and Receipts - Amazon Textract