Job CSV chạy đêm sẽ chết lúc 2 giờ sáng, hãy để lần chạy lại vô hại
Băm nội dung file thay vì tên, ghi vào một bảng sổ cái và cách ly CSV lỗi, thì file gửi lại hay nạp dở cũng không bị nạp hai lần.
Tóm tắt nhanh
- Đừng lấy tên file làm khóa chống trùng, hãy dùng hash SHA-256 của nội dung file.
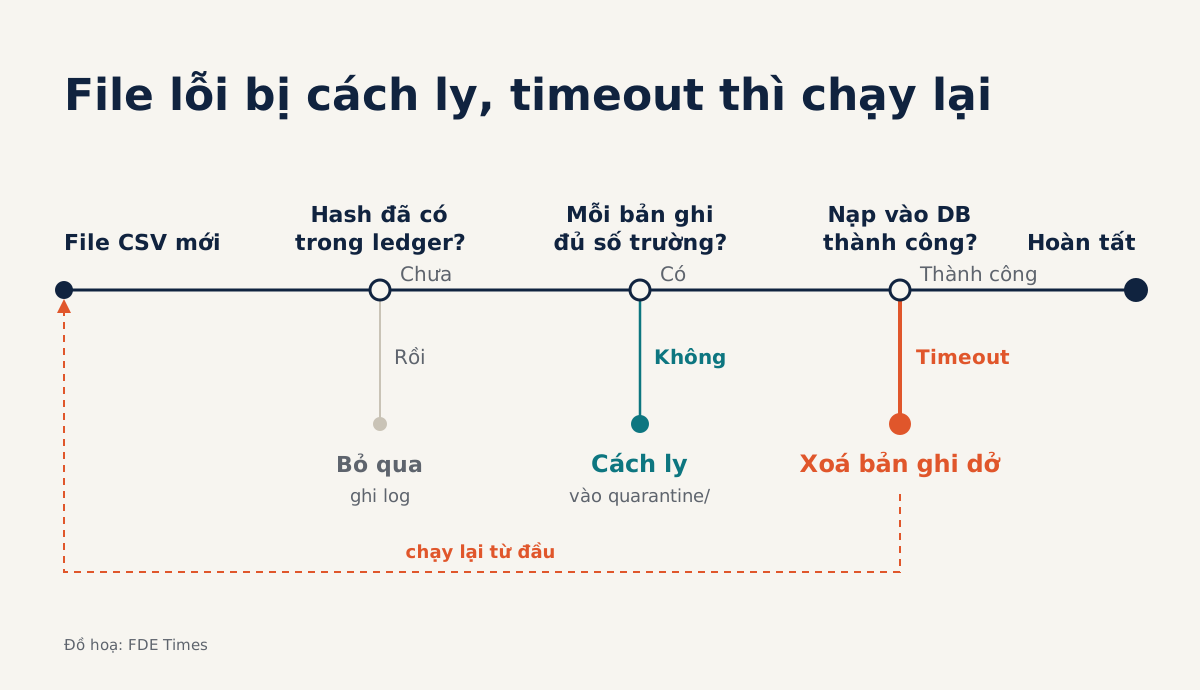
- Mỗi file phải có đúng một kết cục được ghi lại: đã xử lý, bị cách ly kèm lý do, hoặc bị bỏ qua vì trùng.
- Lỗi dữ liệu thì cách ly, lỗi hạ tầng thì xóa bản ghi, còn bản ghi kẹt ở trạng thái đang xử lý quá lâu thì phải được giành lại.
Thử hình dung đêm thứ ba của một deployment. Khách thả orders_1108.csv lên SFTP, job của bạn nạp được một nửa thì kết nối database timeout. Sáng ra bạn bấm chạy lại, và nửa đầu của file bị nạp lần thứ hai. Tuần sau khách lại gửi đúng file đó với tên orders_1108_final.csv, thế là cả file bị nạp thêm một lần nữa.
Không có bước nào trong chuỗi đó do code sai logic. Lỗi nằm ở chỗ job không có trí nhớ. Một batch chạy đêm chắc chắn sẽ có lúc phải chạy lại, nên chạy lại an toàn cần được thiết kế từ ngày đầu chứ không phải vá sau sự cố.
Hướng dẫn này dựng một job nhỏ bằng Python làm bốn việc: băm từng file, tra sổ cái, kiểm cấu trúc CSV, rồi xử lý hoặc cách ly. Code ở đây là bản phác thảo đã đơn giản hóa, chỉ dùng thư viện chuẩn và SQLite. Bạn cần Python 3, một thư mục inbox/ giả lập chỗ SFTP thả file, và một thư mục quarantine/.
Chạy lại an toàn nghĩa là gì?
Tài liệu Powertools for AWS Lambda định nghĩa idempotency là việc một thao tác không gây thêm side effect nào khi được gọi nhiều lần với cùng tham số đầu vào.
Với batch chạy đêm, “cùng đầu vào” là cùng nội dung file, còn tên file thì không tính. Cũng tài liệu đó cho phép lấy hash của toàn bộ payload làm khóa idempotency, và job của bạn sẽ dùng đúng cách đó.
Bước 1: tính SHA-256 theo từng khối
import hashlib

def sha256_of(path):
    h = hashlib.sha256()
    with open(path, "rb") as f:
        for chunk in iter(lambda: f.read(1 << 20), b""):
            h.update(chunk)
    return h.hexdigest()
Đọc theo khối 1 MB để file vài GB cũng không làm tràn RAM. Kiểm tra: copy một file sang tên khác rồi băm cả hai. Hai chuỗi hex phải giống hệt nhau, và nếu bạn sửa một ký tự trong file thì chuỗi phải khác hẳn.
Bước 2: một bảng sổ cái cho mọi file
Appsilon từng mô tả một thiết kế nạp dữ liệu lâm sàng theo sự kiện: mỗi file có một bản ghi JSON duy nhất chứa checksum SHA-256, kích thước và trạng thái xử lý, và bản ghi được ghi atomic. Ở đây bạn dùng SQLite thay cho JSON, nhưng nguyên tắc vẫn vậy.
CREATE TABLE IF NOT EXISTS ledger (
  sha256     TEXT PRIMARY KEY,
  filename   TEXT,
  size       INTEGER,
  status     TEXT,   -- in_progress | done | quarantined
  reason     TEXT,
  updated_at TEXT
);
Đặt PRIMARY KEY lên cột hash là bạn được hai thứ cùng lúc: chống trùng và một cái khóa. Powertools dùng một bản ghi “đang xử lý” để chặn hai lần gọi chạy đồng thời trên cùng một payload, và một câu INSERT bị từ chối cũng có tác dụng như vậy.
import sqlite3

def claim(db, digest, name, size):
    try:
        with db:  # one transaction
            db.execute(
                "INSERT INTO ledger VALUES (?,?,?,'in_progress',NULL,datetime('now'))",
                (digest, name, size))
        return True
    except sqlite3.IntegrityError:
        return False  # already seen: done, quarantined or running
Kiểm tra: gọi claim hai lần với cùng một hash. Lần đầu phải trả True, lần sau trả False.
Một file CSV hợp lệ trông thế nào?
RFC 4180 đưa ra quy tắc cấu trúc dễ kiểm nhất: mọi dòng trong file nên có cùng số trường. Cũng RFC đó khuyến nghị bọc trong nháy kép những trường chứa xuống dòng, dấu nháy kép hoặc dấu phẩy.
Một file xuất từ hệ thống cũ rất dễ vấp đúng điểm này, chẳng hạn một cột địa chỉ có dấu phẩy mà không được bọc nháy.
Bước 3: kiểm số trường theo header
import csv

def validate(path):
    try:
        with open(path, newline="", encoding="utf-8") as f:
            rows = csv.reader(f)
            header = next(rows, None)
            if not header:
                return "empty file"
            for n, row in enumerate(rows, start=2):
                if len(row) != len(header):
                    return f"record {n}: {len(row)} fields, header has {len(header)}"
    except (csv.Error, UnicodeDecodeError) as e:
        return f"parse error: {e}"
    return None
Module csv tự hiểu trường có bọc nháy, nên một địa chỉ viết đúng chuẩn kiểu "12 Lê Lợi, Q1" vẫn được tính là một trường.
Code đếm theo bản ghi chứ không đếm theo dòng vật lý, vì một trường có xuống dòng sẽ trải trên nhiều dòng. Kiểm tra: tạo một file có header 8 cột và một dòng 7 cột, hàm phải trả về lý do kèm số thứ tự bản ghi.
Đây mới là kiểm cấu trúc. Kiểu dữ liệu, ngày tháng, mã khách hàng có tồn tại hay không thì để một lớp kiểm khác lo, nhưng nếu file hỏng cấu trúc thì các lớp sau không cần chạy.
Lỗi dữ liệu và lỗi hạ tầng phải đi hai đường khác nhau
Đây là ý quan trọng nhất của cả job. Theo thiết kế của Appsilon, file lỗi được chuyển vào một đường dẫn cách ly và có bản ghi audit riêng giải thích chuyện gì đã xảy ra, thay vì cứ thế thử lại. Lý do rất đơn giản: file lệch số trường thì chạy lại một trăm lần vẫn lệch.
Lỗi hạ tầng như timeout hay mất kết nối thì ngược lại. Powertools xử lý trường hợp này bằng cách bắt exception, xóa bản ghi idempotency để tránh dữ liệu không nhất quán, rồi ném exception tiếp ra ngoài. Nhờ vậy lần thử sau được chạy thật, không bị coi là đã xong.
Bước 4: ghép tất cả lại
import shutil, logging

def handle(db, path, quarantine_dir, load):
    digest = sha256_of(path)
    if not claim(db, digest, path.name, path.stat().st_size):
        logging.info("skip %s (sha256 %s already in ledger)", path.name, digest)
        return "skipped"
    try:
        err = validate(path)
        if err:
            shutil.move(path, quarantine_dir / path.name)
            mark(db, digest, "quarantined", err)
            return "quarantined"
        load(path)                      # your import into the customer system
        mark(db, digest, "done", None)
        return "done"
    except Exception:
        with db:
            db.execute("DELETE FROM ledger WHERE sha256=?", (digest,))
        raise
Hàm mark chỉ là một câu UPDATE ledger SET status=?, reason=?, updated_at=datetime('now') WHERE sha256=? nằm trong transaction. Dòng log khi bỏ qua file là bắt buộc. Appsilon tóm nguyên tắc audit thành một câu: không có gì bị bỏ đi trong im lặng, mọi kết cục dù thành công hay thất bại đều được ghi lại.
Chạy lại đêm thứ ba, lần này có sổ cái
Quay lại kịch bản ban đầu, nhưng giờ đêm đó có ba file. a.csv sạch và nạp xong. b.csv có một bản ghi 7 trường trong khi header có 8, nên bị chuyển vào quarantine/ kèm lý do. c.csv đang nạp dở thì database timeout, và bản ghi của nó bị xóa.
Sáng ra bạn chạy lại. a.csv có hash đã ở trạng thái done nên bị bỏ qua và để lại một dòng log. b.csv đã nằm trong thư mục cách ly. c.csv không còn bản ghi nên được nạp lại từ đầu.
Tuần sau khách gửi a_final.csv có nội dung trùng với a.csv: cùng hash nên bị bỏ qua. Khách gửi bản b.csv đã sửa: nội dung khác thì hash khác, nên file được xử lý như một file mới.
Bốn lỗi hay gặp khi đưa job lên production
Lỗi đầu tiên là tin rằng khối except luôn chạy. Nếu process bị kill cứng, chẳng hạn hết RAM, nhận SIGKILL hay máy khởi động lại, thì không có exception nào được bắt. Bản ghi in_progress nằm đó mãi, và đêm nào file cũng bị bỏ qua như thể đang có worker khác xử lý.
Cách sửa là coi bản ghi in_progress quá N giờ là bản ghi chết và cho phép giành lại. Bản phác thảo dưới đây chạy ở đầu mỗi lần job khởi động:
def reclaim_stale(db, hours=6):
    with db:
        db.execute(
            "DELETE FROM ledger WHERE status='in_progress' "
            "AND updated_at < datetime('now', ?)",
            (f"-{hours} hours",))
N phải lớn hơn thời gian chạy dài nhất của một file thật, nếu không bạn sẽ giành mất file mà một worker còn sống vẫn đang nạp. Kiểm tra: chèn tay một bản ghi in_progress có updated_at lùi 7 giờ, chạy job, rồi xác nhận file đó được xử lý lại.
Lỗi thứ hai là cho sổ cái hết hạn quá sớm. Theo mặc định, Powertools cho bản ghi idempotency hết hạn sau một giờ (3600 giây). Mặc định đó hợp với API request, nhưng không hợp với file mà khách có thể gửi lại sau ba tuần. Sổ cái file nên được giữ ít nhất bằng khoảng thời gian khách còn có thể gửi lại dữ liệu cũ.
Lỗi thứ ba là để hàm load nạp từng dòng thẳng vào bảng thật. Nếu job chết ở dòng 5.000, việc xóa bản ghi ledger chỉ giúp file được chạy lại, còn 5.000 dòng đã nạp thì vẫn nằm đó. Bạn nên nạp vào bảng staging trong một transaction rồi mới chuyển sang bảng thật, hoặc upsert theo khóa nghiệp vụ, để chính bước nạp cũng idempotent.
Lỗi thứ tư là đọc file khi SFTP còn đang ghi. Bản phác thảo này chưa xử lý chuyện đó. Ở môi trường thật, bạn nên thỏa thuận với khách một quy ước báo hiệu file đã ghi xong, ví dụ upload với tên tạm rồi đổi tên, hoặc gửi kèm một file checksum để so với hash bạn tự tính.
Khi khách hỏi “file của tôi đâu rồi?”
Sổ cái phát huy tác dụng mỗi khi khách hỏi câu đó. Có sổ cái, bạn trả lời được trong một phút: file nào, nhận lúc nào, hash là gì, đã nạp xong hay bị cách ly vì bản ghi thứ mấy sai. Không có sổ cái, bạn phải lục log và đoán.
Nếu bạn đang chuẩn bị chuyển sang FDE, hãy đưa job này lên GitHub cùng bộ test cho năm tình huống: file sạch, file sai cấu trúc, timeout giữa chừng, process bị kill và file trùng nội dung khác tên. Trong CV, đừng chỉ viết “xây ETL”; hãy viết cụ thể rằng pipeline chạy lại không bị trùng và có audit cho từng file.
Khi đọc JD, nếu thấy vai trò có phần nhận dữ liệu định kỳ từ khách, hãy chuẩn bị sẵn câu chuyện về job này. Điều đáng hỏi là chuyện gì xảy ra khi job chết lúc 2 giờ sáng, và câu trả lời của bạn nên là “chạy lại thôi”.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!