Bản tóm tắt hợp đồng không sai chữ nào vẫn có thể bỏ sót điều khoản
Model context dài hay quên phần giữa tài liệu, nên hãy chia nhỏ bằng map-reduce hoặc refine rồi đối chiếu với danh mục điều khoản.
Tóm tắt nhanh
- LLM thường dùng thông tin ở đầu và cuối ngữ cảnh tốt hơn thông tin nằm ở giữa, nên tóm tắt cả 300 trang trong một lần gọi rất dễ làm rơi điều khoản.
- Map-reduce cho phép xem lại bản tóm tắt của từng phần. Refine để lại các phiên bản trung gian, nhờ đó lần ra được bước nào đã làm mất một điều khoản.
- Một bản tóm tắt trung thực chưa chắc đã đủ. Hãy đo completeness bằng cách đối chiếu với danh mục điều khoản lấy ra từ chính văn bản.
Thử hình dung thế này. Phòng pháp chế của khách gửi bạn một hợp đồng khung 300 trang và cần bản tóm tắt trước buổi họp thứ Sáu.
Bạn đưa cả file vào một model có context dài, nhận về hai trang gọn gàng, đọc lại thấy không câu nào sai. Ba tuần sau, luật sư của khách hỏi sao bản tóm tắt không nhắc gì đến điều khoản gia hạn tự động ở trang 180.
Trong tình huống này model không bịa ra điều gì. Nó chỉ bỏ sót, và với hợp đồng thì bỏ sót nguy hiểm không kém viết sai. Bài này hướng dẫn cách dựng một pipeline tóm tắt có thể trả lời câu hỏi mà khách nào cũng sẽ hỏi: “Có điều khoản nào bị bỏ sót không?”
Đây là việc mà một FDE làm với khách pháp lý, mua sắm hay bảo hiểm sẽ gặp từ rất sớm. Làm cho bản tóm tắt nghe hay thì dễ. Phần khó là chứng minh được nó đầy đủ.
Vì sao một lần gọi lại làm rơi điều khoản?
Nghiên cứu “Lost in the Middle”, đăng trên TACL tập 12 năm 2024, cho thấy LLM thường làm tốt nhất khi thông tin cần dùng nằm ở đầu hoặc cuối ngữ cảnh. Khi thông tin nằm ở giữa một ngữ cảnh dài, hiệu năng giảm đáng kể. Các tác giả ghi nhận hiện tượng này cả ở những model được thiết kế riêng cho context dài.
Với một hợp đồng 300 trang, “phần giữa” là gần như toàn bộ phần thân. Các nghĩa vụ mà khách cần nắm, như trách nhiệm, bồi thường, chấm dứt hay gia hạn, thường nằm rải rác trong phần thân đó chứ không gói gọn ở vài trang đầu hay cuối.
Vì thế, cách khắc phục không phải là tìm một model có context dài hơn. Bạn cần chia nhỏ tài liệu để không điều khoản nào phải nằm ở giữa một ngữ cảnh quá dài. Có hai cách chia phổ biến.
Map-reduce hay refine: chọn theo câu hỏi của khách
Tài liệu của một phiên bản LangChain cũ (0.0.149) mô tả chain map_reduce như sau: tóm tắt riêng từng phần, sau đó gộp các bản tóm tắt con lại. Chain refine thì làm tuần tự: giữ một bản tóm tắt và cập nhật nó mỗi khi đọc thêm một phần. Cả hai đều có thể trả về intermediate steps, tức các bước trung gian, để bạn xem lại.
Tài liệu LangGraph hiện nay mô tả cùng ý tưởng dưới tên orchestrator-worker. Orchestrator chia việc, các worker chạy song song qua Send API, rồi một synthesizer gom kết quả của các worker thành một kết quả cuối. Dù dùng thư viện nào, cấu trúc vẫn là map-reduce.
Map-reduce
- Mỗi phần được tóm tắt độc lập, nên chạy song song được
- Bản tóm tắt con của từng phần là bằng chứng để đối chiếu từng điều khoản
- Dễ mất liên kết giữa các điều, chẳng hạn một định nghĩa ở Điều 1 làm đổi nghĩa Điều 14
Refine
- Đọc tuần tự, giữ được mạch giữa các điều khoản
- Mỗi phiên bản trung gian cho biết bản tóm tắt thay đổi ra sao sau từng phần
- Chậm hơn, và một phần đọc sau có thể ghi đè, làm mất điều khoản đã ghi ở bước trước
Có một quy tắc dễ áp dụng. Nếu khách cần một danh sách điều khoản đầy đủ để rà soát, hãy chọn map-reduce. Nếu khách cần một bản tường thuật hiểu được logic của cả hợp đồng, hãy chọn refine, nhưng phải lưu lại mọi phiên bản trung gian.
Ví dụ: chia theo điều khoản, không chia theo số token
Sai lầm đầu tiên thường gặp là cắt hợp đồng cứ mỗi N token một đoạn. Cách đó có thể cắt đôi một điều khoản và làm rơi số hiệu của nó. Hãy cắt theo cấu trúc mà luật sư dùng: Điều, Khoản, Section.
import re

HEADING = re.compile(r"^(Điều|Khoản|Section|Article)\s+(\d+(?:\.\d+)*)", re.M)

def split_by_clause(text):
    marks, parent = [], None
    for m in HEADING.finditer(text):
        kind, num = m.group(1), m.group(2)
        if kind == "Khoản" and parent:
            cid = f"{parent}.{num}"  # Khoản 2 của Điều 14 -> "14.2"
        else:
            parent = num
            cid = num
        marks.append((m.start(), cid))
    chunks = []
    for i, (start, cid) in enumerate(marks):
        end = marks[i + 1][0] if i + 1 < len(marks) else len(text)
        chunks.append({"clause_id": cid, "text": text[start:end]})
    return chunks

MAP_PROMPT = """Định nghĩa của hợp đồng: {dinh_nghia}
Tóm tắt điều khoản dưới đây theo đúng các định nghĩa trên. Trả về JSON:
{{"clause_id": ..., "loai": ..., "nghia_vu": ..., "trich_dan": "<câu gốc quan trọng nhất>"}}
Không bỏ qua điều khoản dù nó có vẻ thủ tục.

{dieu_khoan}"""

def map_prompt(chunk, dinh_nghia):
    return MAP_PROMPT.format(dinh_nghia=dinh_nghia, dieu_khoan=chunk["text"])
Hai chi tiết nhỏ đáng để ý. Khoản được gắn với Điều đang chứa nó, nên Khoản 2 của Điều 14 có id “14.2” thay vì trùng với mọi “Khoản 2” khác. Còn trong MAP_PROMPT, dấu ngoặc nhọn của JSON mẫu được viết đôi {{ }} để .format() không hiểu nhầm chúng là placeholder.
Điểm mấu chốt nằm ở hàm split_by_clause. Nó cho bạn một danh mục điều khoản lấy bằng code, không phụ thuộc vào model. Đây là đáp án để chấm bài. Bước map nhận kèm danh sách định nghĩa và trả về JSON có clause_id, bước reduce gom các JSON đó thành bản tóm tắt cho khách.
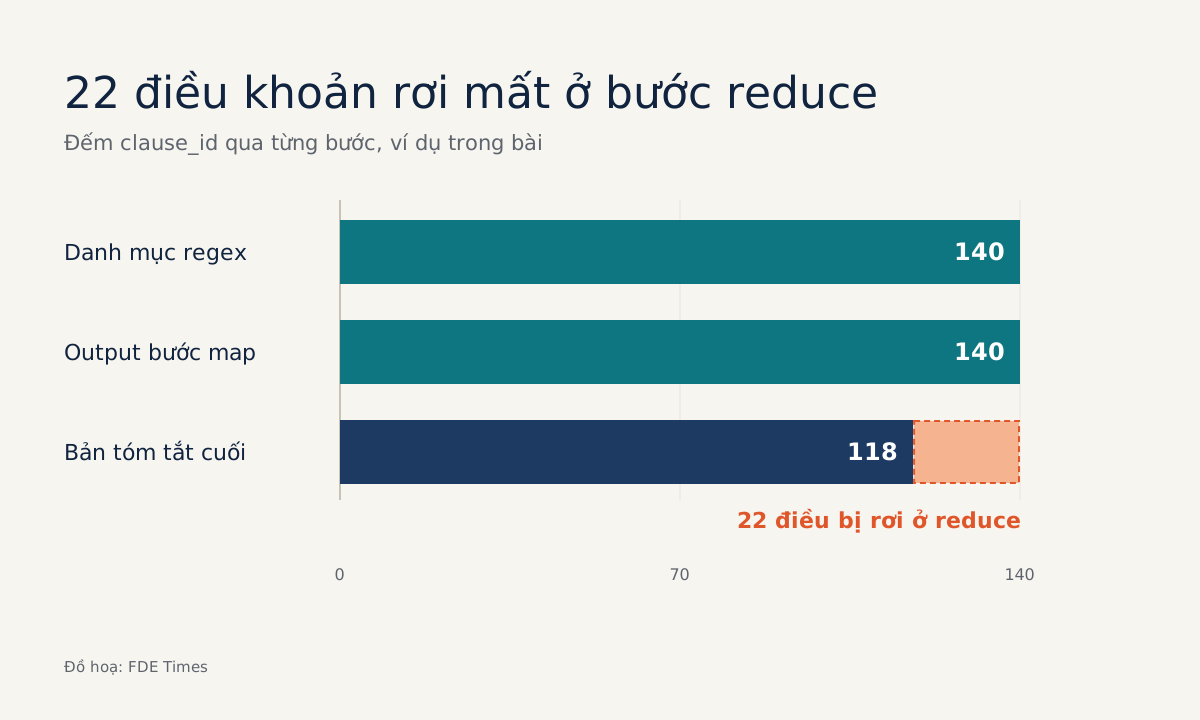
Bây giờ đến phép tính quan trọng nhất. Giả sử regex tìm được 140 điều khoản. Bạn đếm xem có bao nhiêu clause_id xuất hiện trong output của bước map, rồi đếm tiếp trong bản tóm tắt cuối. Nếu bước map có đủ 140 mà bản cuối chỉ nhắc đến 118, thì 22 điều đã bị rơi ở bước reduce, và bạn biết chính xác đó là 22 điều nào.
Faithfulness không trả lời được câu hỏi về bỏ sót
Một benchmark đa lĩnh vực công bố năm 2025 xếp việc bỏ sót thông tin quan trọng vào cùng nhóm vấn đề đã biết của tóm tắt bằng LLM, cạnh hallucination và sự lặp lại.
Benchmark này chấm bản tóm tắt theo ba chiều riêng: faithfulness, completeness và conciseness. Các tác giả cũng lưu ý rằng nhiều benchmark trước đó chỉ đo faithfulness, tức mức độ nhất quán với sự thật trong văn bản gốc.
Điều đó áp dụng trực tiếp vào hợp đồng. Bản tóm tắt ở phần mở đầu có faithfulness tuyệt đối vì không có câu nào sai. Nhưng completeness của nó thấp, và completeness mới là chiều đo những điều khoản bị mất.
Vì thế, eval của bạn cần hai phần tách biệt. Kiểm faithfulness bằng cách đối chiếu trich_dan với văn bản gốc. Kiểm completeness bằng ma trận coverage: mỗi hàng là một clause_id từ regex, các cột là “có trong output map”, “có trong bản cuối” và “loại điều khoản”.
Khi điều khoản bị rơi, tìm xem rơi ở đâu
Ma trận coverage cho bạn biết điều khoản nào bị mất. Intermediate steps cho bạn biết nó mất ở bước nào. Với map-reduce, nếu một điều không có trong output map thì lỗi nằm ở prompt map hoặc ở cách chia. Nếu nó có trong output map nhưng không có ở bản cuối, bước reduce đã nén quá tay.
Với refine, nhớ rằng chain đọc các phần theo thứ tự, nên một phần đến sau có thể ghi đè lên những gì đã ghi nhận trước đó. Thử hình dung Điều 47 có mặt ở phiên bản thứ 12 nhưng biến mất ở phiên bản thứ 13.
Như vậy chính lần cập nhật thứ 13 đã đẩy Điều 47 ra khỏi bản tóm tắt. Cách sửa là thêm vào prompt refine yêu cầu giữ nguyên danh sách các điều khoản đã ghi nhận, rồi chạy lại.
Sau khi sửa, đừng chạy lại cả pipeline rồi hy vọng lần này sẽ ổn. Hãy chạy riêng các điều bị rơi, ghép chúng vào bản tóm tắt dưới một mục rõ ràng, và để ma trận coverage xác nhận đã đủ 140 trên 140.
Những lỗi khiến bạn mất lòng tin của khách
Lỗi thứ nhất là trình bày bản tóm tắt mà không kèm con số coverage. Luật sư không tin một bản tóm tắt chỉ vì nó viết hay. Họ tin khi thấy dòng chữ “đã đối chiếu 140 trên 140 điều khoản” kèm theo bảng chi tiết.
Lỗi thứ hai là để model tự lập danh mục điều khoản. Như thế chính hệ thống có thể bỏ sót lại tự chấm xem mình có bỏ sót không. Danh mục gốc phải đến từ cấu trúc của văn bản, lấy bằng regex hoặc parser.
Lỗi thứ ba là bỏ qua phụ lục và định nghĩa. Một định nghĩa ở đầu hợp đồng có thể thay đổi nghĩa của một điều khoản ở trang 200. Vì vậy hãy đưa danh sách định nghĩa vào prompt của từng bước map, để mỗi điều khoản được tóm tắt theo đúng nghĩa đã định, và đưa cả vào prompt reduce.
Thể hiện kỹ năng này trên CV
Với hồ sơ ứng tuyển FDE, một dòng như “dựng pipeline tóm tắt tài liệu dài có kiểm coverage ở cấp điều khoản” có giá trị hơn nhiều so với “có kinh nghiệm với LLM”. Khi đọc job description, hãy để ý các cụm như document intelligence, evals hay legal tech. Đó là những nơi kỹ năng này được dùng hằng ngày.
Khi phỏng vấn, nếu được hỏi cách đánh giá một bản tóm tắt, hãy trả lời theo hai chiều faithfulness và completeness, rồi mô tả ma trận coverage. Tách rạch ròi hai chiều này là cách cho người phỏng vấn thấy bạn đã từng phải trả lời câu hỏi “có sót điều nào không” của một khách thật.
Khách sẽ không nhớ bản tóm tắt của bạn hay đến đâu. Họ sẽ nhớ có lần một điều khoản bị bỏ sót và bạn đã không phát hiện ra.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Lost in the Middle: How Language Models Use Long Contexts
- Lost in the Middle: How Language Models Use Long Contexts (TACL 2024) · 2024
- Summarization (LangChain 0.0.149 documentation notebook)
- LangGraph workflows and agents - Docs by LangChain
- Towards Multi-dimensional Evaluation of LLM Summarization across Domains and Languages