Để LLM tự chấm và sửa thư, phần khó nhất là biết lúc dừng
Mẫu gốc của Anthropic dừng khi đạt PASS nhưng không có trần số vòng, nên bản chạy với khách thật phải tự thêm điểm dừng.
Tóm tắt nhanh
- Mẫu cookbook của Anthropic trả kết quả khi đạt PASS nhưng không có trần số vòng, nên bản chạy thật phải tự thêm.
- Evaluator chỉ có ích khi tiêu chí rõ ràng; bằng chứng về việc model tự sửa còn trái chiều, nên tiêu chí nào đo được thì để code đo.
- Hãy thử prompt một lần trước, chỉ dựng vòng lặp khi cách đơn giản không đủ.
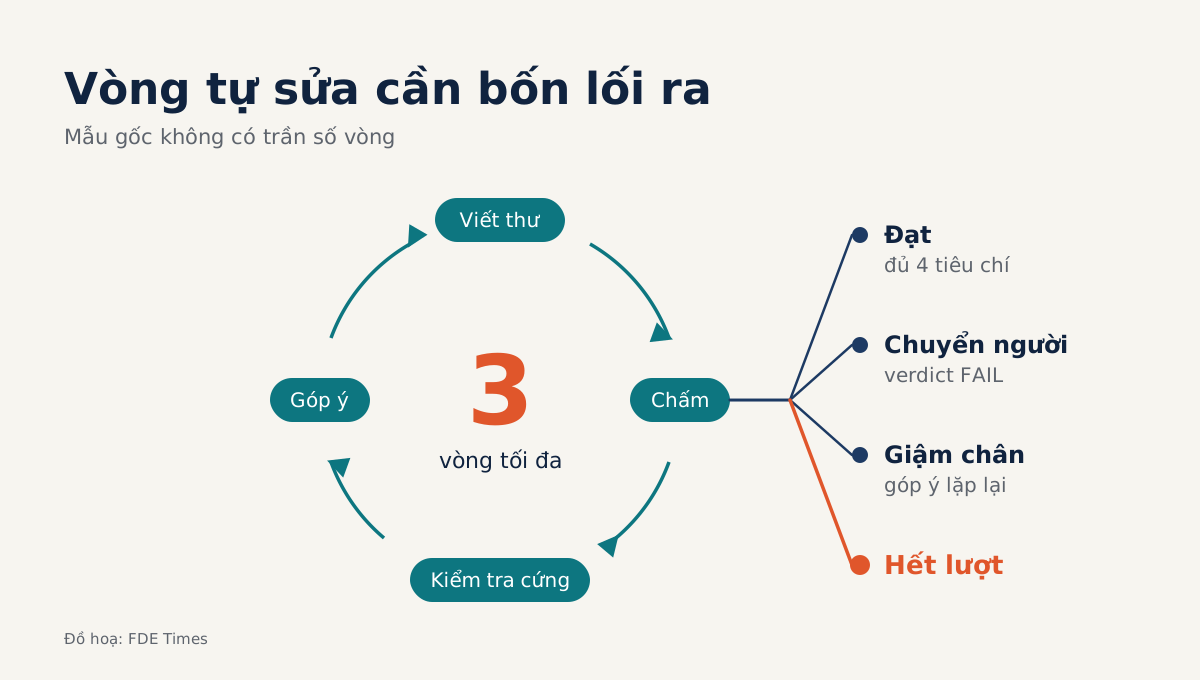
Trong notebook mẫu về evaluator–optimizer của Anthropic, vòng lặp là một while True: và chỉ trả kết quả khi evaluator nói đúng chữ PASS. Mẫu này không có trần số vòng. Nếu evaluator không bao giờ hài lòng, code cứ thế chạy tiếp.
Trong một notebook thì chuyện đó vô hại. Đến khi bạn dựng hệ thống soạn thư trả lời khách hàng cho một công ty, nó thành vấn đề thật: mỗi vòng tốn thêm lời gọi model và thêm thời gian chờ, trong khi bản nháp có thể chẳng khá hơn chút nào.
Chính Anthropic cũng viết rằng các vòng lặp agent thường kèm điều kiện dừng, chẳng hạn số vòng tối đa, để giữ quyền kiểm soát.
Bài này dựng vòng lặp đó bằng Python, từ đầu đến khi nó biết dừng. Kết quả là một hàm nhận yêu cầu của khách, trả về bản nháp kèm lý do dừng, và giữ lịch sử từng vòng để bạn đưa cho khách hàng xem.
Chuẩn bị gì trước khi gõ dòng đầu tiên?
Bạn cần Python 3, tài khoản API của một nhà cung cấp model và một bộ thư mẫu. Các ví dụ dưới đây gọi model qua một hàm call_model để trống. Phần này được rút gọn: bạn tự nối hàm vào SDK đang dùng, vì mỗi SDK một cú pháp.
Ví dụ xuyên suốt bài: một khách hỏi vì sao khoản hoàn tiền của họ đến chậm. Thư trả lời đạt yêu cầu khi nêu đúng mã đơn, đưa ra mốc thời gian, không hứa vượt quá chính sách và dài không quá 120 từ.
Bước 1: thử một lần gọi trước đã
Vòng lặp nào cũng nhân số lời gọi model lên. Vì thế, trước khi viết nó, hãy chạy một prompt duy nhất trên 10 thư mẫu để biết cách đơn giản nhất đã đủ hay chưa.
def call_model(system: str, prompt: str) -> str:
    """Rút gọn: nối vào SDK bạn dùng, trả về văn bản."""
    raise NotImplementedError

def generate(task: str, feedback: str = "") -> str:
    system = "Bạn soạn thư trả lời khách hàng, ngắn gọn, đúng chính sách."
    prompt = task if not feedback else f"{task}\n\nSửa theo góp ý:\n{feedback}"
    return call_model(system, prompt)
Kiểm tra: đọc 10 bản nháp, đánh dấu tiêu chí nào bị trượt. Nếu cả 10 đều đạt thì bạn dừng ở đây, không cần vòng lặp nào.
Bước 2: viết rubric mà người cũng chấm được
Theo Anthropic, workflow này phát huy tác dụng khi có tiêu chí chấm rõ ràng. Notebook mẫu thêm một dấu hiệu nữa: chính model phải đưa ra được góp ý có ý nghĩa.
Thử điều đó ngay trên các thư trượt ở bước 1: tự viết một dòng góp ý cụ thể, gọi lại generate, xem thư có khá hơn không. Nếu góp ý của người còn không cứu được bản nháp, evaluator cũng khó làm hơn.
RUBRIC = """Chấm thư theo 4 tiêu chí:
1. Nêu đúng mã đơn hàng.
2. Đưa ra mốc thời gian cụ thể cho khoản hoàn tiền.
3. Không hứa điều gì vượt quá chính sách được cung cấp.
4. Không quá 120 từ.
Chỉ trả PASS nếu đạt cả 4 tiêu chí và không còn góp ý nào."""
Câu cuối của rubric quan trọng nhất: nó buộc evaluator chỉ trả PASS khi không còn gì để chê.
Bước 3: bắt evaluator trả JSON, không trả văn xuôi
Notebook gốc so chuỗi verdict với PASS. Bản dưới đây mở rộng thành ba giá trị PASS, NEEDS_IMPROVEMENT, FAIL và gói chúng trong JSON để code lấy kết luận ra mà không phải đoán ý văn xuôi.
Có hai cách làm việc này. Cách chắc nhất là bật structured outputs của Claude: tính năng này dùng constrained decoding để bảo đảm kết quả khớp schema, nên lỗi sai cấu trúc không còn xảy ra.
Lưu ý là nó chỉ hỗ trợ một phần JSON Schema, và các ràng buộc số như minimum/maximum sẽ khiến API trả lỗi 400. Giữ schema đơn giản, kiểu enum cho verdict và mảng chuỗi cho lỗi, là đủ.
Đoạn code dưới đây là cách thứ hai, rút gọn để chạy với bất kỳ SDK nào: ghi cấu trúc JSON vào prompt rồi tự parse. Nhánh except chỉ có tác dụng khi bạn không bật structured outputs, hoặc nhà cung cấp bạn dùng không có tính năng tương đương; khi đã bật, bạn có thể bỏ nó đi.
import json

def evaluate(task: str, draft: str) -> dict:
    system = RUBRIC + '\nTrả JSON: {"verdict": "PASS|NEEDS_IMPROVEMENT|FAIL", "issues": ["..."]}'
    raw = call_model(system, f"Yêu cầu của khách:\n{task}\n\nBản nháp:\n{draft}")
    try:
        return json.loads(raw)
    except json.JSONDecodeError:
        return {"verdict": "FAIL", "issues": ["evaluator trả kết quả không đọc được"]}
Kiểm tra: in ra verdict của 10 thư. Với cách tự parse, một JSON hỏng sẽ đi vào nhánh except và thư được chuyển cho người xử lý thay vì làm sập vòng lặp.
Bước 4: thêm kiểm tra cứng mà model không cãi được
Các nghiên cứu về khả năng tự sửa của model đến nay vẫn chưa ngã ngũ. Self-Refine của Madaan và cộng sự cho thấy một LLM tự góp ý rồi tự sửa bài của chính nó có thể tốt lên qua nhiều vòng.
Nhưng nghiên cứu “Large Language Models Cannot Self-Correct Reasoning Yet” lại thấy LLM khó tự sửa câu trả lời khi không có phản hồi từ bên ngoài, đôi khi còn sửa thành tệ hơn.
Giám khảo cũng có thiên kiến. Một nghiên cứu khác ghi nhận GPT-4 tự ưu ái đáng kể khi chấm, và các LLM chấm cao hơn hẳn người với những văn bản quen thuộc với chúng, đo bằng perplexity thấp.
Vì vậy, tiêu chí nào đo được bằng code thì để code đo. Tiêu chí 1 và 4 trong ví dụ thuộc loại này:
def hard_checks(draft: str, order_id: str) -> list[str]:
    issues = []
    if order_id not in draft:
        issues.append(f"Thiếu mã đơn {order_id}.")
    if len(draft.split()) > 120:
        issues.append("Thư dài quá 120 từ.")
    return issues
Với hai tiêu chí còn lại, bạn có thể dùng một model khác để chấm, hoặc ít nhất đối chiếu điểm của nó với điểm do người chấm trên vài chục thư.
Bước 5: bốn cách để vòng lặp dừng
Đây là phần mà mẫu gốc bỏ ngỏ. Một preprint năm 2026 coi việc chọn lúc dừng là bài toán dừng tối ưu: chỉ sửa tiếp khi mức cải thiện kỳ vọng còn đáng với chi phí. Hàm dưới đây là phiên bản thực dụng của ý đó, với bốn lối ra: đạt, chuyển người, giậm chân tại chỗ và hết lượt.
MAX_ROUNDS = 3

def run(task: str, order_id: str):
    feedback, history = "", []
    for round_no in range(1, MAX_ROUNDS + 1):
        draft = generate(task, feedback)
        verdict = evaluate(task, draft)
        hard = hard_checks(draft, order_id)
        issues = hard + verdict.get("issues", [])
        history.append({"round": round_no, "draft": draft, "issues": issues})
        if verdict.get("verdict") == "PASS" and not hard:
            return draft, "pass", history
        if verdict.get("verdict") == "FAIL":
            return draft, "escalate", history
        if len(history) > 1 and issues == history[-2]["issues"]:
            return draft, "stalled", history
        feedback = "\n".join(issues)
    return draft, "max_rounds", history
Tính nhẩm chi phí: với MAX_ROUNDS = 3, trường hợp xấu nhất là 3 lần viết cộng 3 lần chấm, tức 6 lời gọi model cho một thư. Nhánh stalled là cách đơn giản nhất để đoán rằng vòng tiếp theo sẽ không mang lại gì: lỗi y hệt vòng trước thì sửa thêm chỉ tốn tiền.
Chọn FAIL thành chuyển cho người là thiết kế riêng của bài này, vì mẫu gốc chỉ thoát ở PASS. Nó khớp với điều Anthropic mô tả: agent có thể dừng lại chờ người góp ý ở các điểm kiểm tra hoặc khi gặp chỗ vướng. Một thư bị đánh giá là hỏng từ gốc thì sửa câu chữ không giải quyết được.
Kiểm tra: chạy lại 10 thư mẫu và đếm số thư rơi vào từng lý do dừng. Nếu phần lớn kết thúc ở max_rounds, vấn đề thường nằm ở rubric hoặc ở prompt viết thư, không phải do thiếu vòng.
Những lỗi hay gặp
Lỗi phổ biến nhất là rubric mơ hồ kiểu “thư phải lịch sự, chuyên nghiệp”. Evaluator sẽ đưa ra góp ý chung chung, bản nháp đổi chữ liên tục mà không tốt lên, và vòng lặp cứ thế chạy cho đến khi hết lượt.
Lỗi thứ hai là để PASS của model đè lên kiểm tra cứng: trong code trên, thư thiếu mã đơn không bao giờ thoát ra được qua nhánh pass.
Lỗi thứ ba là vứt history đi. Danh sách đó cho bạn biết tiêu chí nào làm vòng lặp tốn nhiều lượt nhất, và đó là dữ liệu tốt nhất để sửa prompt.
Ở chỗ khách hàng, kỹ năng này trông thế nào?
Trong một dự án thật, rubric không do bạn tự nghĩ ra. Bạn ngồi với trưởng nhóm chăm sóc khách hàng, lấy những thư họ từng phải sửa và biến từng lý do sửa thành một tiêu chí kiểm chứng được. Đó là customer discovery thực thụ, có điều thứ bạn mang về là một hàm Python.
Khi trình bày, hãy mang bảng đếm lý do dừng thay vì vài bản nháp đẹp. Các con số dưới đây chỉ để minh họa cách đọc bảng, tiếp nối 10 thư mẫu của bài, không phải kết quả đo thật:
| Lý do dừng | Số thư | Lời gọi model mỗi thư | Tổng lời gọi |
|---|---|---|---|
| pass ở vòng 1 | 6 | 2 | 12 |
| pass ở vòng 2 | 2 | 4 | 8 |
| stalled ở vòng 2 | 1 | 4 | 4 |
| escalate ở vòng 1 | 1 | 2 | 2 |
Đọc bảng này, khách thấy ngay ba điều: 8 trên 10 thư tự đi được, 2 thư đến tay người kèm lịch sử góp ý, và cả lô tốn 26 lời gọi so với mức trần 60. Thư stalled là chỗ đáng mở history ra xem: nếu nó kẹt vì thiếu mốc thời gian, có thể chính sách hoàn tiền chưa được đưa vào prompt.
Nếu muốn ghi vào CV, đừng viết “xây dựng agent tự sửa lỗi”. Hãy viết rằng bạn thiết kế vòng chấm và sửa có trần số vòng và có nhánh chuyển người, kèm tỷ lệ thư đạt ngay từ vòng đầu. Khi phỏng vấn, chuẩn bị sẵn lời giải thích về giới hạn của hệ thống: khi nào nó dừng, và ai nhận việc khi nó dừng.
Khách hàng sẽ không hỏi model của bạn sửa thư giỏi đến đâu. Họ sẽ hỏi điều gì xảy ra khi nó không sửa được, và hàm run của bạn cần có sẵn câu trả lời.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Building effective agents (Anthropic Engineering) · 2024-12-19
- evaluator_optimizer.ipynb (anthropics/claude-cookbooks, patterns/agents)
- Large Language Models Cannot Self-Correct Reasoning Yet · 2023-10-03
- Self-Preference Bias in LLM-as-a-Judge · 2024-10-29
- Structured outputs (Claude Docs)
- Self-Refine: Iterative Refinement with Self-Feedback · 2023-03-30
- Optimal Stopping of Self-Refining Foundation Models · 2026-08-11