Agent có 80 tool chọn sai nhiều hơn: đừng nạp hết vào context
Hãy giữ vài tool lõi, gom phần còn lại theo tiền tố và để agent tự tìm khi cần đến.
Tóm tắt nhanh
- Khi agent có quá 30–50 tool, khả năng chọn đúng tool giảm xuống. Định nghĩa tool có thể chiếm hàng chục nghìn token trước khi người dùng gõ chữ nào.
- Nên giữ 3–5 tool dùng nhiều nhất luôn nạp sẵn, gom phần còn lại theo tiền tố như github_, slack_ và hoãn nạp chúng.
- defer_loading chỉ quyết định thứ gì vào context: bạn vẫn phải gửi đủ mọi định nghĩa trong mỗi request.
Bạn vừa nối agent của khách hàng vào sáu MCP server: GitHub, Slack, Jira, CRM, hệ thống kho và hệ thống hóa đơn. Bản demo chạy được. Nhưng khi đếm lại, agent đang có 80 tool, và người dùng thử nghiệm bắt đầu phàn nàn rằng hỏi “ticket nào đang mở” thì agent lại đi tạo ticket mới.
Sửa system prompt khó chữa tận gốc lỗi này, vì nhiều khả năng vấn đề nằm ở số tool mà agent phải nhìn cùng lúc. Tài liệu của Anthropic về tool search ghi rõ rằng khả năng chọn đúng tool của Claude giảm khi số tool vượt khoảng 30–50. Với 80 tool, bạn đã ở sâu trong vùng nguy hiểm.
Kỹ năng cần có ở đây là thiết kế cách agent nhìn thấy tool: tool nào luôn hiện sẵn, tool nào gom thành nhóm, tool nào chỉ nạp khi cần. Một FDE làm tốt việc này sẽ vừa giảm chi phí vừa tăng độ chính xác, thay vì ngồi vá system prompt từng câu một.
Tám mươi tool tốn kém ở chỗ nào?
Chi phí đầu tiên là token. Anthropic đưa ra ví dụ một cấu hình gồm năm MCP server với 58 tool, trong đó riêng phần định nghĩa tool đã chiếm khoảng 55K token trước khi cuộc hội thoại bắt đầu. Công ty này cũng cho biết đã gặp trường hợp định nghĩa tool chiếm tới 134K token trước khi được tối ưu.
Thử làm một phép tính: 55K chia cho 58 ra trung bình khoảng 950 token mỗi tool. Nếu tool của khách hàng bạn có độ dài tương tự, 80 tool sẽ chiếm chừng 76K token. Đó chỉ là ước lượng thô, nhưng đủ để thấy một phần lớn context đã bị dùng hết trước khi người dùng gõ câu đầu tiên.
Chi phí thứ hai đắt hơn, đó là độ chính xác. Theo Anthropic, khi bộ tool lớn, hai lỗi phổ biến nhất là chọn sai tool và truyền sai tham số. Khi jira_search_issues và jira_create_issue nằm cạnh 78 tool khác, ranh giới giữa chúng mờ đi, và đó đúng là lỗi người dùng thử nghiệm đang gặp.
Gom nhóm trước, hoãn nạp sau
Ý tưởng cốt lõi khá đơn giản. Agent không cần thấy cùng lúc mọi tool, nó chỉ cần tìm ra đúng tool vào đúng lúc. Lời khuyên của Anthropic là giữ ba đến năm tool dùng nhiều nhất luôn nạp sẵn và hoãn nạp phần còn lại.
Nhưng việc hoãn nạp chỉ hiệu quả khi agent tìm lại được tool. Vì thế, bước gom nhóm phải làm trước. Tài liệu của Claude khuyên đặt tên tool theo tiền tố nhất quán theo dịch vụ hoặc tài nguyên, như github_ hay slack_, để một lượt tìm khớp được cả nhóm. Tài liệu này cũng gợi ý liệt kê các nhóm tool trong system prompt.
OpenAI đi theo hướng tương tự: tool search của họ nạp tool động và khuyên gom tool theo namespace hoặc theo MCP server. Họ còn đưa ra một con số cụ thể là nên giữ mỗi namespace dưới 10 function để tiết kiệm token và giúp model làm tốt hơn.
Một ví dụ: agent vận hành cho công ty logistics
Quay lại 80 tool ở trên. Bước một là ngồi cùng người dùng thật và hỏi họ làm gì nhiều nhất mỗi ngày. Giả sử câu trả lời là tra đơn hàng, xem trạng thái lô hàng, tìm ticket và nhắn vào kênh Slack của ca trực. Bốn tool đó là phần lõi luôn nạp sẵn.
Còn lại 76 tool. Muốn mỗi nhóm dưới 10 tool, tức tối đa 9 tool, thì phép chia đơn giản cho thấy bạn cần ít nhất 9 nhóm, vì 8 nhóm chỉ chứa được 72 tool.
Trên thực tế, bạn có thể chia thành github_, slack_, jira_, crm_, billing_, rồi tách hệ thống kho lớn thành warehouse_inventory_, warehouse_inbound_, warehouse_outbound_ và warehouse_returns_. Nhóm nào vẫn quá 9 tool thì tách tiếp theo tài nguyên.
Một tool bị hoãn nạp trông như sau. Điểm cần chú ý là tên có tiền tố và mô tả nói rõ khi nào nên dùng:
{
  "name": "warehouse_inbound_list_delayed_receipts",
  "description": "Liệt kê phiếu nhập kho bị trễ so với lịch, lọc theo kho và khoảng ngày. Dùng khi người dùng hỏi hàng về trễ.",
  "input_schema": {
    "type": "object",
    "properties": {
      "warehouse_id": { "type": "string" },
      "from_date": { "type": "string", "format": "date" }
    },
    "required": ["warehouse_id"]
  },
  "defer_loading": true
}
Trong system prompt, bạn thêm một đoạn ngắn liệt kê các nhóm, ví dụ: “Tool được chia theo tiền tố: warehouse_inbound_ cho hàng nhập, billing_ cho hóa đơn…”. Khi người dùng hỏi về hàng về trễ, agent biết nên tìm theo warehouse_inbound, và cả nhóm hiện ra trong một lượt tìm.
Agent tìm tool bằng cách nào?
Claude có hai biến thể tìm kiếm chạy phía server là regex và BM25. Lời khuyên thực tế khi bắt đầu: nếu tên tool đã có tiền tố chặt chẽ như ví dụ trên, hãy thử regex trước, vì một mẫu như warehouse_inbound_.* sẽ khớp cả nhóm.
Nếu người dùng thường hỏi bằng câu tự nhiên, hãy thử thêm BM25 và để bộ eval quyết định biến thể nào chọn đúng hơn.
Nếu khách hàng có nhiều tool trùng nghĩa nhưng khác tên, bạn có thể tự viết logic tìm kiếm, chẳng hạn bằng embedding hay semantic search, rồi trả về các khối tool_reference từ một tool tùy chỉnh. Hãy để dành lựa chọn này cho lúc regex và BM25 đã thất bại trên bộ eval của bạn, đừng chọn nó từ đầu.
Khi lên production, đừng quên prompt cache. OpenAI nạp các tool vừa tìm được vào cuối context window để prompt cache giữ nguyên giữa các request. Bài học áp dụng được ở mọi nơi: phần đầu context gồm system prompt và tool lõi nên giữ ổn định, đừng thay đổi thứ tự giữa các lượt gọi.
Những sai lầm hay gặp
Sai lầm phổ biến nhất là nghĩ rằng defer_loading làm request nhẹ đi. Tài liệu của Claude nói rõ bạn vẫn phải gửi đầy đủ định nghĩa của mọi tool trong mảng tools ở mỗi request, kể cả tool bị hoãn nạp. Cờ này chỉ quyết định thứ gì đi vào context window, vì API cần có đủ định nghĩa để tìm kiếm và mở rộng.
Sai lầm thứ hai là dùng tool search cho mọi agent. Tài liệu cho biết tool search hợp khi có từ 10 tool trở lên hoặc định nghĩa dài quá 10k token. Còn khi có dưới 10 tool, hoặc request nào cũng dùng đến mọi tool, cách gọi tool thông thường tốt hơn. Agent sáu tool của một khách hàng nhỏ không cần thêm một lớp tìm kiếm.
Sai lầm thứ ba là hoãn nạp cả tool lõi, khiến agent phải tìm kiếm ngay cả cho việc nó làm mười lần mỗi giờ. Sai lầm thứ tư là đặt tên tùy hứng kiểu getData2 hay helper_sync, làm hỏng mọi cơ chế tìm kiếm dựa trên tên.
Chứng minh bằng con số
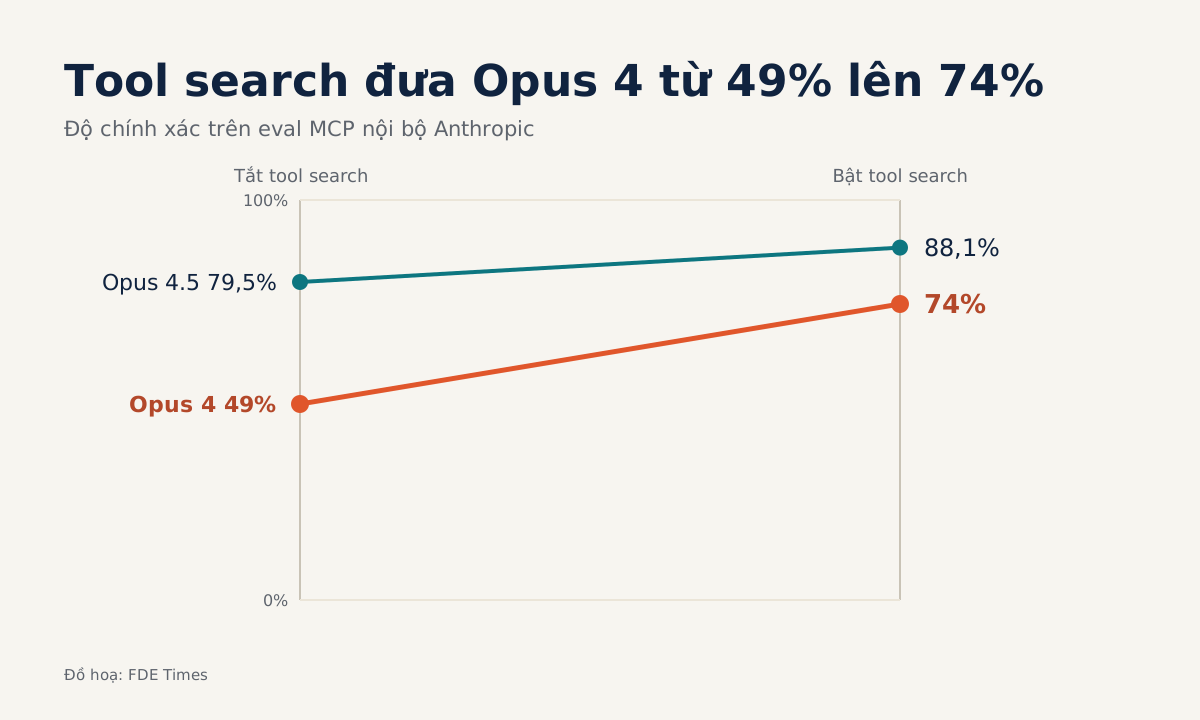
Đừng báo với khách hàng rằng agent “thông minh hơn”. Hãy đo. Trong bộ eval MCP nội bộ của Anthropic, bật Tool Search Tool giúp Opus 4 tăng từ 49% lên 74%, và Opus 4.5 tăng từ 79,5% lên 88,1%. Anthropic cũng cho biết tool search giảm 85% lượng token mà vẫn giữ được quyền truy cập toàn bộ thư viện tool.
Con số của bạn sẽ khác, vì dữ liệu và tool của khách hàng khác. Hãy làm một bộ yêu cầu thật, ghi tool đúng và tham số đúng cho từng yêu cầu, rồi chấm riêng hai loại lỗi mà Anthropic nêu: sai tool và sai tham số. Chạy trước và sau khi tái cấu trúc, cùng một bộ yêu cầu.
Kết quả đó cũng là một dòng rất tốt cho CV. Ví dụ: “Tái cấu trúc 80 tool thành 4 tool lõi và 9 nhóm có tiền tố với tool search, giảm token định nghĩa từ X xuống Y, tăng tỷ lệ chọn đúng tool từ A lên B trên bộ eval N yêu cầu”.
Dòng đó cho thấy bạn đo kết quả, chứ không chỉ kể lại việc đã làm.
Luyện tay trên agent của chính bạn
Bài tập: lấy một agent bạn đang có, hoặc tự dựng một agent nối vào hai ba MCP server công khai. In toàn bộ danh sách tool ra giấy, gạch chân 3–5 tool bạn tin là lõi, rồi xếp phần còn lại vào các nhóm có tiền tố, mỗi nhóm tối đa 9 tool.
Sau đó viết 20 yêu cầu như người dùng thật sẽ gõ, ghi tool đúng và tham số đúng cho từng câu. Chạy bộ yêu cầu với cấu hình cũ, rồi với cấu hình mới có defer_loading, và đếm riêng số lần sai tool, sai tham số. Nếu một nhóm cứ bị tìm nhầm, đó là tín hiệu tên hoặc mô tả của nhóm ấy cần viết lại.
Lần tới khi khách hàng muốn nối thêm hệ thống thứ bảy, câu hỏi đầu tiên không nên là có làm được không. Hãy hỏi tool mới thuộc nhóm nào và agent sẽ tìm thấy nó bằng cách nào.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!