Thực hành Hypothesis: cho parser dữ liệu của khách chạy qua 500 đầu vào tự sinh
Lỗi đọc sai số âm có thể lọt qua mọi test viết tay, kể cả test round-trip, nhưng khó thoát khi vài trăm dòng tự sinh được đem so với một cách tính độc lập.

Tóm tắt nhanh
- Hypothesis mặc định chạy 100 ví dụ cho mỗi test, có thể nâng lên vài trăm qua settings(max_examples=...).
- Round-trip là property mạnh, nhưng lỗi sai giống nhau ở cả hai chiều vẫn lọt qua, nên cần thêm một phép đối chiếu độc lập.
- Dùng @example để ghim dòng hỏng có thật của khách. Hypothesis lưu các ca từng fail vào .hypothesis/examples và chạy lại chúng ở lần sau.
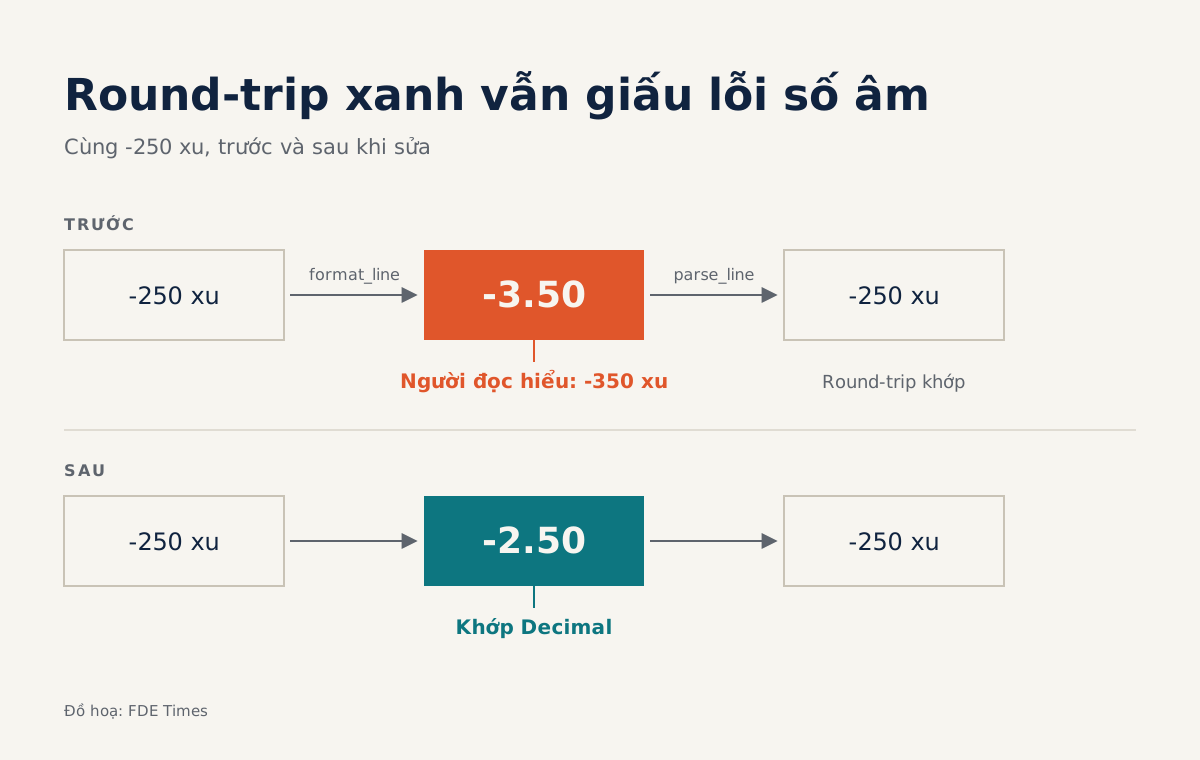
Thử hình dung khách gửi một file đơn hàng, trong đó có một dòng hoàn tiền ghi -3.50. Parser của bạn đọc nó thành -2,50. Test viết tay vẫn xanh, test round-trip cũng xanh. Lỗi chỉ lộ ra khi kế toán bên khách đối soát cuối tháng.
Parser dữ liệu khách đáng được test kỹ hơn vẻ ngoài đơn giản của nó. Bạn có thể viết nó chỉ dựa trên vài file mẫu, nhưng sau đó nó phải chạy hàng tháng trên dữ liệu bạn chưa từng thấy.
Hypothesis là thư viện Python cho property-based testing. Thay vì đoán trước từng ví dụ, bạn mô tả cả một dải kịch bản rồi để máy tự dò các khả năng.
Phần dưới đây bám theo một ví dụ duy nhất từ đầu đến cuối. Bạn sẽ viết một parser dòng đơn hàng, sinh vài trăm dòng có cấu trúc, thấy một property tưởng chặt chẽ vẫn bỏ sót lỗi ra sao, rồi ghim dòng hỏng có thật của khách vào test.
Bạn cần gì trước khi bắt đầu?
Bạn cần Python 3, pytest và Hypothesis cài trong một virtualenv (thường là pip install hypothesis pytest). Định dạng dữ liệu trong bài là giả định: mỗi dòng gồm mã đơn, ngày và số tiền, ngăn bằng dấu chấm phẩy, ví dụ ORD-00042;2024-03-07;12.50. Code được rút gọn để minh hoạ, không phải parser production.
Bước 1: một parser trông có vẻ đúng
# parser.py — bản rút gọn để minh hoạ
from dataclasses import dataclass

@dataclass
class Order:
    order_id: str
    date: str
    amount_cents: int

def parse_line(line: str) -> Order:
    order_id, date, amount = line.strip().split(";")
    whole, _, frac = amount.partition(".")
    cents = int(whole) * 100 + int((frac + "00")[:2])
    return Order(order_id, date, cents)

def format_line(o: Order) -> str:
    return f"{o.order_id};{o.date};{o.amount_cents // 100}.{o.amount_cents % 100:02d}"
Với 12.50, hàm trả về 1250. Với 12, hàm trả về 1200. Unit test cho vài dòng mẫu sẽ qua hết, và cái bẫy nằm chính ở đó.
Bước 2: mô tả dữ liệu bằng strategy, không phải bằng ví dụ
Phần khó nhất của property-based testing là sinh đầu vào phức tạp. Hillel Wayne nhận xét rằng tài liệu về PBT ít khi nói đến phần này.
Muốn ghép nhiều strategy lại, bạn dùng @composite: hàm gắn decorator này nhận draw làm tham số đầu tiên và gọi nó để lấy giá trị từ từng strategy nhỏ.
Mỗi trường được sinh bằng st.from_regex với fullmatch=True, để cả chuỗi sinh ra đều khớp mẫu.
# test_parser.py
from hypothesis import given, settings, strategies as st
from parser import Order, parse_line, format_line

@st.composite
def orders(draw):
    order_id = draw(st.from_regex(r"ORD-[0-9]{5}", fullmatch=True))
    date = draw(st.from_regex(r"20[0-9]{2}-[01][0-9]-[0-3][0-9]", fullmatch=True))
    cents = draw(st.integers(min_value=-10_000_000, max_value=10_000_000))
    return Order(order_id, date, cents)

@settings(max_examples=500)
@given(orders())
def test_round_trip(order):
    assert parse_line(format_line(order)) == order
Decorator @given biến hàm thường thành một test Hypothesis. Mặc định mỗi test chạy 100 ví dụ, còn max_examples=500 nâng con số đó lên. Chạy pytest, test xanh.
Nếu muốn có sẵn khung test để sửa tiếp, lệnh hypothesis write (Ghostwriter) sẽ sinh cho bạn một bản. Tài liệu của Ghostwriter gọi round-trip là property rất mạnh, nhất là khi các tuỳ chọn cấu hình cũng thay đổi cùng đối tượng.
Bước 3: vì sao test xanh mà parser vẫn sai?
Cho số -250 xu đi một vòng. Phép // của Python làm tròn xuống nên -250 // 100 cho -3, còn phép % lấy dấu theo số chia nên -250 % 100 cho 50. Vì thế format_line ghi ra -3.50, và parse_line đọc lại thành -300 + 50 = -250. Hai chiều sai y như nhau nên vẫn khớp nhau, trong khi với người đọc, -3.50 nghĩa là -350.
Cách sửa là thêm một property có phép đối chiếu độc lập. Bạn sinh thẳng chuỗi số tiền theo kiểu khách viết, rồi so kết quả với Decimal, một cách tính không dùng chung logic với parser:
from decimal import Decimal

@st.composite
def raw_lines(draw):
    order_id = draw(st.from_regex(r"ORD-[0-9]{5}", fullmatch=True))
    date = draw(st.from_regex(r"20[0-9]{2}-[01][0-9]-[0-3][0-9]", fullmatch=True))
    amount = draw(st.from_regex(r"-?[0-9]{1,6}\.[0-9]{2}", fullmatch=True))
    return f"{order_id};{date};{amount}", amount

@settings(max_examples=500)
@given(raw_lines())
def test_amount_matches_decimal(case):
    line, amount = case
    assert parse_line(line).amount_cents == int(Decimal(amount) * 100)
Lần này test đỏ. Hypothesis có một quá trình “simplification” (thu gọn) chạy ngầm, nên counterexample bạn nhận được thường là một dòng ngắn với số tiền âm nhỏ, chứ không phải chuỗi lộn xộn nó tình cờ tìm ra lúc đầu. Nhìn counterexample đó, bạn thấy ngay lỗi nằm ở dấu trừ.
Bước 4: sửa lỗi và ghim dòng thật của khách
Tách phần đọc số tiền ra một hàm riêng xử lý dấu trước, rồi sửa format_line cho đối xứng: ghi dấu riêng, sau đó định dạng giá trị tuyệt đối.
def parse_amount(s: str) -> int:
    sign = -1 if s.startswith("-") else 1
    whole, _, frac = s.lstrip("-").partition(".")
    return sign * (int(whole) * 100 + int((frac + "00")[:2]))

def parse_line(line: str) -> Order:
    order_id, date, amount = line.strip().split(";")
    return Order(order_id, date, parse_amount(amount))

def format_line(o: Order) -> str:
    sign = "-" if o.amount_cents < 0 else ""
    a = abs(o.amount_cents)
    return f"{o.order_id};{o.date};{sign}{a // 100}.{a % 100:02d}"
Kiểm tra lại bằng tay: -250 xu giờ được ghi thành -2.50, và parse_amount("-2.50") trả về -(200 + 50) = -250. Cả hai test round-trip và Decimal đều phải xanh.
Tiếp theo, đưa dòng hoàn tiền khách đã gửi vào test bằng @example. Hypothesis luôn chạy những đầu vào khai báo tường minh này trước khi sinh dữ liệu ngẫu nhiên:
from hypothesis import example

@example(("ORD-00042;2024-03-07;-3.50", "-3.50"))
@settings(max_examples=500)
@given(raw_lines())
def test_amount_matches_decimal(case):
    ...
Từ nay, mỗi file hỏng khách gửi đến nên để lại một dòng @example. Gom lại, chúng thành danh sách những bài học của dự án, nằm ngay trong code và vẫn còn đó khi bạn đã chuyển sang khách khác.
Bước 5: chỉnh số lần chạy và thời gian cho phép
Parser thật thường gọi regex nặng, tra bảng hoặc chuẩn hoá Unicode. Hypothesis đặt deadline mặc định 200 mili giây cho mỗi ví dụ, nên parser chậm sẽ bị báo lỗi dù kết quả vẫn đúng. Khi gặp chuyện này, hãy nới deadline trong settings có chủ đích và ghi chú lý do, đừng tắt hẳn cho xong.
Hypothesis còn lưu các ví dụ từng fail vào thư mục .hypothesis/examples trong thư mục làm việc hiện tại, rồi phát lại ở lần chạy sau. Vì thế, nếu một lỗi vừa hiện ra rồi biến mất, đừng vội cho là lỗi ngẫu nhiên. Hãy mở thư mục đó xem trước.
Những lỗi hay gặp nhất là gì?
Lỗi phổ biến nhất là viết strategy hẹp hơn dữ liệu thật: chỉ sinh số dương trong khi khách có hoàn tiền, chỉ sinh ASCII trong khi tên khách hàng có dấu. Hãy viết strategy dựa trên file mẫu và những gì hỏi được từ khách, đừng dựa trên những gì parser đang chấp nhận.
Lỗi thứ hai là để assert lặp lại chính logic của parser, đúng cái bẫy round-trip ở bước 3. Lỗi thứ ba là coi Hypothesis như thứ thay thế unit test. Tài liệu của Hypothesis nói rõ nó là phần bổ sung, nên những ca nghiệp vụ khách đã xác nhận vẫn cần được viết thành test ví dụ tường minh.
Ở site khách, kỹ năng này trông thế nào?
Ngày đầu nhận file từ khách, trước khi viết parser, hãy hỏi những câu sau này sẽ thành regex trong strategy. Số âm được viết thế nào? Ngày có lúc nào thiếu số 0 ở đầu không? Mã đơn có bao giờ đổi tiền tố không? Mỗi câu trả lời là một dòng trong @composite, còn mỗi câu “chưa chắc” là một ca nên đưa vào strategy.
Khi viết CV, hãy mô tả kỹ năng này bằng kết quả cụ thể thay vì chỉ ghi “Python”. Một dòng như “viết property-based test cho parser dữ liệu khách, ghim N ca lỗi từ production” cho người tuyển dụng thấy bạn từng xử lý dữ liệu thật, và bạn có thể đặt repo minh hoạ ngay cạnh dòng đó.
Trong phỏng vấn, kể lại cái bẫy round-trip ở bước 3 là cách nhanh để cho thấy bạn hiểu test thực sự chứng minh được điều gì.
Sớm muộn gì parser cũng sẽ gặp dữ liệu bạn chưa thấy. Việc của bạn là để vài trăm dòng tự sinh gặp nó trước kế toán của khách.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!