Con số benchmark vLLM đẹp nhất thường là con số sai
Đo TTFT, ITL và throughput bằng vllm bench serve ở đúng mức tải của khách, đưa SLO vào --goodput, rồi gửi đội hạ tầng một báo cáo mà họ tự chạy lại được.

Tóm tắt nhanh
- --request-rate mặc định là inf và nếu không đặt --max-concurrency thì số request đồng thời không có giới hạn, nên lần chạy mặc định là bài test throughput tối đa.
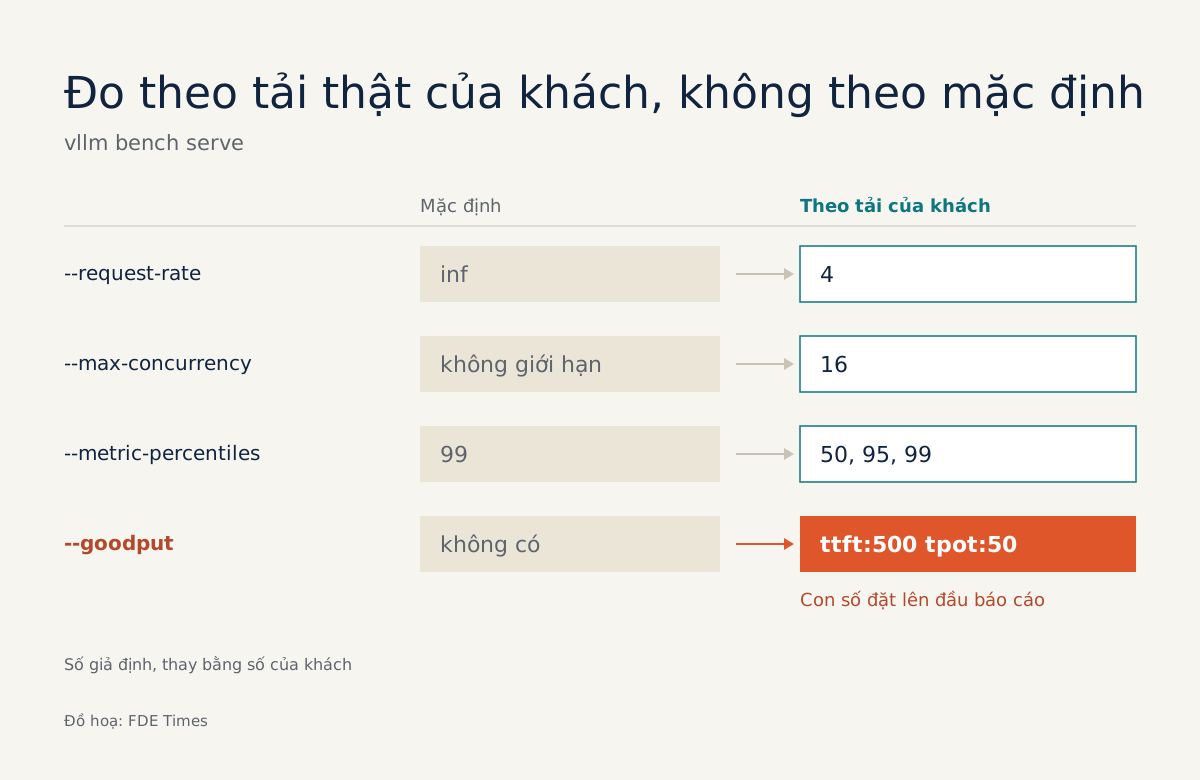
- Mặc định chỉ có p99; thêm --metric-percentiles 50,95,99 và --goodput để báo cáo bám vào SLO của khách.
- Mỗi công cụ định nghĩa chỉ số theo cách riêng, nên báo cáo phải nói rõ định nghĩa đi kèm từng con số.
Đội hạ tầng của khách hỏi bạn đúng một câu: “Endpoint này phục vụ được bao nhiêu người dùng?” Bạn chạy vllm bench serve với tham số mặc định và có một con số throughput rất đẹp.
Vấn đề là ở chế độ mặc định, công cụ gửi tất cả request cùng một lúc và không giới hạn số request đồng thời. Con số đẹp đó đang đo một kịch bản mà hệ thống của khách sẽ không bao giờ gặp.
Bài này đi qua cách đo ba nhóm chỉ số: thời gian tới token đầu tiên (TTFT), độ trễ giữa các token (ITL, TPOT) và throughput. Sau đó là cách đóng gói kết quả để một kỹ sư hạ tầng đọc xong có thể ra quyết định ngay.
Khi khách tự host model, câu hỏi về năng lực phục vụ thường đến sớm, và bạn cần số liệu đủ chắc để bảo vệ trước những người hiểu hạ tầng hơn mình.
Bạn cần chuẩn bị gì?
Bạn cần một endpoint vLLM tương thích OpenAI đang chạy (local hoặc của khách), máy client đã cài vLLM để có lệnh vllm bench serve, và quan trọng nhất là ba thông tin hỏi được từ khách: phía client của họ gửi tối đa bao nhiêu request đồng thời, request đến với tốc độ nào, và SLO độ trễ của họ là gì.
Thiếu ba thông tin này thì bạn vẫn đo được, nhưng chỉ đo cho chính bạn xem.
Một lưu ý trước khi bắt đầu: các chỉ số dưới đây đều đo tại client benchmark. Tài liệu vLLM định nghĩa TTFT là quãng thời gian tính từ khi request được gửi đi cho tới khi output stream đầu tiên về đến client.
Vì thế bạn nên đặt máy client gần với vị trí client thật của khách. Đứng ở laptop qua VPN mà đo thì kết quả bị cộng thêm độ trễ mạng.
Bước 1: chạy lệnh mẫu để có baseline
Tài liệu vLLM đưa ra lệnh mẫu benchmark endpoint /v1/completions với dataset ShareGPT, gồm model, backend và endpoint:
vllm bench serve \
  --model NousResearch/Hermes-3-Llama-3.1-8B \
  --backend vllm \
  --endpoint /v1/completions
Đây là bản rút gọn: lệnh trên chưa có phần chọn dataset và địa chỉ host của khách. Bạn chạy vllm bench serve --help trên phiên bản đang dùng để lấy đúng tên các tham số đó. Nếu chọn dataset random, mặc định mỗi request có 1024 token input và 128 token output.
Kiểm tra: output phải có request throughput, output token throughput (tok/s) và total token throughput. Có đủ ba dòng này nghĩa là client đã gọi được endpoint. Đừng mang số này cho khách, vì nó chỉ xác nhận mọi thứ đã kết nối đúng.
Bước 2: mô phỏng đúng tải của khách
Có hai tham số quyết định bài benchmark của bạn đang trả lời câu hỏi nào. --request-rate mặc định là inf, tức mọi request được bắn ra cùng lúc, đúng kiểu test throughput tối đa.
Khi đặt giá trị hữu hạn, request đến theo phân phối Poisson, giống lưu lượng thật hơn. --max-concurrency giới hạn số request đang chờ cùng lúc. Nếu bỏ trống thì không có giới hạn nào. Thêm hai tham số này vào lệnh ở bước 1:
  --request-rate 4 \
  --max-concurrency 16
Giá trị 4 và 16 ở đây là ví dụ giả định. Bạn thay bằng con số khách cung cấp, chẳng hạn connection pool của gateway họ mở tối đa bao nhiêu kết nối.
Kiểm tra: chạy lại với vài mức --max-concurrency, ví dụ 1, 8, 16, 32. Tài liệu benchmark của NVIDIA phân biệt hai loại throughput. Throughput toàn hệ thống là tổng số token output của mọi request đang chạy song song, còn throughput trên mỗi người dùng là tốc độ một người nhận được.
Khi tăng số request đồng thời, hai đại lượng này đi ngược chiều nhau. Nếu số liệu của bạn thể hiện đúng xu hướng đó, phép đo đang hợp lý.
Bước 3: báo phân vị, không báo trung bình
Tham số --percentile-metrics chọn chỉ số nào được tính phân vị. Với model sinh văn bản, mặc định là ttft,tpot,itl. Tham số --metric-percentiles chọn phân vị cần báo, và mặc định chỉ có p99. Đội hạ tầng cần thấy cả phân phối, nên bạn thêm:
  --percentile-metrics ttft,tpot,itl \
  --metric-percentiles 50,95,99
Cần hiểu rõ ba chỉ số này trước khi giải thích cho người khác. ITL ghi lại khoảng cách giữa hai output stream liên tiếp, gộp trên mọi request thành công. TPOT tính riêng cho từng request, dựa trên độ trễ end-to-end trừ đi TTFT.
Thử một ví dụ giả định để hình dung: một request mất 3.000 ms end-to-end, TTFT là 450 ms, sinh 128 token.
Phần sau token đầu tiên mất 2.550 ms; nếu chia đều cho 127 token còn lại thì được xấp xỉ 20 ms mỗi token. Đây chỉ là phép ước lượng nhẩm, còn con số chính thức bạn đưa vào báo cáo là TPOT do công cụ in ra.
Người dùng cảm nhận hai chỉ số này theo hai cách khác nhau. NVIDIA mô tả TTFT là khoảng thời gian bạn phải chờ trước khi thấy output của model. Với chatbot, đó là cảm giác “hệ thống có phản hồi không”. TPOT và ITL quyết định chữ chạy ra mượt hay giật.
Bước 4: đưa SLO của khách vào lệnh
Báo cáo trở nên hữu ích khi nó trả lời được câu “bao nhiêu request đạt yêu cầu”, chứ không dừng ở “trung bình là bao nhiêu”. --goodput nhận SLO độ trễ tính bằng mili giây dưới dạng cặp KEY:VALUE, với các khoá ttft, tpot, e2el:
--goodput ttft:500 tpot:50Ở đây 500 và 50 là SLO giả định. Kết quả sẽ cho biết bao nhiêu request đáp ứng được SLO của khách. Đây là con số bạn nên đặt lên đầu báo cáo.
Kiểm tra: giữ nguyên --goodput và quét lần lượt các mức --max-concurrency như ở bước 2, mỗi mức ghi lại cả request throughput lẫn goodput. Ở mức thấp, hai con số gần như trùng nhau vì hầu hết request đều đạt SLO.
Đến một mức nào đó, request throughput vẫn tăng nhưng goodput đứng lại hoặc tụt xuống: request vẫn xong, chỉ là quá chậm. Mức concurrency ngay trước điểm tách ra đó là câu trả lời bạn mang cho đội hạ tầng.
Bước 5: cố định độ dài output và lưu kết quả
Nếu model dừng sớm vì gặp token EOS, số token output giữa các lần chạy sẽ chênh nhau và throughput không so sánh được. --ignore-eos buộc model sinh đủ độ dài. --save-result ghi kết quả ra file JSON để bạn gửi đi.
  --ignore-eos \
  --save-result
Kiểm tra: mở file JSON và xác nhận các phân vị ở bước 3 có trong đó. File này là bằng chứng, nên mỗi file cần gắn với đúng một cấu hình.
Ghép lại thành một lệnh hoàn chỉnh
Gộp các tham số từ bước 1 đến bước 5, bạn có một lệnh chạy được một lần cho mỗi mức concurrency:
vllm bench serve \
  --model NousResearch/Hermes-3-Llama-3.1-8B \
  --backend vllm \
  --endpoint /v1/completions \
  --request-rate 4 \
  --max-concurrency 16 \
  --percentile-metrics ttft,tpot,itl \
  --metric-percentiles 50,95,99 \
  --goodput ttft:500 tpot:50 \
  --ignore-eos \
  --save-result
Lệnh này vẫn là bản rút gọn: bạn tự thêm tham số dataset và host lấy từ --help, và thay 4, 16, 500, 50 bằng số của khách. Khi quét concurrency, chỉ đổi đúng một giá trị --max-concurrency mỗi lần để các file JSON so được với nhau.
Những lỗi khiến số liệu không đứng vững
Lỗi phổ biến nhất là chạy nhiều lần liền trên cùng một server. Tài liệu vLLM cảnh báo rằng khi bạn chạy lặp lại, server có thể lấy lại prompt cũ từ prefix cache và đẩy throughput lên cao hơn thực tế.
Cách xử lý là đổi seed giữa các lần chạy hoặc restart server. Lỗi thứ hai là để concurrency không giới hạn khi đo trên endpoint của khách, khiến kết quả phản ánh tình trạng quá tải thay vì tải thật.
Lỗi thứ ba khó phát hiện hơn: so số của bạn với số đội hạ tầng đo bằng một công cụ khác. NVIDIA lưu ý rằng mỗi công cụ cài đặt chỉ số theo cách riêng, chẳng hạn có tính TTFT vào ITL hay không, và chỉ nên so kết quả khi định nghĩa khớp nhau.
Báo cáo cho đội hạ tầng nên trông thế nào?
Đặt một bảng định nghĩa ngay trên phần kết quả, để không ai phải đoán:
| Chỉ số | Định nghĩa trong báo cáo |
|---|---|
| TTFT | Từ lúc gửi request tới output stream đầu tiên, đo tại client |
| ITL | Khoảng cách giữa hai output stream liên tiếp, gộp mọi request thành công |
| TPOT | Tính theo từng request từ độ trễ end-to-end trừ TTFT |
| Throughput hệ thống | Tổng token output của mọi request chạy song song mỗi giây |
| Goodput | Số request đạt SLO đã khai báo trong –goodput |
Dưới bảng là nguyên văn lệnh đã chạy, giá trị --max-concurrency và --request-rate kèm lý do chọn, p50/p95/p99, goodput và file JSON. Kỹ sư hạ tầng có đủ những thứ đó để tự chạy lại phép đo, và khi họ chạy lại ra cùng kết quả thì họ sẽ tin con số của bạn.
Với hồ sơ xin việc, một dòng như “benchmark endpoint vLLM theo SLO của khách, báo p50/p95/p99 và goodput” có sức nặng hơn nhiều so với “có kinh nghiệm tối ưu LLM inference”.
Nếu mô tả công việc bạn nhắm tới có nhắc đến latency hay model tự host, nên chuẩn bị sẵn một báo cáo mẫu như trên và sẵn sàng giải thích vì sao bạn chọn từng mức concurrency.
Con số throughput tối đa chỉ cho biết server mạnh đến đâu. Đội hạ tầng cần biết bao nhiêu người dùng của họ được phục vụ đúng SLO, và câu trả lời đó nằm ở --max-concurrency cùng --goodput.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!