Rubric riêng cho từng khách: dạy trợ lý AI biết lúc nào nên nói "không đủ thông tin"
Rubric chung chung chỉ đo được mức "nghe hay". Muốn đo đúng thứ khách cần, bạn phải ngồi đọc dữ liệu thật cùng chuyên gia của khách, rồi kiểm tra xem judge có chấm giống người hay không.

Tóm tắt nhanh
- Phải cho mô hình được phép nói không biết, kèm phạm vi rõ và một câu dự phòng cố định. Đó là nền của tiêu chí từ chối.
- Rubric nên chấm pass/fail, rút ra từ nhận xét viết tay của một chuyên gia phía khách. Nó phải phạt cả trả lời bịa lẫn từ chối thừa.
- Đừng tin judge khi chưa đối chiếu với nhãn người chấm. Tính TPR và TNR riêng thì mới thấy judge đang chấm lỏng ở đâu.
Tài liệu chính thức của Anthropic có một khuyến nghị đơn giản đến bất ngờ: hãy nói rõ với mô hình rằng nó được phép thừa nhận mình không chắc. Theo Anthropic, chỉ riêng việc đó có thể giảm mạnh thông tin sai.
Nhưng đến văn phòng khách hàng thì bạn gặp câu hỏi khó hơn: không biết về chuyện gì thì được phép nói không biết, và ai quyết định một câu trả lời là đạt?
Rubric chung chung kiểu “chính xác, hữu ích, lịch sự” không trả lời được câu đó. Mỗi khách có bộ tài liệu riêng, mức rủi ro riêng và một người hiểu nghiệp vụ hơn hẳn đội kỹ thuật. Một FDE giỏi biến hiểu biết của người đó thành tiêu chí máy chấm được.
Các bước dưới đây lấy một công ty bảo hiểm giả định và làm từ đầu đến cuối: viết điều khoản từ chối, lấy nhãn từ chuyên gia, viết rubric, rồi kiểm tra xem judge có chấm giống người hay không.
Bạn sẽ xây gì, và cần chuẩn bị gì?
Thử hình dung công ty bảo hiểm đó muốn có trợ lý giúp nhân viên chăm sóc khách hàng tra cứu điều khoản hợp đồng. Khi xong, bạn có bốn thứ: một system prompt có điều khoản từ chối, một rubric ba dòng, một bộ test case có nhãn của chuyên gia, và hai con số cho biết judge đáng tin đến đâu.
Quan trọng nhất là câu hỏi thật lấy từ ticket hoặc log, không phải câu bạn tự nghĩ ra. Bạn cũng cần vài giờ làm việc với một chuyên gia nghiệp vụ, ở ví dụ này là trưởng nhóm bồi thường.
Cuối cùng là một công cụ eval có LLM-as-judge, chẳng hạn llm-rubric của Promptfoo, cùng hai model khác nhau: một model sinh câu trả lời, một model chấm.
Bước 1: viết điều khoản từ chối trước khi viết rubric
Rubric chỉ chấm được thứ đã được yêu cầu rõ ràng. Ví dụ của Anthropic làm đúng hai việc: nêu phạm vi của nhiệm vụ, rồi cho mô hình một câu dự phòng cố định khi nguồn thiếu thông tin. Áp vào hợp đồng bảo hiểm, phần đó có thể trông như sau (bản rút gọn):
Chỉ trả lời dựa trên các điều khoản hợp đồng được cung cấp,
không dùng kiến thức chung.
Mỗi khẳng định phải kèm trích dẫn nguyên văn từ điều khoản.
Nếu điều khoản không đủ thông tin, trả lời đúng một câu:
"Tôi không có đủ thông tin để đánh giá chắc chắn việc này."
Dòng đầu là kỹ thuật giới hạn mô hình trong tài liệu được cung cấp. Anthropic cũng cảnh báo rằng kỹ thuật này không loại bỏ hoàn toàn ảo giác, nên những đầu ra quan trọng vẫn phải được kiểm tra. Đó là lý do bạn cần rubric.
Cách kiểm tra: hỏi ba câu mà bạn chắc chắn hợp đồng không nhắc tới. Nếu câu trả lời không khớp từng chữ với câu dự phòng, hãy sửa prompt trước khi làm tiếp.
Bước 2: đọc dữ liệu thật cùng chuyên gia, đừng đoán tiêu chí
Hamel Husain khuyên chỉ viết prompt cho judge sau khi đã xem dữ liệu thật. Ông cũng khuyên giao việc chấm cho một chuyên gia chính, và chỉ chấm đạt hoặc không đạt, không dùng thang điểm phức tạp hay nhiều metric. Trong một dự án FDE, người đó là chuyên gia nghiệp vụ phía khách.
Theo Husain, mỗi lần chấm phải đi kèm một đoạn nhận xét viết tay. Đoạn nhận xét đó phải đủ chi tiết để dùng làm ví dụ few-shot cho LLM judge. Một bảng nhãn đơn giản trông như sau:
id | câu hỏi                          | nhãn | nhận xét của chuyên gia
07 | Ngập do bão có được bồi thường?  | fail | Trả lời "có" nhưng không trích điều 4.2, nơi loại trừ ngập do triều cường
12 | Phí khám ngoài giờ tính sao?     | fail | Hợp đồng có nêu ở phụ lục B mà trợ lý lại từ chối trả lời
19 | Bồi thường thú cưng?             | pass | Hợp đồng không đề cập, trợ lý dùng đúng câu dự phòng
Để ý ca 12. Chuyên gia phạt một lần từ chối thừa không kém gì một câu trả lời bịa. Phần lớn rubric viết vội bỏ sót chiều này.
Bước 3: biến các nhận xét thành rubric ba dòng
Đọc lại vài chục nhận xét, bạn sẽ thấy chúng xoay quanh vài lỗi lặp lại. Dòng đầu tiên lấy từ một kỹ thuật khác của Anthropic: mọi khẳng định phải có trích dẫn đi kèm, không tìm được trích dẫn thì phải rút lại. Dòng thứ ba lấy cảm hứng từ Model Spec của OpenAI, vốn coi từ chối là phương án cuối cùng.
Câu trả lời ĐẠT khi và chỉ khi thỏa cả ba điều:
1. Mọi khẳng định về quyền lợi đều kèm trích dẫn nguyên văn
   từ điều khoản. Chỉ một khẳng định thiếu nguồn là KHÔNG ĐẠT.
2. Nếu điều khoản không chứa câu trả lời, đầu ra đúng là câu
   dự phòng, không thêm suy đoán.
3. Nếu điều khoản CÓ chứa câu trả lời, việc từ chối là KHÔNG ĐẠT.Bước 4: đưa rubric vào Promptfoo
Promptfoo mô tả llm-rubric là một assertion dùng model để chấm đầu ra theo tiêu chí bạn viết. Cấu hình rút gọn dưới đây có hai test: test đầu dùng rubric pass/fail ở Bước 3, test sau dùng một rubric cho điểm từng phần.
# Rút gọn để minh họa
tests:
  - vars:
      question: "Phí khám ngoài giờ tính sao?"
    assert:
      - type: llm-rubric
        value: "<dán rubric ba dòng ở Bước 3>"
  - vars:
      question: "Ngập do bão có được bồi thường?"
    assert:
      - type: llm-rubric
        value: "<rubric cho điểm từng phần>"
        threshold: 0.8
Test đầu không có threshold, nên Promptfoo quyết định pass theo trường boolean pass mà judge trả về. Đó đúng là thứ một rubric pass/fail cần.
Test sau áp threshold lên điểm số từ 0.0 đến 1.0 của judge. Thiếu dòng này, rubric có điểm từng phần vẫn bị chấm theo trường pass.
Con số 0.8 chỉ là ví dụ, nên chọn theo mức rủi ro khách chấp nhận được. Thêm một chi tiết từ ví dụ của Anthropic: nên dùng một model khác để chấm, không dùng chính model đã sinh ra câu trả lời.
Bước 5: judge có chấm giống chuyên gia không?
Husain khuyên coi nhãn của người là ground truth, rồi báo cáo True Positive Rate và True Negative Rate riêng rẽ. Hãy tính thử trên một bộ giả định gồm 40 case. Chuyên gia chấm 25 case đạt và 15 case không đạt.
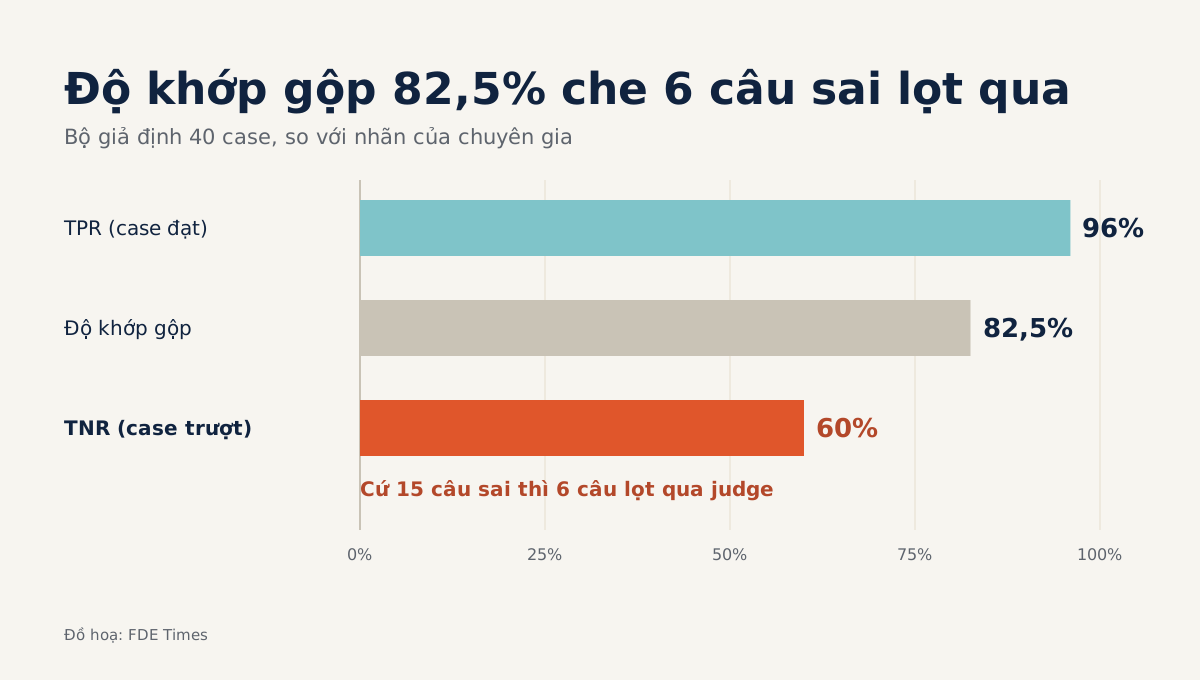
Giả sử judge cho đạt 24 trên 25 case mà chuyên gia cho đạt, tức TPR là 96%. Nhưng judge chỉ đánh trượt 9 trên 15 case mà chuyên gia đánh trượt, tức TNR là 60%. Nếu gộp lại, độ khớp là 33 trên 40, tức 82,5%, nghe khá ổn.
Con số gộp đó giấu đi điều quan trọng nhất: cứ 15 câu trả lời sai thì có 6 câu lọt qua judge. Việc tiếp theo là mở đúng 6 case đó và thêm nhận xét tương ứng của chuyên gia vào prompt của judge làm ví dụ few-shot.
Rồi khép vòng lặp: chạy lại judge trên toàn bộ bộ case và tính lại cả TPR lẫn TNR. Nên để riêng vài case trượt chưa từng đưa vào few-shot, vì judge chấm đúng những ví dụ nó vừa được xem chưa chứng minh được gì. Nếu TNR vẫn không nhích, nhận xét của chuyên gia có lẽ chưa đủ cụ thể, và bạn quay lại Bước 2.
Muốn tách riêng phần từ chối, bạn có thể dùng Refusal evaluator của Arize Phoenix. Công cụ này phát hiện khi LLM từ chối, khước từ hoặc né một câu hỏi. Nó cho bạn biết trợ lý có từ chối hay không. Còn từ chối như vậy có đúng hay không thì dòng 2 và dòng 3 của rubric mới trả lời được.
Khi judge đã đáng tin, hãy mở rộng bộ test
Hướng dẫn thiết kế eval của Anthropic nói rõ: nhiều câu hỏi chấm tự động, dù tín hiệu kém hơn một chút, vẫn tốt hơn vài câu được người chấm tay kỹ lưỡng. Thời gian của chuyên gia nên dành cho việc hiệu chỉnh judge. Việc chấm hàng trăm câu hãy để máy làm.
Khi mở rộng, có bốn cái bẫy đáng canh. Bẫy đầu tiên là viết rubric trước khi đọc dữ liệu. Dấu hiệu dễ thấy là rubric toàn chữ “chính xác”, “hữu ích”, và chuyên gia đọc lên không nhận ra lỗi nào mình từng bắt. Cách sửa là quay lại bảng nhãn và rút từng dòng rubric từ một nhận xét thật.
Bẫy kế tiếp là thang điểm 1 đến 5. Dấu hiệu là cả nhóm tranh luận mãi về điểm 3 mà không chốt được. Hãy đưa về pass/fail như Husain khuyên, rồi để phần sắc thái nằm trong đoạn nhận xét.
Cái bẫy thứ ba là để model sinh tự chấm chính mình. Khi đó lỗi của model sinh và lỗi của judge có thể trùng nhau, nên bạn không tách được chúng. Cách sửa chỉ là đổi sang một model khác để chấm, rồi đo lại TPR và TNR.
Bẫy tốn kém nhất là chỉ báo độ khớp gộp. Dấu hiệu chính là con số 82,5% ở trên: trông ổn, trong khi 6 câu trả lời sai lọt qua. Mỗi lần sửa rubric hay thêm ví dụ few-shot, hãy báo cả hai con số riêng rẽ.
Kỹ năng này hiện ra thế nào ở site khách và trong CV?
Ở site khách, thứ giúp khách tin vào trợ lý không phải một bản demo trơn tru, mà là bộ 40 case do chính chuyên gia của họ gắn nhãn, kèm TPR và TNR. Khi khách thêm tài liệu mới, bạn chỉ cần thêm case và hiệu chỉnh lại judge.
Khi đọc mô tả công việc FDE, hãy tìm các cụm như “evals”, “LLM-as-judge” hay “làm việc với subject-matter expert”. Trong CV, một dòng cụ thể có sức nặng hơn nhiều so với “có kinh nghiệm LLM”. Ví dụ: “xây rubric pass/fail cùng chuyên gia nghiệp vụ, nâng TNR của judge từ X lên Y”.
Cách học rẻ nhất là làm ngay trên một dự án cá nhân. Hãy tìm một người hiểu nghiệp vụ hơn bạn và nhờ họ chấm 20 câu trả lời. Rubric đầu tiên bạn viết ra sẽ không hoàn hảo, nhưng ít nhất nó đo theo đúng tiêu chuẩn của khách.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!