Khách cấm cài broker? Dựng hàng đợi việc ngay trong Postgres
Một câu SKIP LOCKED đủ để chia việc cho nhiều worker; phần khó hơn là xử lý job kẹt và bảng phình.
Tóm tắt nhanh
- FOR UPDATE SKIP LOCKED đi cùng ORDER BY và LIMIT 1 giúp nhiều worker nhận việc song song mà không lấy trùng nhau.
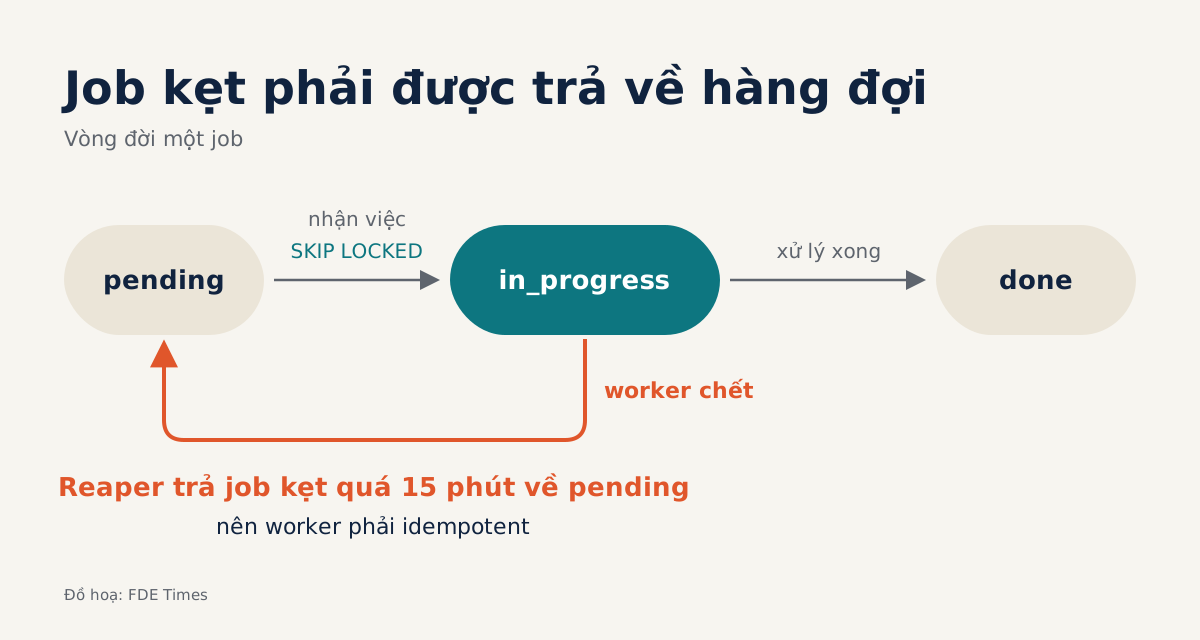
- Worker chết giữa chừng sẽ để job kẹt ở in_progress. Muốn tránh, bạn phải giữ cả việc trong một transaction hoặc có reaper trả job về hàng.
- Bảng hàng đợi sinh dead tuple nhanh hơn tốc độ autovacuum dọn kịp, nên cần đo bloat ngay từ ngày đầu.
Một bảng hàng đợi trong Postgres có thể phình tới hàng chục gigabyte trong khi dữ liệu còn sống chỉ vài megabyte. Blog Postgres của Microsoft đã ghi nhận đúng hiện tượng này. Nó thường xảy ra ở những hệ thống mà lúc mới dựng, ai cũng nghĩ chỉ là “một bảng nhỏ với một câu SELECT”.
Làm FDE, bạn sẽ gặp tình huống này. Thử hình dung khách là một ngân hàng hoặc một bệnh viện. Đội vận hành không cho cài thêm RabbitMQ hay Kafka vào hạ tầng đã được phê duyệt, trong khi bạn cần đẩy hàng nghìn tài liệu qua pipeline trích xuất. Thứ duy nhất họ cho dùng là con Postgres đang chạy sẵn.
Hướng dẫn dưới đây dựng một hàng đợi đủ dùng ngay trên con Postgres đó. Bạn chỉ cần một Postgres để thử (local hay trên cloud đều được) và hai cửa sổ psql. Các đoạn mã đã được rút gọn để dễ học, chưa phải bản dùng được cho production.
Bước 1: một bảng, một index, thế là đủ
Bắt đầu bằng một bảng jobs có cột trạng thái. Partial index chỉ phủ những dòng đang chờ, vì worker chỉ cần tìm những dòng đó.
CREATE TABLE jobs (
  id          bigserial PRIMARY KEY,
  status      text NOT NULL DEFAULT 'pending',
  payload     jsonb NOT NULL,
  created_at  timestamptz NOT NULL DEFAULT now(),
  started_at  timestamptz
);

CREATE INDEX jobs_pending_idx ON jobs (created_at)
  WHERE status = 'pending';
Xong bước này, chạy \d jobs để kiểm tra index đã có điều kiện WHERE status = 'pending' chưa. Hãy nhớ tên index này, vì đến Bước 6 nó sẽ là chỗ gây đau đầu nhất.
Bước 2: nhận việc mà không giẫm chân nhau
Theo tài liệu chính thức của Postgres, SKIP LOCKED bỏ qua những dòng không khóa được ngay. Tùy chọn này dành cho các bảng kiểu hàng đợi có nhiều consumer.
Hướng dẫn của Neon đưa ra mẫu cơ bản: lấy task pending cũ nhất, sắp xếp theo thời gian, LIMIT 1, rồi FOR UPDATE SKIP LOCKED. Process nào chạm tới một dòng trước thì khóa dòng đó, các process khác bỏ qua và lấy dòng kế tiếp.
Từ đây có hai cách nhận việc. Cách A giữ transaction mở suốt thời gian xử lý:
BEGIN;
SELECT id, payload FROM jobs
WHERE status = 'pending'
ORDER BY created_at
LIMIT 1
FOR UPDATE SKIP LOCKED;
-- ứng dụng xử lý việc ở đây
UPDATE jobs SET status = 'done' WHERE id = 1;  -- thay 1 bằng id câu SELECT vừa trả về
COMMIT;
Trong psql, bạn chép id mà câu SELECT vừa trả về rồi dán vào câu UPDATE. Trong code thật, ứng dụng sẽ truyền id đó vào như một tham số.
Cách A rất gọn. Theo blog dbpro, nếu worker crash giữa chừng thì transaction bị rollback và job tự quay lại hàng đợi. Cái giá là mỗi job đang chạy chiếm một transaction mở, mà gọi model hay chạy OCR thì có thể mất vài phút.
Cách B nhận việc rồi commit ngay:
UPDATE jobs
SET status = 'in_progress', started_at = now()
WHERE id = (
  SELECT id FROM jobs
  WHERE status = 'pending'
  ORDER BY created_at
  LIMIT 1
  FOR UPDATE SKIP LOCKED
)
RETURNING id, payload;
Transaction lúc này rất ngắn, nhưng bạn phải tự lo trường hợp worker chết. Bước 4 sẽ xử lý chuyện đó.
Bước 3: chứng minh hai worker không lấy trùng việc
Thêm vài job để thử:
INSERT INTO jobs (payload) VALUES
  ('{"doc": 1}'), ('{"doc": 2}'), ('{"doc": 3}');
Mở hai cửa sổ psql. Ở cửa sổ thứ nhất, gõ BEGIN; rồi chạy câu SELECT của cách A, nhưng khoan commit. Ở cửa sổ thứ hai, làm y hệt như vậy.
Nếu mọi thứ đúng, cửa sổ thứ hai sẽ trả về ngay một id khác chứ không bị treo. Nếu nó đứng chờ, nhiều khả năng bạn quên SKIP LOCKED. Thử xong thì chạy ROLLBACK; ở cả hai cửa sổ.
Mang bài test này lên máy của khách là bạn có ngay bằng chứng để trình đội vận hành. Họ thường khó tin lý lẽ trên giấy, nhưng hai cửa sổ terminal chạy song song thì dễ thuyết phục hơn nhiều.
Bước 4: ai dọn những job bị kẹt?
Với cách B, hướng dẫn của Neon cảnh báo rằng task có thể kẹt mãi ở in_progress khi worker gặp lỗi. Họ gợi ý một truy vấn để tìm những task chạy quá lâu. Nói cách khác, bạn cần một reaper.
UPDATE jobs
SET status = 'pending', started_at = NULL
WHERE status = 'in_progress'
  AND started_at < now() - interval '15 minutes';
Con số 15 phút chỉ là ví dụ. Hãy chọn ngưỡng dài hơn thời gian xử lý chậm nhất bạn đo được trên dữ liệu thật của khách. Nếu ngưỡng quá ngắn, reaper sẽ trả về hàng một job vẫn đang chạy, và job đó bị làm hai lần.
Vì vậy worker của bạn nên idempotent: xử lý lại cùng một tài liệu cũng không được tạo ra hai bản ghi kết quả.
Để kiểm tra, cho một worker nhận việc theo cách B, kill process đó, chờ quá ngưỡng rồi chạy reaper. Job phải quay về pending.
Bước 5: đánh thức worker, nhưng đừng chỉ trông vào thông báo
Nếu worker cứ vài giây lại hỏi bảng một lần, phần lớn những lần hỏi sẽ không có việc gì mới. Vì thế bạn sẽ muốn dùng LISTEN/NOTIFY. Theo tài liệu Postgres, NOTIFY chạy theo transaction: sự kiện chỉ được gửi đi khi transaction commit. Ghi job và gửi thông báo trong cùng một transaction vì thế là an toàn.
-- phía đẩy việc
BEGIN;
INSERT INTO jobs (payload) VALUES ('{"doc": 4}');
NOTIFY jobs_channel;
COMMIT;

-- phía worker
LISTEN jobs_channel;
Có một điểm hay bị bỏ sót: thông báo chỉ đến được những session đã chạy LISTEN từ trước. Worker đang khởi động lại sẽ không nhận được gì. Trạng thái thật của hàng đợi luôn nằm trong bảng jobs, nên worker vẫn phải poll định kỳ để không bỏ sót việc.
Tài liệu còn cảnh báo hàng đợi NOTIFY có thể bị đầy, và khi đó các transaction gọi NOTIFY sẽ lỗi lúc commit. Nguyên nhân là có một listener ngồi trong một transaction dài. Đây là cái giá ẩn của cách A nếu worker vừa LISTEN vừa giữ transaction trong lúc xử lý. Hãy tách kết nối dùng để LISTEN khỏi kết nối dùng để làm việc.
Bước 6: đo bloat trước khi DBA của khách hỏi
Blog Postgres của Microsoft giải thích cơ chế khá rõ: dead tuple tích lũy nhanh hơn tốc độ autovacuum dọn kịp. Partial index trên trạng thái pending là phần chịu thiệt nặng nhất. Trên một bảng bị ghi liên tục, vacuum và worker còn có thể cản trở nhau.
Bạn có thể tự tạo áp lực đó trên máy mình. Đoạn dưới đây là bài tập rút gọn: đẩy 10.000 job giả vào bảng rồi đánh dấu tất cả là xong, giống một đợt xử lý dồn dập.
INSERT INTO jobs (payload)
SELECT jsonb_build_object('doc', g)
FROM generate_series(1, 10000) AS g;

UPDATE jobs SET status = 'done' WHERE status = 'pending';
Sau đó đo số dead tuple và kích thước của bảng và index:
SELECT n_live_tup, n_dead_tup, last_autovacuum
FROM pg_stat_user_tables
WHERE relname = 'jobs';

SELECT pg_size_pretty(pg_relation_size('jobs'))             AS bang,
       pg_size_pretty(pg_relation_size('jobs_pending_idx')) AS index_pending;
Bạn sẽ thấy n_dead_tup tăng theo số lần UPDATE, còn index pending không co lại dù lúc này không còn job nào đang chờ. Chạy lại đoạn trên vài lần và ghi kết quả từng lượt. Bạn sẽ tận mắt thấy vì sao bảng hàng đợi phình nhanh hơn nhiều so với lượng dữ liệu thật trong nó.
Ở chỗ khách, hãy cho hai câu đo này chạy hằng ngày ngay từ tuần đầu, lưu kết quả theo ngày và đặt ngưỡng cảnh báo. Đừng đợi đến khi truy vấn nhận việc chậm hẳn mới đi tìm nguyên nhân. Đội DBA của khách sẽ tin bạn hơn nhiều nếu bạn là người nhắc đến bloat trước khi họ tự phát hiện.
Ba cái bẫy khiến hàng đợi chạy sai
Bẫy hay gặp nhất là thấy SKIP LOCKED tiện rồi dùng luôn cho truy vấn nghiệp vụ. Tài liệu Postgres nói rõ: bỏ qua dòng bị khóa nghĩa là bạn nhìn thấy dữ liệu không nhất quán. Vì thế tùy chọn này không hợp với việc thông thường, chỉ hợp với bảng kiểu hàng đợi.
Bẫy thứ hai là tưởng SKIP LOCKED bỏ qua mọi loại khóa. Thực ra nó chỉ tác động lên khóa cấp dòng, còn khóa ROW SHARE ở cấp bảng vẫn được lấy như bình thường. Bẫy cuối là viết FETCH ... WITH TIES để lấy cả nhóm job có cùng thời điểm: Postgres không cho dùng SKIP LOCKED với cú pháp này.
Khi nào nên chuyển sang thứ khác?
Nếu khách cho cài extension nhưng không cho dựng broker riêng, pgmq là lựa chọn đáng cân nhắc. Đây là hàng đợi kiểu SQS chạy hoàn toàn trong Postgres. Theo repo của dự án, pgmq bảo đảm mỗi message chỉ được giao đúng một lần trong khoảng visibility timeout.
Visibility timeout làm phần việc gần giống reaper bạn vừa viết, nhưng không xóa bỏ hai bài học ở Bước 4. Bạn vẫn phải chọn timeout dài hơn thời gian xử lý thật, và worker vẫn phải idempotent.
Khi ghi kinh nghiệm này vào CV, hãy kể ràng buộc và cách bạn xử lý thay vì chỉ ghi “biết Postgres”. Ví dụ: “Khách không cho cài broker; dựng hàng đợi trên Postgres có sẵn, kèm reaper cho job kẹt và theo dõi bloat hằng ngày.” Gặp tin tuyển FDE có nhắc “on-prem” hay “customer infrastructure”, đó là câu chuyện nên mang vào buổi phỏng vấn.
Một hàng đợi trong Postgres không phải giải pháp chắp vá. Nó giúp bạn giao được việc trên hạ tầng khách đã tin dùng, miễn là bạn biết rõ nó có thể hỏng ở đâu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- SELECT (PostgreSQL Documentation)
- Queue system using SKIP LOCKED in Lakebase Postgres · 2026-09-24
- PostgreSQL FOR UPDATE SKIP LOCKED: The One-Liner Job Queue · 2026-01-25
- Potential Consequences of Using Postgres as a Job Queue · 2026-04-30
- NOTIFY (PostgreSQL 18.7 Documentation)
- pgmq/pgmq: A lightweight message queue. Like AWS SQS and RSMQ but on Postgres