Vì sao chỉ ETag là chưa đủ để đồng bộ dữ liệu từ API của khách
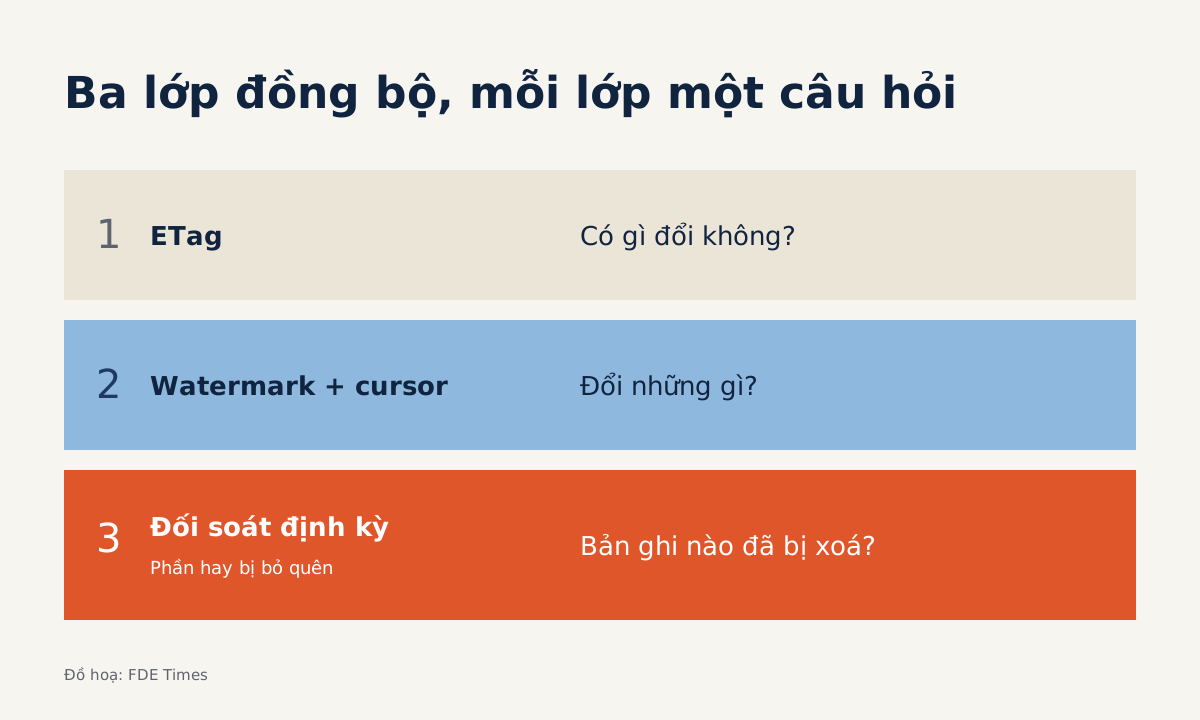
Phải ghép ETag với watermark, cursor và đối soát định kỳ thì mới xử lý được bản ghi trùng và không sót bản ghi bị xoá.
Tóm tắt nhanh
- Phản hồi 304 chỉ giúp bạn tiết kiệm khi endpoint thực sự hỗ trợ nó, nên hãy thử bằng curl trước khi viết code.
- Mốc thời gian kiểu 'từ thời điểm này trở đi' sẽ trả trùng bản ghi nằm đúng ở mốc, vì vậy bạn cần ghi đè theo id.
- Watermark không bắt được bản ghi bị xoá, nên bạn cần thêm một lần đối soát toàn bộ theo lịch.
Trên GitHub, một request có điều kiện mà nhận về 304 Not Modified thì không bị tính vào primary rate limit. Nhưng chính tài liệu của GitHub cũng ghi rõ: bạn chỉ tiết kiệm được thời gian và hạn mức khi endpoint thực sự trả 304.
Ở chỗ khách hàng, đó là điều cần kiểm tra đầu tiên. API bạn phải làm việc cùng có thể là hệ thống ticket, CRM, hay một dịch vụ nội bộ ai đó viết từ năm năm trước, và chưa chắc nó từng trả 304 lần nào.
Rất nhiều deployment bắt đầu bằng cùng một việc: kéo dữ liệu của khách về đều đặn, không làm cạn hạn mức của họ và không để sót bản ghi nào.
Bài này dựng một bộ đồng bộ hai lớp. Lớp đầu dùng ETag để hỏi “có gì đổi không?” mà gần như không tốn gì. Lớp sau dùng watermark thời gian kiểu updated_since cùng với cursor phân trang để lấy đúng phần đã đổi. Cuối cùng là một lần đối soát định kỳ, phần mà nhiều người bỏ quên.
Chuẩn bị gì trước khi bắt đầu?
Bạn cần curl, Python 3 có thư viện requests, và một repo công khai bất kỳ trên GitHub để thử. Các đoạn Python trong bài đã được rút gọn để dễ đọc. Chúng chưa có retry, backoff hay xử lý lỗi mạng, nên đừng chép thẳng vào production.
Trước hết bạn cần nắm khái niệm ETag. Tài liệu MDN mô tả nó là một chuỗi định danh duy nhất cho từng phiên bản của một tài nguyên, và là chuỗi opaque: client không cần biết bên trong nó chứa gì.
Client lưu chuỗi này lại, lần sau gửi kèm để hỏi server xem tài nguyên đã đổi chưa. Nếu chưa đổi, server trả 304 Not Modified thay vì gửi lại toàn bộ body, và client tiếp tục dùng bản đã lưu.
Bước 1: Xem server có cấp ETag không
curl -i https://api.github.com/repos/OWNER/REPOKiểm tra: trong phần header trả về có dòng etag. Hãy sao chép nguyên giá trị đó, kể cả dấu ngoặc kép và tiền tố nếu có. Vì chuỗi này là opaque, bạn không cần hiểu nó và cũng không nên tự dựng lại nó.
Bước 2: Gửi lại ETag và chờ một phản hồi 304
curl -i https://api.github.com/repos/OWNER/REPO \
  -H 'If-None-Match: <dán nguyên giá trị etag ở bước 1>'
Kiểm tra: dòng trạng thái là 304, body rỗng. Theo MDN, khi điều kiện thất bại với GET hoặc HEAD, server phải trả 304 cùng một số header mà nó vẫn gửi trong phản hồi 200, trong đó có ETag. Vì vậy client của bạn vẫn đọc được ETag ngay cả khi không có dữ liệu mới.
Bạn cũng nên hiểu đúng cách so sánh. If-None-Match chỉ thành công, tức là trả nội dung mới, khi ETag trên server khác với mọi ETag client liệt kê. Phép so sánh này là so sánh yếu: hai phiên bản có nội dung tương đương được coi là giống nhau. Hệ quả là một phản hồi 304 không đảm bảo hai bên giống nhau đến từng byte.
Bước 3: Lưu ETag theo từng URL
Theo quy trình GitHub mô tả, bạn lưu etag từ một phản hồi rồi gửi nó trong header if-none-match ở request kế tiếp tới cùng URL đó. Mỗi ETag gắn với đúng một URL, nên khoá lưu trữ cũng phải là URL, tính cả query string.
# Rút gọn để minh hoạ: chưa có retry, backoff, xử lý lỗi
import requests

def fetch(url, etags):
    headers = {}
    if url in etags:
        headers["If-None-Match"] = etags[url]
    r = requests.get(url, headers=headers, timeout=30)
    if r.status_code == 304:
        return None              # không đổi, dùng bản đã lưu
    r.raise_for_status()
    if "ETag" in r.headers:
        etags[url] = r.headers["ETag"]
    return r.json()
Kiểm tra: gọi fetch hai lần liền nhau với cùng một URL, lần thứ hai phải trả None. Thử hình dung bạn poll một endpoint 5 phút một lần, tức 288 request mỗi ngày. Nếu dữ liệu chỉ đổi 20 lần trong ngày thì 268 request còn lại có thể kết thúc bằng 304, và trên GitHub chúng không ăn vào primary rate limit.
Vì sao chỉ có ETag thôi thì chưa đủ?
ETag chỉ trả lời được câu “tài nguyên này có đổi không”. Với một danh sách 100.000 đơn hàng, câu trả lời “có” chẳng giúp được bao nhiêu nếu sau đó bạn vẫn phải tải lại cả 100.000. Bạn cần thêm câu hỏi “đổi những gì”, và watermark thời gian sinh ra để trả lời câu đó.
Zendesk có một ví dụ thật. Với incremental export API của họ, bạn đưa vào một thời điểm bắt đầu và API trả về mọi mục được tạo hoặc thay đổi từ thời điểm đó trở đi.
Cụm “từ thời điểm đó trở đi” có nghĩa là bản ghi cập nhật đúng vào mốc sẽ xuất hiện ở cả hai lượt chạy. Ví dụ watermark là 10:00:00 và một ticket sửa đúng lúc 10:00:00 thì ticket đó sẽ quay lại ở lượt sau.
Bước 4: Tách watermark khỏi cursor phân trang
Hai khái niệm này rất hay bị trộn lẫn. Stripe phân trang bằng ID đối tượng (starting_after) kèm cờ has_more; khi cờ là false nghĩa là bạn đã tới cuối danh sách. Zendesk ở chế độ cursor thì trả kèm mỗi trang một cursor cho request tiếp theo, còn thuộc tính end_of_stream cho bạn biết lúc nào dừng phân trang.
Cursor giúp bạn đi hết các trang trong một lượt chạy. Watermark giúp bạn biết lượt sau bắt đầu từ đâu. Đoạn code dưới đây chạy với một API giả định của khách, tên tham số và tên trường đều là ví dụ:
# API giả định: GET /v1/orders?updated_since=...&cursor=...
# trả về {"items": [...], "next_cursor": "...", "has_more": true}
def sync_orders(base, watermark, db):
    newest = watermark
    cursor = None
    while True:
        params = {"updated_since": watermark}
        if cursor:
            params["cursor"] = cursor
        page = requests.get(f"{base}/v1/orders", params=params,
                            timeout=30).json()
        for item in page["items"]:
            db.upsert(item["id"], item)      # ghi đè theo id
            newest = max(newest, item["updated_at"])
        if not page["has_more"]:
            break
        cursor = page["next_cursor"]
    return newest    # chỉ lưu watermark mới khi vòng lặp đã xong
Đoạn code này có hai lựa chọn bạn nên giữ nguyên khi viết bản thật. Lệnh upsert theo id làm cho bản ghi trùng ở mốc thời gian trở nên vô hại.
Watermark mới lấy từ dữ liệu của server chứ không lấy từ đồng hồ máy bạn, và chỉ được ghi xuống khi cả lượt chạy thành công. Nếu job chết ở trang 7, lượt sau sẽ chạy lại từ mốc cũ chứ không nhảy qua mất sáu trang.
Kiểm tra: chạy sync_orders hai lần với cùng một watermark, số bản ghi trong kho phải giữ nguyên.
Bước 5: Lên lịch đối soát cho các bản ghi bị xoá
Một bản ghi đã bị xoá thì không còn updated_at để watermark nhìn thấy. Zendesk cho biết incremental export vẫn có thể chứa bản ghi đã xoá, nhưng sau khi một ticket bị xoá vĩnh viễn, họ chỉ giữ một bản ghi tối thiểu trong 90 ngày. Nếu job của bạn ngừng chạy lâu hơn thế, dấu vết của lần xoá cũng mất theo.
Cách an toàn là định kỳ lấy toàn bộ danh sách ID từ API của khách, so với kho của bạn, rồi đánh dấu những ID không còn tồn tại. Lượt này tốn kém nên chạy thưa, ví dụ mỗi đêm hoặc mỗi tuần, tuỳ việc khách chấp nhận dữ liệu lệch bao lâu.
Những lỗi hay gặp nhất
Lỗi phổ biến nhất là mặc định rằng endpoint nào cũng hỗ trợ 304. Hãy làm lại bước 2 với chính API của khách trước khi đưa ETag vào thiết kế. Lỗi thứ hai là coi 304 như bằng chứng dữ liệu giống nhau từng byte, trong khi đó là so sánh yếu. Lỗi thứ ba là dời watermark sau mỗi trang thay vì sau cả lượt chạy.
Còn một lỗi nữa: poll trong khi đáng ra không cần. GitHub khuyên bạn đăng ký webhook thay vì poll API nếu có thể, và nếu buộc phải poll thì chạy theo lịch cố định. Khi hệ thống của khách có webhook, hãy dùng nó để biết khi nào có thay đổi và giữ bộ đồng bộ tăng dần làm lưới an toàn.
Kỹ năng này xuất hiện ở đâu tại chỗ khách?
Trong tuần đầu ở một khách hàng, nên hỏi ngay ba câu: “API của các anh có trả ETag không, có lọc được theo thời gian cập nhật không, xoá thì báo bằng cách nào”. Hỏi sớm thì bạn tránh được một pipeline sập hạn mức ngay vào ngày demo.
Khi đọc tin tuyển dụng FDE, nếu thấy những cụm như tích hợp với hệ thống của khách hoặc xây data pipeline, hãy chuẩn bị sẵn một ví dụ đồng bộ tăng dần để kể. Trong CV, đừng chỉ ghi “tích hợp API”.
Hãy mô tả cách bạn xử lý bản ghi trùng, phân trang và bản ghi bị xoá, kèm số liệu thật nếu bạn có, như tỉ lệ request kết thúc bằng 304.
Trong vòng thiết kế hệ thống, đừng dừng ở “dùng updated_since”. Hãy tự hỏi luôn “thế bản ghi bị xoá thì sao?” rồi trình bày lịch đối soát của bạn.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!