近300幅插图的LLM书,为何适合FDE
每章配有在免费GPU上运行的Colab笔记本;先读RAG一章,再借书中插图向客户解释系统为何答错。
要点速览
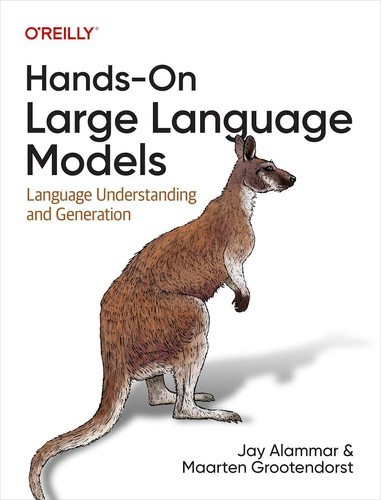
- Jay Alammar 和 Maarten Grootendorst 的这本书共 12 章、分 3 部分。它不依赖公式,而是从直觉出发、用图来讲故事,书中近 300 幅插图都是专门绘制的。
- 全部代码在 GitHub 上免费开放。每章都有一个 Colab 笔记本,可在显存 16GB 的免费 T4 GPU 上运行。
- 对 FDE 来说,第 8 章语义搜索与 RAG 最值得投入精力。第 11–12 章的微调内容可以往后放。
近 300 幅插图,每一幅都是为这本书专门绘制的。这个数字来自 Maarten Grootendorst,他在宣布《Hands-On Large Language Models》定稿时给出。这本书由他与 Jay Alammar 合著,官网标注的版权年份是 2024 年。
对一本讲大语言模型的技术书来说,这个选择很能说明作者的用意:他们押注读者看图比看公式更快理解 LLM。
对想做前线部署工程师(FDE)的人来说,这种讲法正好切中这份工作的难点。系统要在客户现场跑通,你还得向一位从没听说过 embedding 的运营经理解释,它为什么给出了错误答案。一本用图来教的书,恰好给了你现成的讲法。
用直觉和插图代替公式
Grootendorst 这样概括本书的思路:从直觉出发,用图来讲故事,而不是依赖公式。Andrew Ng 在官网的推荐语中说,两位作者延续了他们用精美、富有洞见的插图讲解复杂主题的传统。
Cohere 的 Nils Reimers 称它是了解语言模型及其产业应用的绝佳指南。Leland McInnes 则称赞它提供了看穿 AI 炒作所需的清晰讲解和动手示例。
不过,这并不是一本图画书。全部代码在 GitHub 上免费开放,仓库昵称为“The Illustrated LLM Book”,采用 Apache-2.0 许可证。每章都有一个 Colab 笔记本,作者建议在 Google Colab 上用免费的 T4 GPU(16GB 显存)运行,有浏览器就够了。
这本书最值得学的习惯是画图。如果你还画不出数据从提问、经过搜索步骤、再到答案的流向,你就并没有真正理解自己在部署的系统。书中近 300 幅插图就是现成的临摹范本。
十二章,但 FDE 该换个顺序读
全书 12 章分为三部分:概念、使用预训练语言模型、训练与微调。对从零学起的人,这个顺序很合理。但 FDE 应该按客户最常问的问题来排优先级。
概念部分要全部读完,后面所有的沟通都建立在它之上。然后直接跳到第 8 章“语义搜索与检索增强生成(RAG)”。这一章离 FDE 的工作最近:让模型读懂客户的内部文档,并给出正确答案。
一个错误答案,追溯到源头
设想一位客户:一家保险公司,希望呼叫中心员工能快速查询几百条保单条款。一位坐席问:“客户在下班时间骑摩托车出事故,保单赔不赔?”系统回答得很流畅:赔。
假设实际上免责条款在第 15 节,写明了不赔。排查的诀窍是别急着换模型,先把搜索步骤交给模型的 3 段文本打印出来。
如果这 3 段全部来自讲工作时间的第 12 节,没有一段来自第 15 节,那模型并没有做错。它根据拿到的材料给出了正确的回答。
所以问题出在检索。也许第 15 节在分块时被从中间切开了,也许“免责”一词与问题的语义相似度不够高。以下是实践经验,并非书中内容:运行第 8 章笔记本时,先练习单独检查搜索步骤,然后再看生成步骤。
读完第 8 章后,再回头读第二部分的其余章节,全面了解预训练模型的各种用法。第三部分可以往后放。
微调是最后一章,也该排在待办清单最后
第 11 章和第 12 章讲微调:一章讲用于分类的表示模型,另一章讲生成模型。分清这两者,能帮你在客户提出需求时选对工具。
很多客户需求,比如给投诉邮件分类、给工单打标签,本质上都是分类问题。这种情况下,微调一个表示模型可能就够了,不必动生成模型。
有个小练习可以培养这种直觉:写下五个假想需求,比如“把紧急工单标出来”或“起草投诉回复”。对每一个只问一个问题:输出是从固定列表里选一个标签,还是一段新文本?如果是标签,先考虑表示模型。
在真实的客户项目中,通常要把提示词和检索都充分尝试过之后,才值得考虑微调。读第三部分,是为了知道什么时候值得做,而不是在第一周就动手。
谁该读,简历上写什么
如果你会写 Python,但从没搭过 LLM 系统,开箱即用的 Colab 笔记本是最平缓的入门方式。如果你已经熟悉模型训练,概念部分大概很快就能读完,主要价值在笔记本。
如果你的目标是 FDE 岗位,就把第 8 章的笔记本改造成一个基于真实文档的小项目,比如越南语文档,或你工作中使用的其他语言的文档。记录每一个错误答案,以及错误出在哪一步。
简历上写一句“在越南语文档上搭建 RAG,定位并修复了检索步骤中的错误”,远比罗列一串已完成的课程有说服力。看岗位描述时,留意 semantic search、RAG 或 embedding 这类字眼,这些正是这本书帮你练的东西。
衡量《Hands-On Large Language Models》读得怎么样,合理的标准不是读了多少章,而是你能否带着一个 RAG 演示去参加 FDE 面试,并讲清楚它有一次为什么答错了。
这篇文章对你有帮助吗?
感谢你的反馈!