Chọn ngữ cảnh là một thuật toán: bài học đáng giữ từ Prompt Engineering for LLMs
Cuốn sách của John Berryman và Albert Ziegler đáng đọc không phải vì mẹo viết câu lệnh, mà vì nó dạy cách quyết định cắt gì, giữ gì và đặt nó ở đâu trước mô hình.
Tóm tắt nhanh
- Berryman và Ziegler chia nội dung prompt thành tĩnh và động; phần động được ghép lại theo từng request.
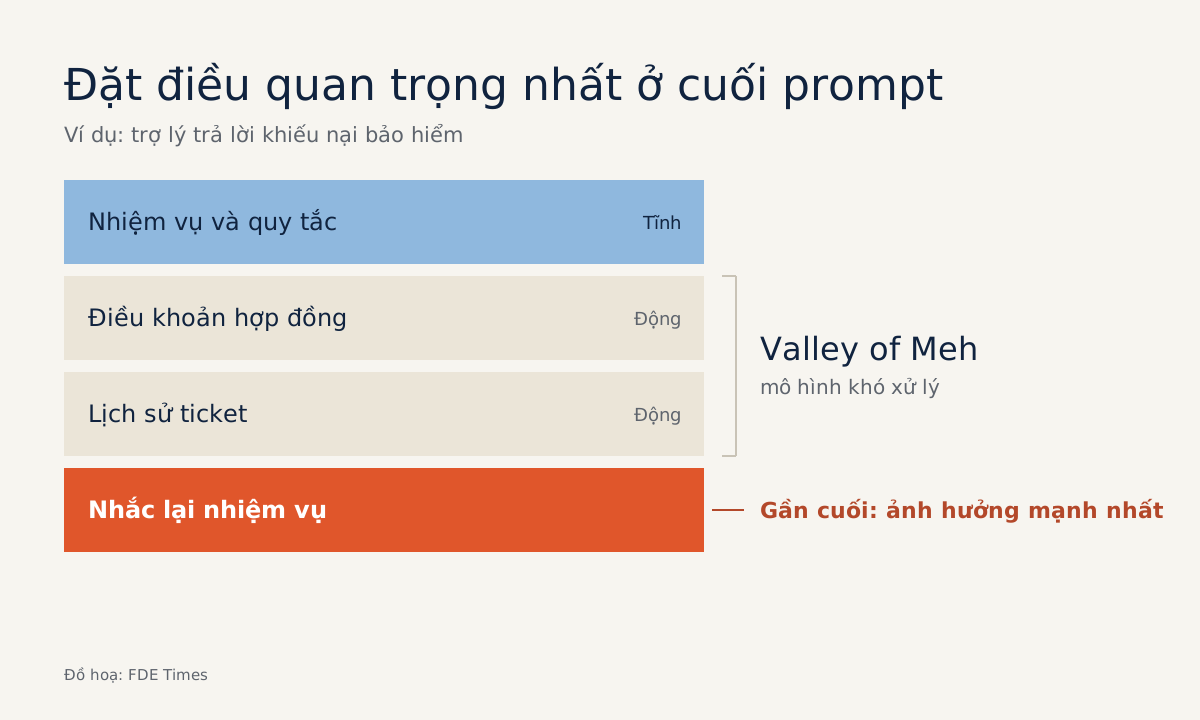
- Thông tin càng gần cuối prompt càng ảnh hưởng mạnh, còn phần giữa bị gọi là "Valley of Meh".
- Chọn ngữ cảnh là một vòng lặp: lấy phần tử tốt nhất theo độ dài token và phụ thuộc, lặp đến khi hết phần tử.
Prompt chạy trong production hiếm khi là một đoạn văn viết một lần rồi để yên.
Mỗi khi có request mới, hệ thống lại ghép prompt từ đầu, chọn ra vài mảnh ngữ cảnh từ một kho lớn hơn nhiều. Prompt Engineering for LLMs của John Berryman và Albert Ziegler dạy đúng kỹ năng đó, và đây cũng là kỹ năng tách một bản demo khỏi một hệ thống chạy được trên dữ liệu thật của khách hàng.
Sách do O’Reilly Media phát hành, phụ đề đầy đủ là The Art and Science of Building Large Language Model–Based Applications. Cửa hàng Helion ghi bản ebook ra ngày 4/11/2024 và lưu ý ngày bản in có thể khác, còn một trang bán sách khác ghi năm 2025.
Sách đi qua few-shot, chain-of-thought và RAG, nhưng theo trang giới thiệu, việc cốt lõi là thu thập, phân loại và trình bày các phần ngữ cảnh để dựng một prompt hiệu quả.
Với FDE, cách đọc đáng giá nhất là đừng coi prompt là một câu lệnh khéo léo. Hãy coi nó là đầu ra của một chương trình có đầu vào, có ràng buộc và có thứ tự thực thi. Hai tác giả không dùng đúng cách nói này, nhưng cách sách chia prompt thành những phần được gom, lọc rồi ghép lại dẫn thẳng tới đó.
Người viết đến từ ngành tìm kiếm, và sách thể hiện rõ điều đó
Helion giới thiệu Berryman là một trong những kỹ sư đầu tiên làm GitHub Copilot, chuyên về mô hình ngôn ngữ và hệ thống truy xuất thông tin. Trang Arcturus Labs của ông cũng nhắc tới việc ông góp sức vào giai đoạn đầu của Copilot và từng tham gia xây những hệ thống tìm kiếm, gợi ý có hàng triệu người dùng mỗi ngày.
Lý lịch đó giúp hiểu vì sao sách xử lý prompt giống một bài toán xếp hạng: nhiều ứng viên, chỗ có hạn, phải chọn. Cách nghĩ này có ích mỗi khi bạn phải tìm đúng hợp đồng, đúng ticket, đúng đoạn tài liệu rồi đặt chúng trước mô hình theo một trình tự có chủ đích.
Arcturus Labs hiện bán dịch vụ đưa một chuyên gia AI vào làm ngay trong đội của khách hàng. Trang không dùng chữ FDE, nhưng mô hình làm việc ấy rất gần với nghề của bạn.
Ý thứ nhất: tách phần tĩnh khỏi phần động
Theo ghi chú chương 5 của Strick van Linschoten, sách chia nội dung prompt thành hai loại: tĩnh và động. Phần động thay đổi theo từng request.
Thử hình dung bạn dựng trợ lý trả lời khiếu nại cho một khách hàng bảo hiểm. Giọng văn và quy tắc “chỉ trả lời dựa trên điều khoản hợp đồng” là phần tĩnh. Điều khoản của hợp đồng đang bị khiếu nại và lịch sử ticket của người gửi là phần động.
Tách hai phần ngay từ đầu giúp bạn kiểm thử chúng riêng: phần tĩnh quản lý như cấu hình có version, phần động như kết quả truy vấn. Mục lục trên Helion cũng đặt RAG, cùng lexical retrieval và neural retrieval, trong chương 5 về nội dung prompt, tức truy xuất là một cách lấy phần động.
Ý thứ hai: vị trí trong prompt có trọng lượng
Bản tóm tắt của Gigazine về chương 6 nêu rằng thông tin càng gần cuối prompt càng ảnh hưởng mạnh tới mô hình. Phần giữa được gọi là “Valley of Meh”, nơi mô hình khó xử lý thông tin.
Quay lại ví dụ bảo hiểm. Một lỗi dễ mắc ở bản đầu tiên là chỉ đặt quy tắc ở đầu prompt, rồi đổ năm đoạn điều khoản và lịch sử ticket vào sau.
Khi đó chỉ dẫn quan trọng nhất bị cả khối ngữ cảnh đẩy xa khỏi chỗ mô hình bắt đầu viết. Suy ra từ nhận định trên, cách sửa rẻ nhất là nhắc lại nhiệm vụ và ràng buộc ở phần kết, ngay trước câu trả lời.
Ngoài vị trí, bạn còn phải chọn khuôn trình bày. Cũng theo tóm tắt của Gigazine, tài liệu có cấu trúc như JSON, XML hay YAML rất hiệu quả, nhất là khi mô hình đã được huấn luyện để chờ đúng kiểu cấu trúc đó.
Ở dự án thật, bài toán trích xuất trường dữ liệu từ hóa đơn hợp với khuôn có cấu trúc. Nếu chọn văn xuôi, nhiều khả năng bạn sẽ phải viết thêm code chỉ để vá những đầu ra lệch định dạng.
Ý thứ ba: lắp ngữ cảnh là một thuật toán có ngân sách
Đây là phần khiến cuốn sách đọc giống sách lập trình nhất. Ghi chú chương 6 của Strick van Linschoten cho biết chương này dạy cách cấu trúc prompt, ghép các phần tử và chọn phần ngữ cảnh nào được đưa vào.
Theo tóm tắt của Gigazine, quy trình có nhiều bước, trong đó một bước là chọn phần tử tốt nhất có tính đến độ dài token và các phụ thuộc, rồi lặp lại cho đến khi hết phần tử.
Lỗi mà vòng lặp này chặn lại là đổ mọi chunk truy xuất được vào prompt. Prompt phình to, chi phí và độ trễ tăng, còn những mảnh thật sự quan trọng dễ rơi vào vùng giữa, đúng chỗ mô hình xử lý kém nhất.
Áp vào ví dụ bảo hiểm. Điều khoản hợp đồng có giá trị cao nhất. Ticket gần nhất có giá trị cao nhưng phụ thuộc vào việc đã có thông tin khách hàng. FAQ chung có giá trị thấp. Nếu khách hàng đòi phản hồi nhanh, bạn sẽ muốn hạ ngân sách token, và FAQ là thứ bị cắt trước.
Dưới đây là một bản phác thảo cho vòng lặp đó, đủ ngắn để bạn chép vào dự án và chỉnh tiếp:
def assemble_prompt(task, elements, token_budget):
    # elements: [{"id", "text", "value", "tokens", "depends_on", "order"}]
    remaining = sorted(elements, key=lambda e: e["value"], reverse=True)
    chosen, chosen_ids, used = [], set(), 0
    while remaining:                      # dừng khi hết phần tử
        e = remaining.pop(0)              # phần tử giá trị cao nhất còn lại
        if used + e["tokens"] > token_budget:
            continue                      # không vừa ngân sách thì bỏ qua
        if not set(e["depends_on"]) <= chosen_ids:
            continue                      # thiếu phần nó phụ thuộc thì bỏ qua
        chosen.append(e)
        chosen_ids.add(e["id"])
        used += e["tokens"]
    chosen.sort(key=lambda e: e["order"]) # sắp xếp rồi ghép
    context = "\n\n".join(e["text"] for e in chosen)
    return f"{task}\n\n{context}\n\nNhắc lại nhiệm vụ: {task}"
Bản này cố ý đơn giản: phần tử bị bỏ qua vì thiếu phụ thuộc sẽ không được xét lại. Nhưng nó đã đưa quyết định cắt gì vào code, nơi bạn có thể kiểm thử, chỉnh token_budget theo yêu cầu độ trễ và giải thích được với khách hàng, thay vì để quyết định đó nằm trong trí nhớ của người viết prompt.
Nên đọc theo thứ tự nào?
Gợi ý dưới đây chỉ dựa trên tên chương trên Helion và ghi chú của một người đọc về chương 5 và 6, không dựa trên mục lục đầy đủ hay toàn văn.
Nếu bạn đã gọi API của LLM nhưng chưa đưa hệ thống nào vào production, hãy đọc chương 5 về nội dung prompt trước để nắm cách tách tĩnh, động và các kiểu truy xuất, rồi mới sang chương 6, Assembling the Prompt.
Nếu bạn đã chạy RAG cho khách hàng, có thể vào thẳng chương 6. Đó là chỗ biến mớ ngữ cảnh truy xuất được thành một prompt có thứ tự rõ ràng và có giới hạn cụ thể.
Về nghề nghiệp, kỹ năng này nên được ghi trong CV bằng ngôn ngữ kỹ thuật. Một dòng như “thiết kế bộ lắp ráp prompt chọn ngữ cảnh theo ngân sách token và yêu cầu độ trễ” thuyết phục hơn nhiều so với “thành thạo prompt engineering”.
Khi đọc JD, hãy chú ý những vị trí nhắc đến context, retrieval hay latency bên cạnh LLM. Ở những nơi đó, người phỏng vấn sẽ muốn nghe bạn kể đã quyết định cắt bỏ thông tin gì, và vì sao.
Mẹo prompt sẽ lỗi thời theo từng thế hệ mô hình. Kỷ luật chọn gì để đưa vào và đặt nó ở đâu thì vẫn dùng được, và đó là thứ đáng giữ lại từ cuốn sách này.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Prompt Engineering for LLMs - John Berryman, Albert Ziegler (Helion) · 2024-11-04
- Prompt Engineering for LLMs: The Art and Science of Building Large Language Model–Based Applications 1st Edition
- Arcturus Labs – John Berryman
- Prompt Content: Notes on 'Prompt Engineering for LLMs' ch 5 · 2025-01-11
- Assembling the Prompt: Notes on ‘Prompt Engineering for LLMs’ ch 6 · 2025-01-12
- Prompt Engineering for LLMs (Gigazine) · 2025-08-19