Khoá Agent Memory của DeepLearning.AI và Oracle: giữ lại phần tư duy, thay lớp cơ sở dữ liệu
Khoá có hai giờ video do hai người của Oracle giảng dạy, nhưng thứ đáng mang tới chỗ khách hàng là cách thiết kế pipeline trí nhớ, còn database thì thay được.

Tóm tắt nhanh
- Khoá ngắn khoảng hai giờ trên DeepLearning.AI, làm cùng Oracle; cả hai giảng viên đều đang làm ở Oracle.
- Ba ý nên giữ lại: trí nhớ là hạ tầng, ghi nhớ là một pipeline, và danh sách tool cũng có thể truy xuất theo ngữ nghĩa.
- Khi khách không dùng Oracle, chỉ cần thay lớp lưu trữ; LangGraph đã tách sẵn trí nhớ ngắn hạn và dài hạn.
Phần giới thiệu khoá Agent Memory: Building Memory-Aware Agents trên DeepLearning.AI mở đầu bằng một nhận xét quen thuộc với ai từng đưa agent lên production: phần lớn agent chạy tốt trong một phiên, nhưng phiên vừa kết thúc là mất hết. Mọi thứ người dùng đã dặn đều phải nói lại từ đầu.
Với FDE, lỗi này hiếm khi lộ ra trong buổi demo. Nó thường xuất hiện vào tuần thứ hai, khi người dùng thật bắt đầu hỏi agent vì sao nó không nhớ chuyện hôm qua.
Khoá học này nhắm đúng vào vấn đề đó, nhưng nó được làm cùng một hãng bán database. Vì thế câu hỏi thực tế là: học những gì, và bỏ những gì khi khách của bạn không dùng Oracle?
Ai dạy, và đối tượng là ai?
Đây là khoá ngắn DeepLearning.AI làm chung với Oracle. Hai giảng viên là Richmond Alake, Director of AI Developer Experience tại Oracle, và Nacho Martínez, Principal Data Science Advocate tại Oracle. Nói cách khác, nội dung do chính nhà cung cấp soạn, và stack trong khoá là Oracle AI Database, LangChain và các pipeline dùng LLM.
Điều đó không làm khoá kém giá trị đi, nhưng bạn nên đọc nó với con mắt của người phải triển khai trên hạ tầng của khách. Trang khoá học ghi đối tượng là developer đã xây agent và muốn đi xa hơn tương tác một phiên. Yêu cầu đầu vào chỉ có Python và kiến thức cơ bản về LLM, không cần biết Oracle.
Bảy video, ba bài là phần chính
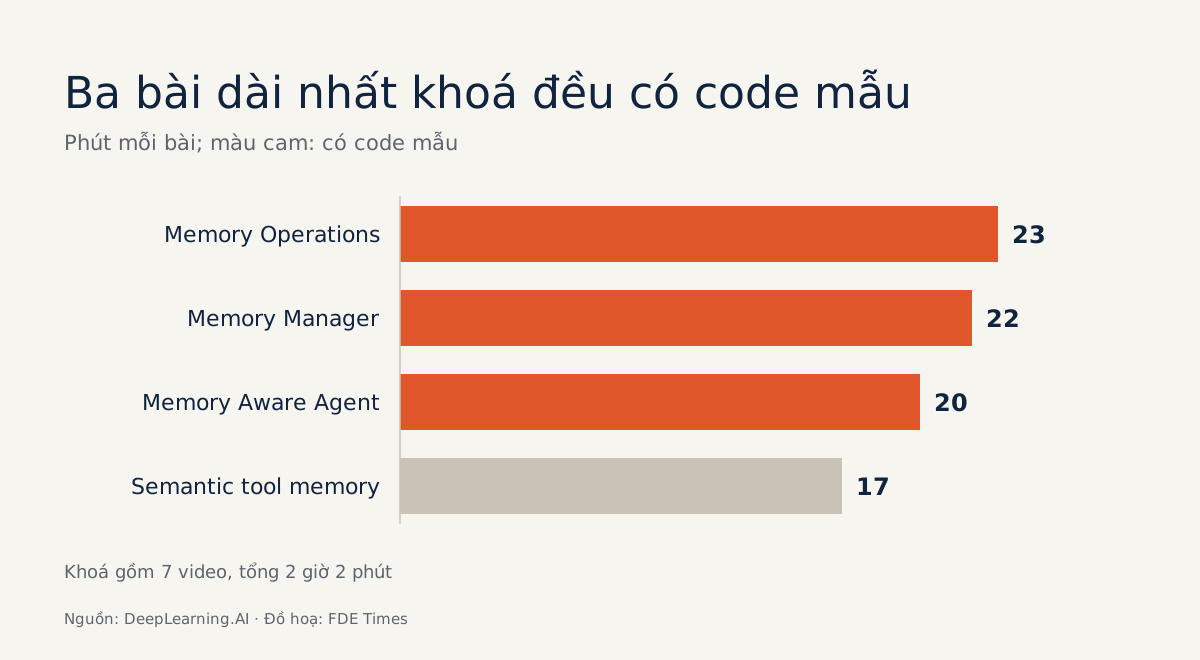
Khoá gồm 7 video. Phần đầu trang ghi tổng thời lượng 2 giờ 2 phút, còn một số trang tìm kiếm hiển thị 1 giờ 57 phút. Ba bài dài nhất cũng là ba bài thực hành nhiều nhất, đều có code mẫu: Memory Manager (22 phút), Memory Operations (23 phút) và Memory Aware Agent (20 phút).
Nên học theo đúng thứ tự, vì bài cuối là một capstone: một agent nhớ được trạng thái qua các phiên, tải lại ngữ cảnh cũ ngay khi khởi động. Nếu chỉ có một buổi tối, hãy dành phần lớn thời gian cho ba bài có code và tự gõ lại, đừng chỉ xem.
Ý thứ nhất: trí nhớ là hạ tầng, không phải một đoạn prompt
Khoá học gọi cách tiếp cận của mình là memory engineering, tức coi trí nhớ dài hạn là hạ tầng cốt lõi, đặt bên ngoài model. Thay đổi tư duy này quan trọng hơn mọi dòng code trong khoá.
Khi đã coi trí nhớ là hạ tầng, bạn sẽ hỏi những câu của một kỹ sư hạ tầng: dữ liệu nằm ở đâu, ai được đọc, khi nào hết hạn, sai thì sửa thế nào. Đó cũng là những câu đội bảo mật của khách sẽ hỏi bạn.
Ý thứ hai: ghi nhớ là một pipeline, không phải một lệnh insert
Trong các mục tiêu khoá học có việc xây một Memory Manager quản lý nhiều loại trí nhớ, cùng pipeline gồm ba bước: trích xuất, hợp nhất và ghi lại. Bước giữa là bước dễ bị bỏ qua nhất.
Thử hình dung một agent hỗ trợ nội bộ. Ở phiên 1, người dùng nói nhóm họ dùng Postgres. Đến phiên 3, họ báo đã chuyển sang Snowflake.
Nếu pipeline chỉ trích xuất rồi ghi thẳng vào kho, agent sẽ giữ cả hai “sự thật” và có thể trả lời theo cái cũ. Bước hợp nhất phải nhận ra hai bản ghi mâu thuẫn và cập nhật thay vì cộng dồn.
Một phác thảo tối giản cho bước này, viết để minh hoạ chứ không phải code trong khoá, trông như sau:
def consolidate(new_fact, store):
    # Tìm bản ghi cũ cùng người dùng, cùng chủ đề (vd. "database của nhóm")
    old = store.find(user_id=new_fact.user_id, key=new_fact.key)
    if old is None:
        store.insert(new_fact)                      # điều mới: thêm vào
    elif old.value != new_fact.value:
        store.update(old.id, value=new_fact.value)  # đổi ý: ghi đè, không cộng dồn
    # giống hệt bản cũ: bỏ qua, tránh trùng lặp
Phần khó trong thực tế là sinh ra key ổn định, để “chúng tôi dùng Postgres” và “đã chuyển sang Snowflake” rơi vào cùng một chủ đề. Ở chỗ khách, việc đầu tiên nên làm là viết vài kịch bản đổi ý như vậy thành test, trước cả khi chọn database.
Ý thứ ba: danh sách tool cũng có thể truy xuất
Một bài dài 17 phút nói về semantic tool memory để mở rộng số tool agent dùng được. Đây là một mẫu truy xuất, dùng được với mọi vector store.
Giả sử khách có hàng trăm API nội bộ. Nhồi hết mô tả vào prompt vừa tốn token vừa làm model chọn nhầm. Cách hợp lý hơn là embed mô tả từng tool, rồi mỗi lượt chỉ đưa vào vài tool gần nghĩa nhất với yêu cầu.
Bỏ gì khi khách không dùng Oracle?
Phần dành riêng cho Oracle khá gọn. Nó nằm ở gói langchain-oracledb với vector store OracleVS; driver python-oracledb được cài kèm theo. Riêng hybrid search cần Oracle Database 26ai. Nếu khách không chạy Oracle, đây là lớp bạn thay đi.
Phần còn lại vẫn dùng được nhờ cách LangGraph tổ chức sẵn. Tài liệu của LangGraph tách trí nhớ ngắn hạn theo thread khỏi trí nhớ dài hạn, dùng để lưu dữ liệu riêng của người dùng hoặc ứng dụng qua nhiều cuộc hội thoại.
Với trí nhớ ngắn hạn, LangGraph khuyên dùng checkpointer có database phía sau khi lên production. Trí nhớ dài hạn là một kho riêng, nhưng cũng chỉ là một lớp lưu trữ, nên cả hai lớp đều có thể đặt lên database khách đang vận hành.
Vì vậy, trong buổi discovery đầu tiên, hãy hỏi khách đang chạy database nào và ai quản lý nó. Câu trả lời sẽ quyết định nơi pipeline trí nhớ được đặt, còn thiết kế của pipeline thì giữ nguyên.
Đưa kỹ năng này vào CV thế nào?
Khi đọc mô tả công việc FDE, hãy để ý các cụm như stateful agent, long-term memory hay multi-session. Gặp những cụm đó, bạn nên chuẩn bị sẵn một ví dụ cụ thể về cách mình xử lý chuyện agent quên ngữ cảnh giữa các phiên để kể khi phỏng vấn.
Chứng chỉ hoàn thành khoá không nói lên nhiều. Một repo nhỏ thì có sức nặng hơn: dựng lại capstone trên một database không phải Oracle, kèm bộ test cho các kịch bản đổi ý. Repo đó cho người phỏng vấn thấy bạn biết tách ý tưởng ra khỏi nhà cung cấp, và đó là việc FDE phải làm hằng tuần.
Khoá học này dạy agent cách nhớ. Còn việc chọn chỗ đặt trí nhớ đó trong hạ tầng của khách thì vẫn là trách nhiệm của FDE.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!