Khoá eval của W&B dạy dựng LLM judge, nhưng judge vẫn cần người chấm
Tài liệu Weave bổ sung cách tách kiểm tra bằng code khỏi judge, phần đáng mang về site khách hàng nhất.
Tóm tắt nhanh
- Khoá LLM Apps: Evaluation của Weights & Biases dạy cách xây, tối ưu và mở rộng LLM judge.
- Tài liệu Weave bổ sung phần đáng giữ: cho code chấm trước, judge chấm sau, và quản lý prompt của judge như code.
- Phần cần dè chừng: lời hứa ít cần người chấm, vì định nghĩa thế nào là tốt vẫn do khách hàng quyết định.
Weights & Biases giới thiệu khoá “LLM Apps: Evaluation” với một mục tiêu đầy tham vọng. Theo thông báo cập nhật lần cuối ngày 8/1/2025, khoá học hướng tới các kỹ thuật xây, tối ưu và mở rộng bộ đánh giá AI mà chỉ cần rất ít công sức của con người. Với người làm FDE, câu đó vừa là lời mời vừa là cái bẫy.
Lời mời nằm ở chỗ gần như khách hàng nào cũng hỏi cùng một câu sau buổi demo: làm sao biết hệ thống này đủ tốt để đưa vào production? Cái bẫy nằm ở vế “ít con người”. Tại site khách hàng, người định nghĩa được thế nào là “tốt” thường là chuyên viên nghiệp vụ của họ, không phải một model khác.
Vì thế, nên học khoá này song song với tài liệu Weave. Khoá tập trung vào LLM judge, còn tài liệu Weave cho thấy cách ghép kiểm tra bằng code với judge thành một pipeline đánh giá lai. Riêng lời hứa tự động hoá thì nên giữ khoảng cách.
Khoá học thật sự dạy kỹ năng gì?
W&B giới thiệu đây là khoá học về xây LLM judge. Trang khoá học chính thức trên wandb.ai trả về lỗi 404, nên hiện chỉ bài thông báo của hãng xác nhận tên khoá và nội dung. Chương 3 do Ayush Thakur phụ trách, tập trung vào cách cấu trúc một LLM evaluator.
Theo W&B, cách tiếp cận của chương 3 biến những tiêu chí chủ quan như ngữ pháp, độ mạch lạc và logic thành các phép kiểm tra lặp lại được và mở rộng được.
Nền công cụ là Weave của W&B. Trang sản phẩm về evaluation của hãng định nghĩa đánh giá là đo xem agent và ứng dụng AI hoạt động tốt đến đâu, xét theo nhiều khía cạnh, bằng benchmark, kịch bản thực tế và phân tích so sánh. Đơn vị trung tâm là scorer, nhận đầu vào và đầu ra của ứng dụng rồi trả về metric.
Kỹ năng FDE mà khoá học rèn là biến một yêu cầu mơ hồ của khách hàng, chẳng hạn “câu trả lời phải chuyên nghiệp”, thành phép đo chạy lại được mỗi khi đổi prompt hay đổi model.
Hai loại scorer, hai loại câu hỏi
Tài liệu Weave chia scorer thành hai phía. Phía code là function-based scorer: một hàm Python bình thường gắn decorator @weave.op và trả về dictionary. Ví dụ trong tài liệu đơn giản đến mức dễ bị coi nhẹ: kiểm tra xem văn bản có viết hoa toàn bộ hay không.
Phía còn lại là LLM-as-a-judge. Prompt chấm điểm có thể tham chiếu các biến của op đang được đánh giá. Với dạng này, tài liệu khuyên dùng class-based Scorer, một phần để dễ thử nhiều prompt khác nhau cho judge.
Scorer bằng code
- Hàm Python gắn @weave.op
- Rẻ, nhanh, cùng đầu vào luôn cho cùng kết quả
- Hợp với định dạng, trường bắt buộc, độ dài
LLM judge
- Class-based Scorer với prompt chấm điểm
- Tốn lời gọi model, kết quả có thể dao động
- Hợp với mạch lạc, logic, giọng văn
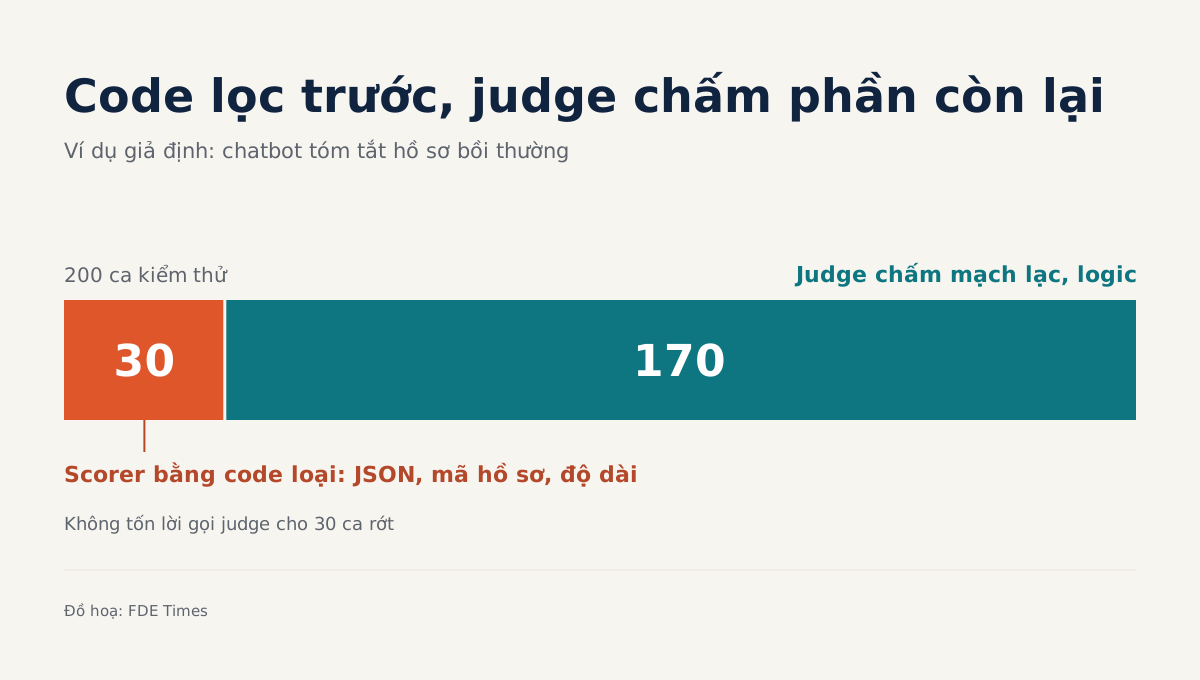
Lấy một ví dụ giả định: chatbot tóm tắt hồ sơ bồi thường cho một công ty bảo hiểm, với bộ 200 ca kiểm thử.
Scorer bằng code kiểm tra đầu ra có parse được thành JSON không, có mã hồ sơ đúng định dạng không và có vượt giới hạn độ dài không.
Nếu 30 ca rớt ngay ở bước này thì lỗi đã rõ, không cần tốn lời gọi judge cho chúng.
Chỉ 170 ca còn lại mới được chuyển sang judge để chấm độ mạch lạc và tính đúng đắn về logic. Judge chỉ nên trả lời những câu mà code không trả lời được.
Ba ý đáng mang về site khách hàng
Ý đầu tiên chính là thứ tự ở ví dụ trên: chạy code trước, judge sau. Rẻ và chắc chắn đi trước, đắt và dao động đi sau. Nhờ vậy, khi báo cáo với khách hàng, bạn tách được lỗi định dạng, thứ sửa trong một buổi chiều, khỏi lỗi chất lượng, thứ cần thảo luận với họ.
Ý thứ hai là chia nhỏ tiêu chí chủ quan.
Chương 3 cho thấy ngữ pháp, mạch lạc và logic đều có thể thành phép kiểm tra lặp lại được; bước nên làm tiếp là giao mỗi tiêu chí cho một scorer riêng, thay vì hỏi judge một câu chung chung kiểu “câu trả lời có tốt không” rồi nhận về một điểm tổng.
Khi điểm tụt, bạn biết ngay chiều nào hỏng.
Ý thứ ba: prompt của judge cũng là code. Lời khuyên dùng class-based Scorer để thử nhiều prompt cho thấy judge cần được đặt phiên bản, so sánh và lặp lại như mọi thành phần khác của hệ thống.
Phần nên tự bổ sung: người chấm
Mục tiêu “ít công sức con người” hợp lý ở giai đoạn mở rộng, khi judge đã chạy ổn định trên hàng nghìn đầu ra. Ở giai đoạn định nghĩa thì không.
Trước khi dùng điểm của judge trong báo cáo cho khách hàng, hãy nhờ chuyên viên của họ gán nhãn một mẫu nhỏ và so với điểm judge. Nếu hai bên lệch nhau, chỉnh prompt rồi mới mở rộng.
Đây cũng là bước giúp bạn được khách hàng tin. Một con số do chính đội của họ xác nhận thuyết phục hơn mọi biểu đồ dashboard.
Ai nên học, và học theo thứ tự nào
Khoá học hợp nhất với kỹ sư đã đưa được một ứng dụng LLM lên chạy nhưng chưa có bộ đánh giá nào.
Hãy bắt đầu từ trang tổng quan về scorer trong tài liệu Weave (docs.coreweave.com/weave/guides/evaluation/scorers) và viết một function-based scorer cho dự án của bạn.
Sau đó học chương 3 về cách cấu trúc evaluator, rồi mới chuyển sang class-based judge.
Về mặt nghề nghiệp, khi đọc tin tuyển dụng FDE, hãy chú ý các cụm như “evals” hay “LLM-as-a-judge”. Trên CV, đừng ghi chung chung “có kinh nghiệm đánh giá LLM”. Hãy mô tả pipeline bạn đã dựng: bao nhiêu scorer bằng code, judge chấm những tiêu chí nào, và bạn đã kiểm tra judge với nhãn của người thật ra sao.
Khoá học dạy bạn dựng một judge. Ở site khách hàng, phần việc khó hơn là chứng minh judge đó chấm đúng, và đó là lúc bạn bắt đầu làm việc như một FDE.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!