Khoá học của DeepLearning.AI bắt bạn cho LLM bịa trước khi sửa
Gần hai giờ học, một agent text-to-SQL và một thứ tự sửa lỗi mà FDE nào cũng nên thuộc lòng.
Tóm tắt nhanh
- Khoá ngắn 1 giờ 51 phút, trình độ trung cấp, do Sharon Zhou (Lamini) và Amit Sangani (Meta) giảng dạy.
- Bài học bắt đầu bằng việc cố tình làm agent text-to-SQL chạy trên Llama 3-8b bịa ra kết quả, để mở đầu quá trình đánh giá.
- Fine-tuning với LoRA và MoME được xếp cuối, sau prompting và self-reflection.
Khoá học dài 1 giờ 51 phút này bắt bạn làm một việc gần như không ai làm khi chuẩn bị demo: cố tình khiến agent của chính mình bịa. Bạn dựng một agent chuyển câu hỏi thành SQL, rồi chủ động tạo ra những tình huống nó trả lời sai để bắt đầu quá trình đánh giá.
Đó là bước mở đầu của Improving Accuracy of LLM Applications, khoá học ngắn của DeepLearning.AI ở trình độ trung cấp, gồm 7 video và 4 ví dụ code. Khoá ra mắt trên diễn đàn cộng đồng của DeepLearning.AI ngày 14/8/2024, làm cùng hai đối tác Lamini và Meta.
Với FDE, khoá này đáng một buổi tối. Bài toán được đặt ra rất gọn: dựng một SQL agent, rồi gắn chỉ số đánh giá để biết nó làm tốt đến đâu. Nếu khách hàng của bạn từng than agent “lúc đúng lúc sai”, đây chính là kỹ năng bạn cần.
Hai người dạy, một bài toán rất giống việc thật
Sharon Zhou là đồng sáng lập kiêm CEO của Lamini. Amit Sangani là Giám đốc cấp cao mảng Partner Engineering của Meta. Coursera cũng đưa khoá này lên dưới dạng một dự án thực hành.
Dự án xuyên suốt khoá học dùng Llama 3-8b để dựng một ứng dụng text-to-SQL trên một schema tự định nghĩa. Đây là kiểu bài toán FDE hay gặp khi ngồi ở chỗ khách hàng.
Cơ sở dữ liệu của khách hàng thường có tên bảng, tên cột riêng mà mô hình chưa từng thấy. Tập làm việc với một schema tự định nghĩa là cách luyện sát với tình huống đó.
Làm nó sai trước, đo kỹ sau
Khoá mở màn bằng việc giả lập lỗi bịa, để có những ca thất bại đầu tiên làm điểm xuất phát cho việc đánh giá. Sau đó mới đến chuỗi việc chính: dựng và nối ứng dụng hoàn chỉnh, prompt engineering kèm self-reflection, rồi đánh giá chặt chẽ.
Nhìn qua thì đánh giá có vẻ đến sau khi sửa prompt, nhưng thực ra có hai lớp đánh giá khác nhau. Những ca bịa ở đầu là phép thử nhanh để biết agent hỏng ở đâu. Còn khung đánh giá ở sau là thứ trang khoá học yêu cầu bạn tự dựng, để đo hiệu năng một cách có hệ thống.
Lấy một ví dụ giả định để thấy vì sao lớp thứ hai không thể bỏ qua. Bạn gom 20 câu hỏi thật của đội sales kèm câu SQL đúng, và agent trả lời đúng 14 câu, tức 70%.
Sau khi sửa prompt, nó đúng 17 câu, tức 85%, nhưng lại làm sai hai câu mà trước đó nó trả lời đúng. Không có bộ 20 câu đó, bạn chỉ thấy vài lần thử “có vẻ tốt hơn” và mang lỗi mới sang buổi họp với khách.
Vì thế, việc đầu tiên nên làm ở khách hàng là xin câu hỏi thật và đáp án đúng do chính người dùng xác nhận. Bộ dữ liệu nhỏ ấy sẽ là thước đo cho mọi thay đổi về sau.
Fine-tuning được xếp cuối, và có lý do
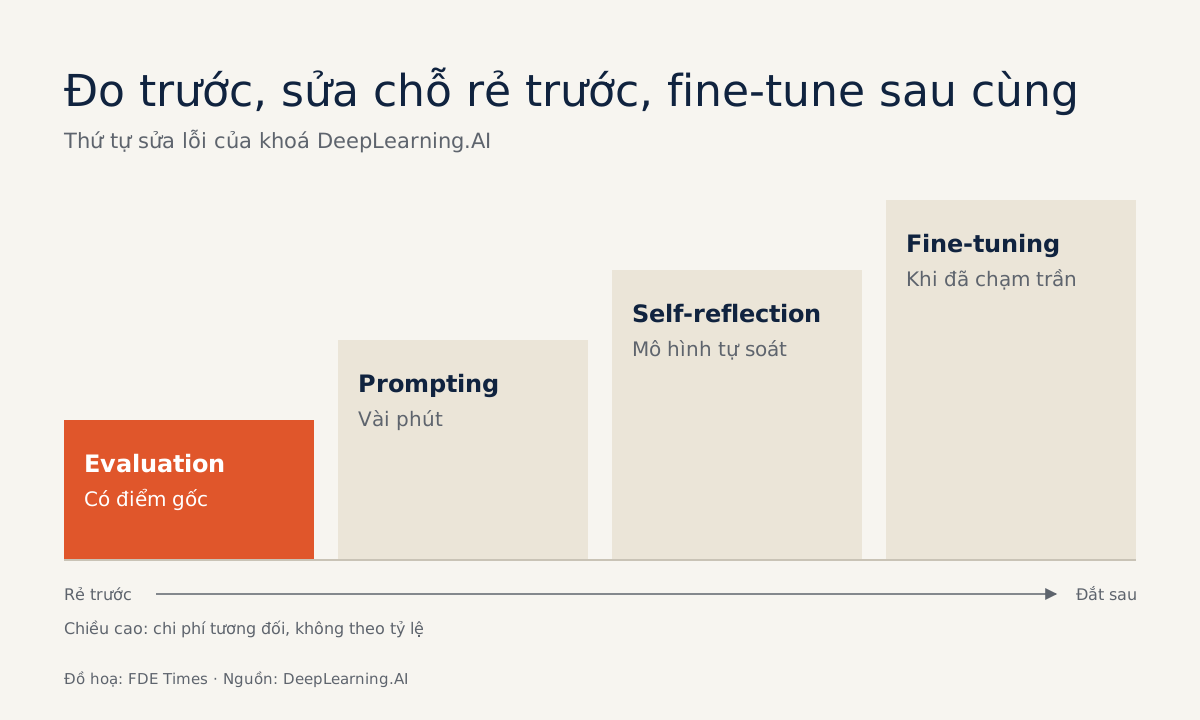
Trong khoá, fine-tuning là bước tiếp theo, đứng sau prompting và self-reflection. Thứ tự này hợp lý khi nhìn từ phía triển khai: thay prompt tốn vài phút, còn fine-tuning cần dữ liệu, hạ tầng và thời gian chờ kết quả.
Khi đến lượt fine-tuning, khoá học dùng chính LLM để tạo dataset, rồi giới thiệu instruction fine-tuning và các kỹ thuật PEFT như LoRA và Mixture of Memory Experts (MoME). Khoá cũng trình bày memory tuning của Lamini, cách nhúng sự kiện vào mô hình để giảm hallucination.
Những người làm khoá gọi memory tuning là một hướng mới cho độ chính xác về sự kiện. Lời khen này đến từ chính công ty làm ra kỹ thuật, nên bạn nên tự kiểm chứng bằng eval trên bài toán của mình. Dữ liệu tổng hợp do LLM tạo ra mà chưa qua kiểm tra cũng có thể dạy cho mô hình đúng những lỗi bạn đang muốn sửa.
Ai nên học, và học theo thứ tự nào
Khoá xếp ở trình độ trung cấp và học qua code, nên phù hợp nhất với người đã viết Python thường xuyên và từng dựng thử một ứng dụng dùng LLM. Nếu bạn mới bắt đầu với LLM, hãy làm quen với prompting cơ bản trước.
Nếu thời gian ít, hãy xem phần dựng khung đánh giá trước, áp ngay vào một dự án đang làm, rồi mới quay lại phần prompting và fine-tuning. Phần fine-tuning hữu ích nhất khi bạn đã có điểm gốc để so sánh.
Về nghề nghiệp, khi đọc tin tuyển dụng FDE, hãy coi những dòng nhắc tới evals hay đo độ chính xác là tín hiệu công việc cần đúng chuỗi kỹ năng này. Vào phỏng vấn, kể được bạn đã đi theo thứ tự nào, từ ca lỗi, prompt, eval rồi mới fine-tune, và vì sao, sẽ thuyết phục hơn việc liệt kê tên kỹ thuật.
Trên CV cũng vậy: một dòng ghi rõ bộ eval bao nhiêu câu và độ chính xác tăng từ mức nào lên mức nào nói nhiều hơn “có kinh nghiệm LLM”. Hãy điền điểm thật từ dự án của bạn; 70% và 85% ở trên chỉ là số minh hoạ.
Giá trị lớn nhất của khoá không nằm ở LoRA hay MoME mà ở thứ tự: chỗ rẻ trước, chỗ đắt sau, và chỉ fine-tune khi số đo cho thấy prompting đã chạm trần. Một FDE thuộc thứ tự ấy sẽ ít phải hứa với khách điều mình chưa đo.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Improving Accuracy of LLM Applications - DeepLearning.AI
- New Course! Enroll in Improving Accuracy of LLM Applications · 2024-08-14
- ksm26/Improving-Accuracy-of-LLM-Applications (GitHub, student repo of the course)
- Improving Accuracy of LLM Applications - Lesson 1: Introduction (DeepLearning.AI Learn)
- Improving Accuracy of LLM Applications - Coursera