Smol Course của Hugging Face: ba unit đầu đáng học nếu bạn làm FDE
Một khoá học xoay quanh model nhỏ SmolLM3, mỗi tuần 3-4 giờ, dạy đúng câu hỏi khách hàng sẽ đặt ra: model đã tinh chỉnh có thật sự làm tốt việc của họ không?

Tóm tắt nhanh
- Smol Course là khoá thực hành của Hugging Face, xây quanh SmolLM3. Mỗi chương học trong khoảng một tuần, 3-4 giờ.
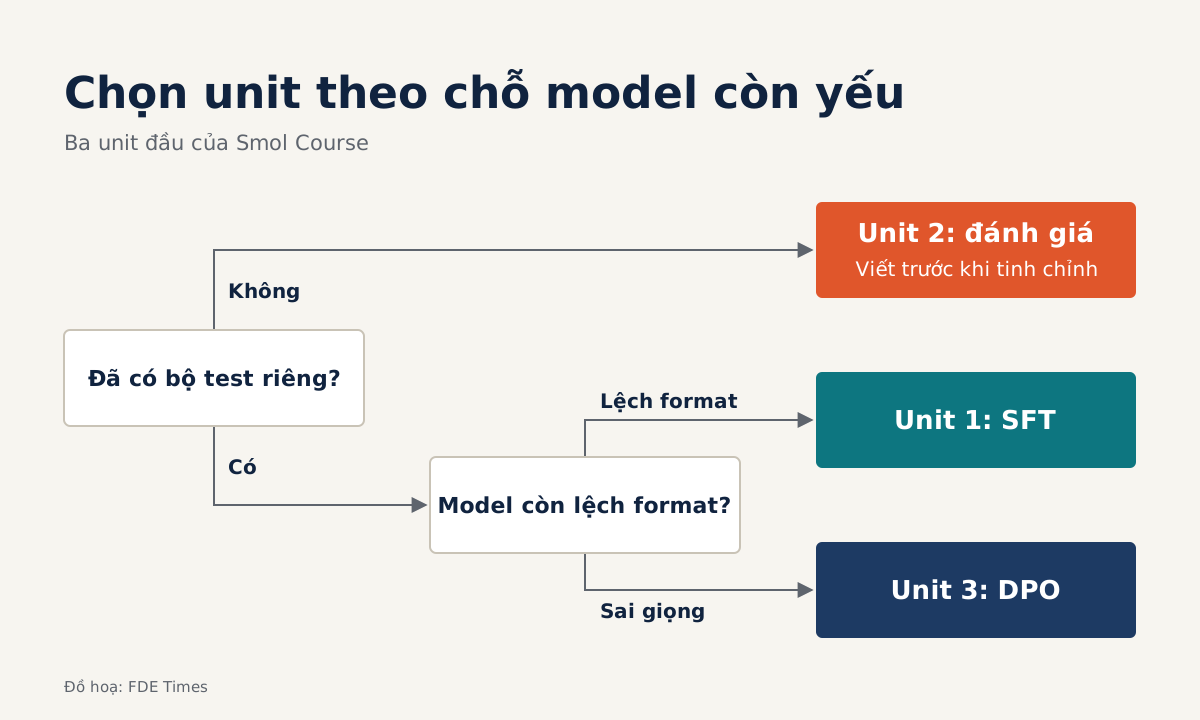
- Với FDE, ba unit đáng giá nhất là SFT (Unit 1), đánh giá (Unit 2) và DPO (Unit 3), nên học đúng theo thứ tự này.
- Học xong Unit 1 thì có chứng chỉ nền tảng. Muốn có chứng chỉ hoàn thành phải xong mọi unit và nộp final project, và project đó dùng làm portfolio được.
Một model nhỏ, một chiếc máy cá nhân và mỗi tuần 3-4 giờ. Theo Hugging Face, chừng đó là đủ để bắt đầu học cách dạy một language model làm đúng việc khách hàng cần.
Khoá học đó là Smol Course. README của repo huggingface/smol-course tự giới thiệu là một khoá thực hành về alignment language model cho use case cụ thể của người học.
Với FDE, cụm “use case cụ thể” chính là công việc hằng ngày. Khách hàng hiếm khi cần một model biết mọi thứ. Họ cần một model trả lời đúng định dạng, đúng giọng và đúng nghiệp vụ của họ, rồi cần bằng chứng rằng nó làm được thật.
Smol Course dạy cả hai vế đó trên một model nhỏ, đủ để bạn tự tập trước khi phải làm thật với một hệ thống lớn.
Ai làm khoá này, và nó nặng đến đâu?
Khoá học xây quanh SmolLM3, model ngôn ngữ nhỏ của Hugging Face. Trang Hugging Face Learn ghi rõ đối tượng là software developer và kỹ sư muốn nhanh chóng nắm được kỹ năng fine-tuning LLM. Mỗi chương được thiết kế để xong trong một tuần, khoảng 3-4 giờ làm bài, nên một kỹ sư đang đi làm toàn thời gian vẫn xếp lịch được.
Về phần cứng, hai nguồn chính thức nói hơi khác nhau. README khẳng định mọi thứ chạy được trên hầu hết máy cá nhân. Trang Learn thì chỉ yêu cầu máy có internet và nói thêm là nên có GPU.
Câu “chạy được trên hầu hết máy cá nhân” là lời tự giới thiệu trong README, chưa được ai kiểm chứng độc lập. Vì vậy, cách hợp lý là cứ chạy thử trên máy bạn đang có, chỉ khi chậm quá mới tìm GPU.
Phiên bản hiện tại là “smol course v2”, gồm bảy unit: instruction tuning, đánh giá, preference alignment, vision language model, reinforcement learning, synthetic data và một buổi “trao giải”. Lịch học năm 2025 chạy đến tháng 12/2025, nên giờ bạn sẽ tự học theo nhịp riêng.
SFT là thứ đầu tiên nên thử
Unit 1 dạy supervised fine-tuning (SFT). Khoá học gọi đây là kỹ thuật cốt lõi để một model đã pre-train biết làm theo chỉ dẫn. Một trong các mục tiêu của unit là tinh chỉnh SmolLM3 cho nhiều tác vụ khác nhau.
Thử hình dung một khách hàng logistics muốn model đọc email khiếu nại rồi trả về JSON với ba trường: mã đơn, loại sự cố, mức độ khẩn. Prompt dài đến mấy thì thỉnh thoảng model vẫn lệch format.
SFT trên vài trăm cặp email và JSON do chính nhân viên của khách gán nhãn là cách trực tiếp nhất để dạy model đúng hành vi đó. Unit 1 cho bạn tập đúng thao tác này trên một model rẻ trước khi phải làm thật.
Đánh giá trên dữ liệu của khách mới thuyết phục được họ
Unit 2 nói về đánh giá: benchmark và custom domain evaluation. Benchmark công khai cho biết model khá ở mức chung chung. Khách hàng thì chỉ quan tâm nó có làm tốt việc của họ không.
Quay lại ví dụ email khiếu nại. Trước khi tinh chỉnh, bạn có thể tách riêng chẳng hạn 50 email mà model chưa từng thấy, rồi đếm xem model gốc trả về bao nhiêu JSON hợp lệ với đúng loại sự cố. Tinh chỉnh xong, bạn chạy lại trên đúng 50 email đó, và hai con số trước và sau sẽ thuyết phục hơn mọi slide.
Unit 1 vẫn phải học trước, vì không có model đã tinh chỉnh thì chẳng có gì để đánh giá, nhưng thứ đáng giữ lâu nhất lại là thói quen của Unit 2. Tự xây bộ test riêng cho từng bài toán là kỹ năng FDE dùng lại được ở mọi dự án, bất kể model là gì.
Đúng rồi mà khách vẫn chưa ưng? Đến lượt DPO
Unit 3 dạy preference alignment, tức là kéo model về phía những câu trả lời con người ưa thích hơn, bằng các thuật toán như DPO. Tình huống này hay gặp sau SFT: model đã đúng format, nhưng chuyên viên của khách vẫn thấy câu trả lời dài dòng hoặc sai giọng.
Thử hình dung bạn nhờ chuyên viên của khách chọn câu tốt hơn trong từng cặp câu trả lời của model. Dữ liệu dạng “cái này hơn cái kia” thường dễ thu thập hơn việc bắt họ tự viết câu trả lời mẫu từ đầu.
Biết khi nào nên dùng SFT và khi nào nên dùng preference alignment là điều giúp bạn đề xuất đúng việc cho khách ngay từ đầu.
Học theo thứ tự nào, và đưa vào CV ra sao?
Với FDE, nên học Unit 1, rồi Unit 2, rồi Unit 3. Các unit về vision language model, reinforcement learning và synthetic data nên để sau, khi dự án thật cần đến. Có hai mức chứng chỉ: chứng chỉ nền tảng chỉ cần xong Unit 1, còn chứng chỉ hoàn thành đòi hỏi xong mọi unit và nộp một final project.
Final project mới là phần đáng giá. Hãy chọn một tác vụ hẹp, giống việc thật của khách hàng, và trình bày trên CV theo trình tự: bài toán, bộ đánh giá tự xây, kết quả trước và sau SFT, rồi phần cải thiện thêm nhờ DPO. Để phần chứng minh model đã tốt hơn chiếm chỗ chính, còn tên chứng chỉ chỉ nên là một dòng phụ.
Một model nhỏ chạy trên máy cá nhân sẽ không thay được hệ thống bạn triển khai cho khách. Nhưng nó cho bạn chỗ để mắc lỗi rẻ, trước khi phải mắc lỗi đắt trên dữ liệu thật của khách hàng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!