LLM Bootcamp 2023 của Full Stack Deep Learning: bỏ qua phần công cụ, học kỹ phần LLMOps
Khoá học ra đời từ thời LangChain còn mới, nên phần lớn tên công cụ trong đó đã cũ, nhưng cách nó dạy kiểm thử, quản lý prompt và đưa ứng dụng LLM lên production vẫn đúng với việc của một FDE hôm nay.

Tóm tắt nhanh
- LLM Bootcamp do Charles Frye, Sergey Karayev và Josh Tobin dạy tại San Francisco vào tháng 4/2023, hiện có bản ghi hình miễn phí.
- Các công cụ cụ thể (LangChain, Colab, AutoGPT, BabyAGI) đã thuộc về năm 2023; cách tư duy về retrieval, đánh giá và UX thì vẫn dùng được.
- Ba ý nên giữ: dữ liệu production luôn khác dữ liệu test, prompt phải đi qua Git và CI, và giao diện ngôn ngữ là một phần của sản phẩm.
Một khoá học về LLM từ tháng 4/2023, nhưng lời khuyên đáng nhớ nhất trong đó lại rất bình thường: hãy lưu prompt trong Git. Trong bài giảng LLMOps, Josh Tobin cho rằng phần lớn các đội nên làm vậy, vì Git dễ dùng và đã nằm sẵn trong quy trình làm việc của họ.
Khoá học có tên chính thức là “LLM Bootcamp - Spring 2023”, do The Full Stack (Full Stack Deep Learning) tổ chức. Charles Frye, Sergey Karayev và Josh Tobin dạy trực tiếp tại San Francisco, sau đó đưa toàn bộ bản ghi hình lên mạng miễn phí.
Mục tiêu họ đặt ra là giúp người học nắm kịp trình độ mới nhất và có thể tự xây, tự triển khai ứng dụng LLM, kể cả khi chưa có kinh nghiệm ML.
Nếu việc của bạn là biến một bản demo thành hệ thống có người dùng thật, khoá học này đi đúng chặng đường đó, từ prompt tới production. Vấn đề là nhiều tên công cụ trong khoá đã cũ, nên bạn cần biết bài nào học kỹ, bài nào chỉ cần xem lướt.
Phần nào đã cũ, phần nào vẫn dùng được?
Bài prompt engineering dạy chia nhỏ bài toán và chain-of-thought, cho model tự phê bình câu trả lời của mình, ghép nhiều lần chạy (ensembling), và chỉ ra những lỗi hay gặp.
Bài “Launch an LLM App in One Hour” giới thiệu bộ công cụ cho giai đoạn thử nghiệm và khám phá: ChatGPT, LangChain, Colab. Cả ba đều là lựa chọn của năm 2023, nên hãy coi chúng là ví dụ, đừng coi là khuyến nghị.
Giá trị bền hơn nằm ở hai phần tiếp theo. Bài Augmented Language Models dạy retrieval bằng vector index và cách quản lý embedding, sau đó là tool use.
Phần hướng dẫn dự án askFSDL làm trọn một ứng dụng theo kiểu production: thiết lập tooling cho dự án Python, ETL dữ liệu, triển khai trên Modal, giám sát bằng Gantry.
Tên nhà cung cấp có thể thay đổi, nhưng các bước thì vẫn vậy.
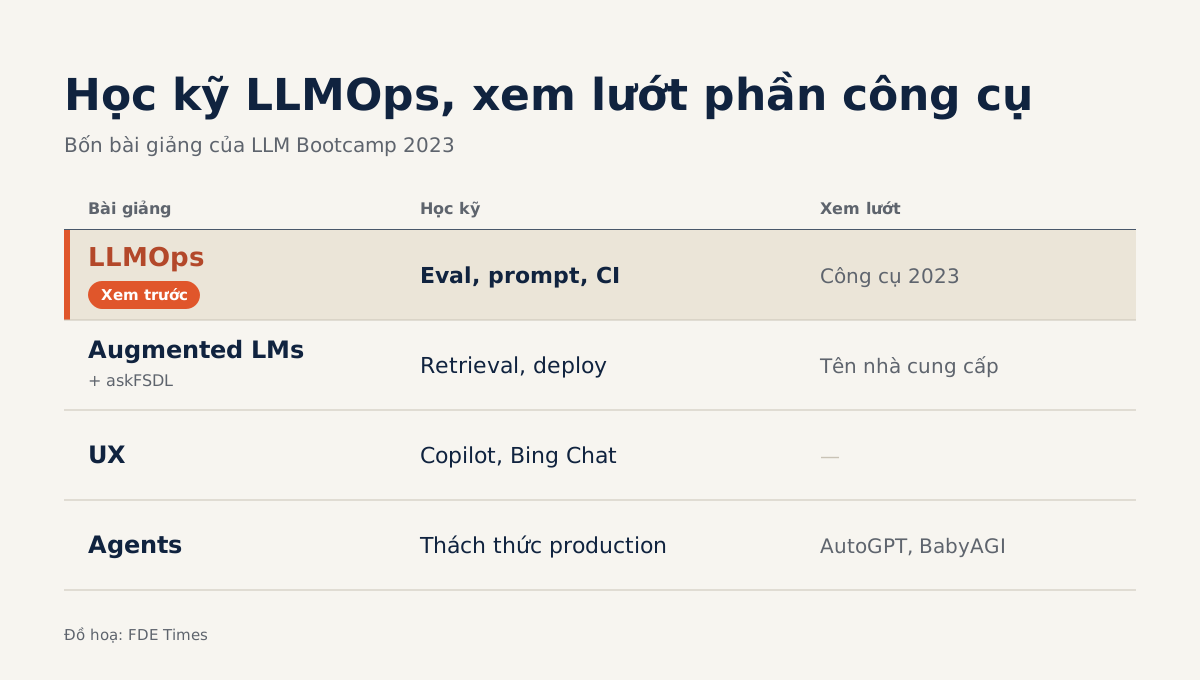
| Bài giảng | Nên học kỹ | Xem lướt |
|---|---|---|
| LLMOps | Eval, quản lý prompt, TDD và CI | Khảo sát công cụ năm 2023 |
| Augmented LMs, askFSDL | Retrieval, ETL, deploy, giám sát | Tên nhà cung cấp cụ thể |
| UX | Case study Copilot và Bing Chat | — |
| Agents (khách mời) | Danh sách thách thức khi chạy production | AutoGPT, BabyAGI |
Riêng bài khách mời về agent nhắc tới AutoGPT và BabyAGI, nay đều đã cũ. Dù vậy, danh sách thách thức trong bài vẫn đúng: kiểm soát việc gọi tool, parse output, xử lý context dài.
Ý thứ nhất: dữ liệu production luôn khác dữ liệu test
Tobin giải thích vì sao kiểm thử LLM khó: phân phối dữ liệu trên production luôn khác dữ liệu lúc huấn luyện. Thử hình dung bạn làm hệ thống hỏi đáp tài liệu nội bộ cho một công ty logistics. Đội dự án tự viết 30 câu hỏi mẫu bằng câu đầy đủ, rõ ràng, và hệ thống trả lời đúng gần hết.
Đến tuần đầu chạy thật, nhân viên kho gõ kiểu “lô HN trễ sao”, trộn viết tắt với mã nội bộ. Bộ test 30 câu không chứa câu nào như thế, nên điểm cao trên bộ test không nói được gì về chất lượng thật. Việc nên làm đầu tiên ở khách hàng là ghi log câu hỏi thật từ ngày đầu, rồi đưa chúng vào bộ eval mỗi tuần.
Ý thứ hai: prompt là code
Bài LLMOps áp dụng test-driven development và continuous integration cho LLM. Thử hình dung prompt nằm trong file prompts/tra_loi_v3.txt. Mỗi lần sửa một câu chỉ dẫn là một commit, và CI chạy lại bộ eval ở trên. Nếu tỉ lệ đúng giảm, bạn biết chính xác dòng nào gây ra lỗi và có thể quay lại phiên bản cũ.
Tobin cũng nhận xét mảng production cho LLM khi đó còn non, và lời khuyên của ông cho việc theo dõi prompt vẫn là Git. Lý do khiến lựa chọn này đáng giữ: nó không đòi hỏi gì thêm ngoài quy trình mà đội đã có sẵn, nên bạn có thể bắt đầu ngay trong tuần đầu của dự án.
Ý thứ ba: giao diện ngôn ngữ là một phần của sản phẩm
Bài UX bàn về cách thiết kế giao diện ngôn ngữ, lấy GitHub Copilot và Bing Chat làm case study. Đây là phần các kỹ sư backend hay bỏ qua, nhưng FDE thì không nên bỏ, vì chính bạn sẽ ngồi cạnh người dùng khi model trả lời sai.
Trước buổi demo tiếp theo, hãy phác ra màn hình người dùng sẽ thấy khi câu trả lời sai, và cách họ báo lại lỗi đó.
Ai nên học, theo thứ tự nào?
Nếu bạn là kỹ sư phần mềm muốn chuyển sang làm FDE, hãy xem LLMOps trước, rồi tới Augmented LMs và askFSDL, sau đó là UX. Prompt engineering và bài “một giờ” chỉ cần xem lướt nếu bạn đã từng gọi API của một LLM.
Thứ tự này đặt phần khó nhất của nghề, tức làm cho hệ thống chạy đúng với dữ liệu thật, lên trước phần dễ gây hứng thú.
Về hồ sơ xin việc, đừng chỉ ghi “đã học LLM Bootcamp”. Hãy làm một dự án nhỏ có retrieval, có bộ eval lấy từ câu hỏi thật và có CI chạy eval khi prompt thay đổi, rồi mô tả đúng ba thứ đó trong CV.
Khi đọc mô tả công việc FDE, hãy để ý các từ “evaluation” và “production”: đó là những phần khoá học này dạy tốt nhất.
Các công cụ trong khoá học sẽ còn tiếp tục cũ đi. Thói quen đo hệ thống bằng dữ liệu thật thì không cũ, và đó là điều đáng học nhất từ khoá này.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
3 nguồn
- LLM Bootcamp - Spring 2023 - The Full Stack · 2023
- Free Full Stack LLM Bootcamp (KDnuggets) · 2023-06-14
- LLMOps (The Full Stack) · 2023-05-09