Khoá Finetuning LLM của Sharon Zhou: 95 phút học cách quyết định khi nào nên fine-tune
Bài dài nhất của khoá học là phần huấn luyện, nhưng thứ một FDE cần mang về là gần 30 phút đầu giải thích vì sao và khi nào nên fine-tune.

Tóm tắt nhanh
- Khoá dài khoảng 1 giờ 35 phút, trình độ trung cấp, do Sharon Zhou dạy, gồm 9 video, 6 ví dụ code và 1 bài quiz.
- Khoá dạy fine-tune khác prompt engineering ở đâu và khi nào dùng cách nào; tài liệu của OpenAI thì nói thẳng rằng nhiều khi chỉ prompt là đủ.
- Fine-tune đáng làm khi cần định dạng ổn định, muốn chuyển sang mô hình nhỏ rẻ hơn hoặc muốn cắt token trên quy mô lớn.
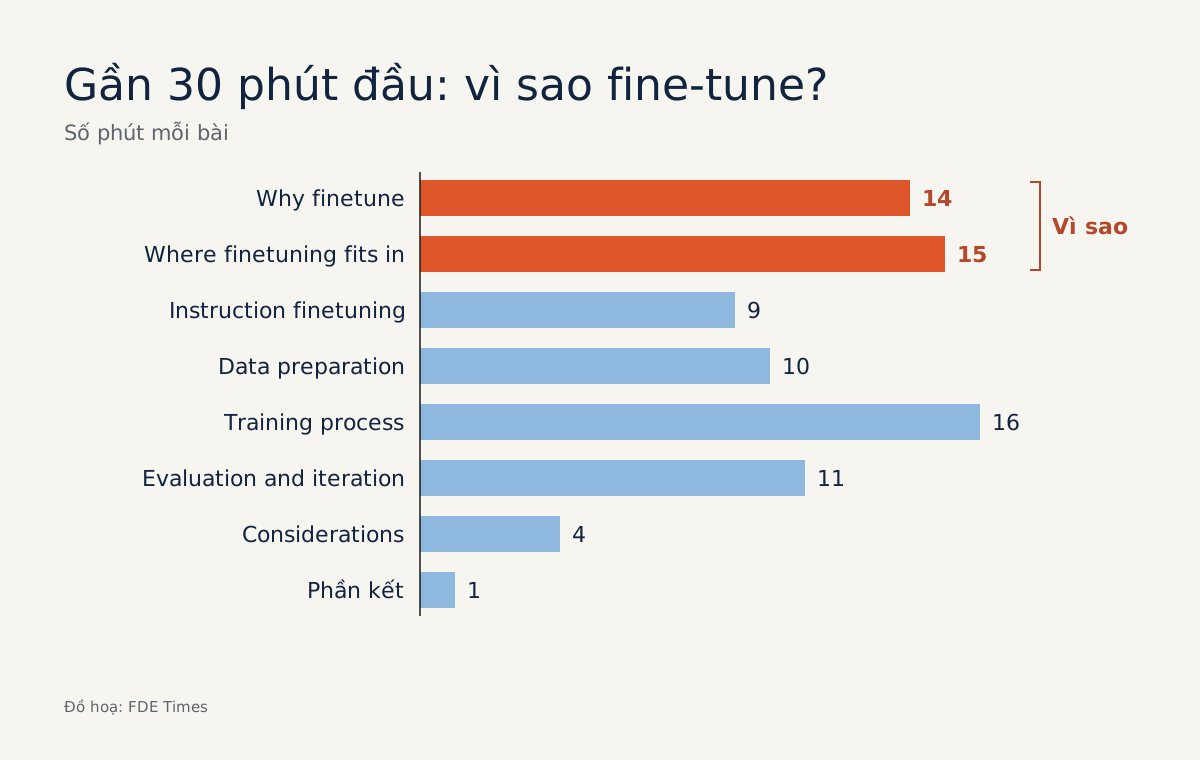
Bạn có thể nghĩ một khoá fine-tuning sẽ đưa code huấn luyện ra ngay từ đầu. Khoá Finetuning Large Language Models của DeepLearning.AI lại dành gần 30 phút cho hai bài “Why finetune” và “Where finetuning fits in”, trước khi động đến bước train nào. Tổng thời lượng của cả khoá chỉ khoảng 1 giờ 35 phút.
Thứ tự ấy có lý do. Hãy hình dung khách hàng không hỏi bạn “fine-tune thế nào” mà hỏi “có nên fine-tune không”. Trả lời sai câu thứ hai, đội của bạn có thể mất vài tuần cho một việc mà một prompt tốt đã giải quyết được.
Ai dạy, và khoá có những gì?
Giảng viên là Sharon Zhou, hiện là Vice President of AI tại AMD. Năm 2023, khi khoá học ra đời, bà là đồng sáng lập kiêm CEO của Lamini, và khoá được làm cùng Lamini.
Đây là một short course trình độ trung cấp, gồm 9 video, 6 ví dụ code và 1 bài quiz có chấm điểm; vài trang liệt kê thời lượng ngắn hơn một chút, 1 giờ 25 phút.
Sau phần giới thiệu, khoá đi theo đúng trình tự của một dự án thật: Why finetune (khoảng 14 phút), Where finetuning fits in (15), Instruction finetuning (9), Data preparation (10), Training process (16), Evaluation and iteration (11), Considerations for getting started (4) và phần kết (1). Người học cần biết Python và hiểu một framework deep learning như PyTorch.
Trang khoá học cho biết khoá đang miễn phí trong một thời gian giới hạn khi nền tảng học mới còn ở bản beta, nên bạn nên kiểm tra lại điều kiện truy cập trên trang chính thức.
Ý thứ nhất: fine-tune dạy cách trả lời trước khi dạy thêm kiến thức
Theo mô tả chính thức, fine-tuning giúp mô hình học phong cách và định dạng, đồng thời có thể cập nhật kiến thức mới. Một trong các mục tiêu của khoá là giúp người học hiểu fine-tune khác prompt engineering ở đâu, khi nào dùng cách nào và khi nào dùng cả hai.
Hướng dẫn tối ưu mô hình của OpenAI nói rõ hơn nữa: prompt engineering có thể đã đủ để đạt kết quả tốt cho use case của bạn, còn fine-tune thì tốn thời gian.
Vì vậy, nếu khách hàng phàn nàn rằng mô hình “trả lời sai giọng” hoặc “lệch format”, việc đầu tiên nên làm là viết lại prompt và thêm ví dụ. Chưa cần đến GPU.
Ý thứ hai: fine-tune là một bài toán chi phí
OpenAI nêu hai trường hợp fine-tune có lợi rõ ràng. Một là khi đầu ra phải nhất quán về định dạng. Hai là khi bạn muốn một mô hình nhỏ hơn, rẻ hơn, nhanh hơn làm thật tốt một việc mà dùng mô hình lớn thì không kinh tế.
Mô hình đã fine-tune cũng cần prompt ngắn hơn, ít ví dụ và ít ngữ cảnh hơn, nên tiết kiệm token khi chạy ở quy mô lớn.
Anthropic, khi mở fine-tune cho Claude 3 Haiku vào tháng 7/2024, cũng đưa ra cùng một động lực: giảm chi phí production bằng cách dùng Haiku thay cho Sonnet hoặc Opus, và huấn luyện mô hình cho những workflow rất đặc thù của doanh nghiệp.
Thử làm một phép tính giả định. Một hệ thống phân loại ticket nhét khoảng 2.000 token ví dụ vào mỗi prompt và nhận 100.000 lượt gọi mỗi ngày. Riêng phần ví dụ đã chiếm 200 triệu token mỗi ngày.
Giờ giả sử sau khi fine-tune, mỗi prompt chỉ cần giữ lại khoảng 200 token ví dụ. Phần ví dụ khi đó còn 20 triệu token mỗi ngày, tức bớt 180 triệu token, giảm 90%. Đặt khoản tiết kiệm ấy cạnh công sức chuẩn bị dữ liệu, huấn luyện và đánh giá lại, bạn sẽ có một con số cụ thể để mang vào buổi họp với khách hàng.
Ý thứ ba: dữ liệu và đánh giá quan trọng hơn bước train
Nếu cộng thời lượng các bài, Data preparation và Evaluation and iteration dài hơn phần Training process. Cách chia thời gian này phản ánh đúng công việc ngoài thực tế. Thời gian huấn luyện có thể mua bằng tiền, còn một tập dữ liệu sạch và một thước đo mà khách hàng đồng ý thì phải tự xây ở chỗ khách hàng.
Lời khuyên thực tế là dựng tập đánh giá ngay trong tuần đầu, khi bạn vẫn đang chạy bằng prompt. Khi đó, nếu cần fine-tune, bạn đã có sẵn một mốc để so sánh. Nếu không cần, tập đánh giá ấy vẫn là thứ đáng giá nhất bạn để lại cho khách hàng.
Những lỗi nào khiến dự án fine-tune đi lạc?
Lỗi phổ biến nhất là fine-tune để chữa một prompt viết dở. Nếu prompt thiếu chỉ dẫn rõ ràng hay thiếu ví dụ, huấn luyện thêm chỉ che đi vấn đề và tốn thời gian hơn nhiều so với việc ngồi sửa prompt.
Lỗi thứ hai là train khi chưa có mốc đánh giá. Không có tập đánh giá chạy trên phiên bản dùng prompt, bạn không chứng minh được mô hình mới tốt hơn, và khách hàng chỉ còn cảm giác để quyết định.
Lỗi thứ ba là quên tính lại chi phí sau khi train. Nếu lý do fine-tune là cắt token hay chuyển sang mô hình nhỏ hơn, hãy đặt con số trước và sau cạnh nhau; khoản tiết kiệm không đáng kể thì prompt vẫn là lựa chọn đúng.
Nên học thế nào, và ghi gì vào CV?
Khoá này phù hợp nhất với người đã từng đưa ít nhất một ứng dụng LLM chạy bằng prompt vào sử dụng thật. Hãy xem hai bài đầu trước, đọc song song hướng dẫn của OpenAI, rồi mới mở notebook huấn luyện. Nếu bạn chưa quen PyTorch, nên bổ sung phần đó trước, vì đó là điều kiện tiên quyết mà khoá nêu rõ.
Khi đọc JD của các vị trí FDE, hãy để ý những cụm như “fine-tuning”, “evaluation” hay “cost optimization”. Trên CV, một dòng kiểu “so sánh prompt và fine-tune trên tập đánh giá tự xây, chọn phương án rẻ hơn mà vẫn đạt chất lượng” có sức nặng hơn nhiều so với một dòng chỉ ghi “đã fine-tune mô hình”.
Đến cuối khoá, bạn sẽ biết cách fine-tune. Nhưng điều có ích hơn khi làm việc với khách hàng là bạn có thể giải thích bằng con số vì sao nên fine-tune, hoặc vì sao chưa cần.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!