Hands-On Machine Learning của Aurélien Géron: FDE nên bắt đầu từ chương 2
Trong 19 notebook đi kèm sách, notebook thứ hai dạy một thói quen giữ cho con số bạn báo cáo với khách đứng vững: khóa test set trước khi để nó ảnh hưởng tới bất kỳ quyết định nào.
Tóm tắt nhanh
- Hãy dùng ấn bản thứ ba và repo ageron/handson-ml3, nơi có code ví dụ và lời giải bài tập của từng chương.
- Chương 2 dạy cách tách test set đúng: đặt seed, chia trước khi tiền xử lý, không bao giờ fit trên test data.
- Dữ liệu có yếu tố thời gian thì phải train trên quá khứ, test trên tương lai, nếu không điểm số sẽ bị thổi phồng.
Cuốn sách này có tất cả 19 notebook, và notebook thứ hai mang cái tên khô khan nhất: end_to_end_machine_learning_project. Bên cạnh toàn bộ code mẫu và lời giải bài tập của chương, nó có một mục tên “Create a Test Set” và một dòng đặt random seed để mỗi lần chạy lại đều ra đúng kết quả cũ.
Với một Forward Deployed Engineer, đây lại là chương nên đọc đầu tiên. Ở chỗ khách hàng, tuần đầu hiếm khi bắt đầu bằng việc chọn kiến trúc model. Nó bắt đầu bằng một file dữ liệu và một con số đánh giá mà sớm muộn bạn sẽ phải đứng ra bảo vệ.
Chương 2 dạy bạn làm cho con số đó đứng vững.
Sách nào, repo nào?
Sách là Hands-on Machine Learning with Scikit-Learn, Keras and TensorFlow của Aurélien Géron, do O’Reilly xuất bản, nay ở ấn bản thứ ba. Trang hướng dẫn tài nguyên của thư viện Đại học Washington and Lee cũng đưa cuốn này vào danh sách sách machine learning nên đọc.
Nên học bằng repo chính thức ageron/handson-ml3 trên GitHub. Theo lời tác giả, repo chứa code ví dụ và lời giải bài tập của ấn bản thứ ba, và mục tiêu là dạy nền tảng machine learning bằng Python.
Notebook chương 2 có toàn bộ code mẫu và lời giải của chương. Vì vậy bạn học bằng cách chạy từng cell, không phải đọc từ đầu đến cuối như đọc tiểu thuyết.
Vì sao test set là chuyện của FDE?
Tài liệu chính thức của scikit-learn gọi việc giữ riêng một phần dữ liệu làm test set là thông lệ phổ biến khi làm thí nghiệm học có giám sát. Đi kèm là một quy tắc rất ngắn: không bao giờ dùng test data để ra quyết định về model, và không bao giờ gọi fit trên test data.
Nghe thì hiển nhiên. Nhưng chính lúc khách hối thúc mới là lúc quy tắc này dễ bị bỏ qua nhất.
scikit-learn gọi hậu quả của việc đó là data leakage: model được xây bằng thông tin mà lúc dự đoán thật sẽ không có. Khi đó con số đánh giá rất đẹp, còn model chạy thật thì không được như vậy.
Một công ty giao hàng, 50.000 đơn
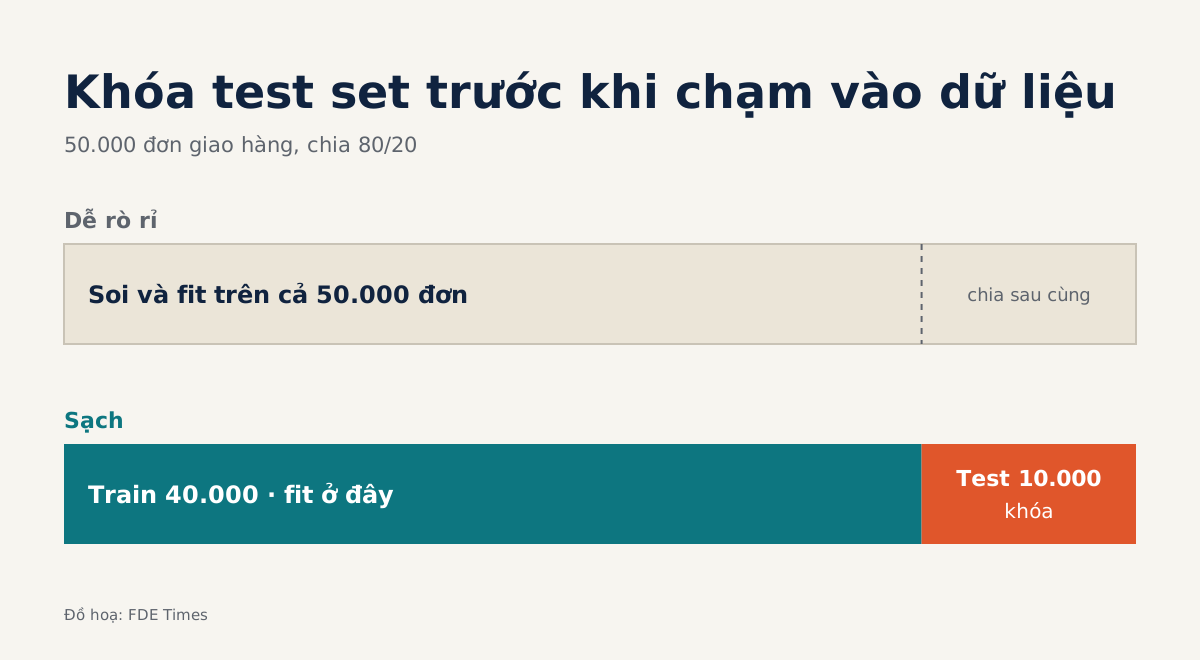
Thử hình dung một công ty giao hàng đưa bạn 50.000 đơn và nhờ dự đoán đơn nào sẽ trễ. Cách dễ rò rỉ là soi hết 50.000 dòng, chọn feature theo những gì vừa thấy, chuẩn hóa trên toàn bộ dữ liệu, rồi mới chia 80/20.
Cả hai lỗi đều phạm đúng quy tắc của scikit-learn. Chọn feature sau khi đã soi 10.000 dòng test là dùng test data để ra quyết định về model; chuẩn hóa trên toàn bộ dữ liệu là gọi fit trên test data.
Suy ra từ quy tắc đó, cách an toàn là chia trước khi tiền xử lý, và tốt nhất trước cả khi bắt đầu soi dữ liệu để chọn feature.
Nếu bỏ qua, bạn đem con số đẹp đi trình bày, rồi tuần sau model chạy trên đơn mới thì kém hẳn. Người đã đứng ra ủng hộ dự án bên phía khách hàng sẽ là người mất mặt đầu tiên.
Cách sạch là chia ngay từ đầu, khóa 10.000 dòng test lại, và chỉ fit các bước tiền xử lý trên 40.000 dòng train. Hãy đặt random seed giống như notebook làm, để đồng nghiệp chạy lại vẫn ra đúng phép chia đó.
Notebook chương 2 tạo test set bằng stratified split và nhận xét rằng làm một lần chia như vậy bằng scikit-learn ngắn gọn hơn nhiều. Giả sử 5% số đơn bị trễ, tức 2.500 đơn. Stratified split giữ tỷ lệ 5% ở cả hai phía, nên test set sẽ có khoảng 500 đơn trễ, không bị lệch vì may rủi.
Nhưng đơn hàng có ngày tháng. scikit-learn cảnh báo rằng xáo trộn dữ liệu có thứ tự thời gian dễ cho ra một model overfit và điểm validation bị thổi phồng. Công cụ TimeSeriesSplit làm ngược lại: train trên quá khứ, test trên tương lai, và tập train lớn dần theo thời gian.
Với công ty giao hàng, lấy tháng gần nhất làm test thường trung thực hơn. Nên chốt chuyện này cùng khách, vì chỉ họ biết model sẽ được dùng vào lúc nào và cho việc gì.
Ai nên đọc, và đọc theo thứ tự nào?
Nếu bạn là software engineer muốn chuyển sang FDE nhưng chưa từng làm ML, hãy bắt đầu từ chương 2. Chạy notebook, tự làm bài tập rồi mới mở lời giải. Các phần về Keras và TensorFlow có thể để đến khi có khách thật sự cần.
Nếu bạn đã là ML engineer, hãy lướt chương 2 như một checklist. Vấn đề không nằm ở chỗ bạn đã biết các bước hay chưa. Vấn đề là khi bị khách hối thúc, bạn có làm đủ các bước đó không.
Ba ý nào đáng giữ lại?
Ý đầu tiên là phép chia phải lặp lại được: có seed thì ai chạy lại cũng ra cùng con số. Ý tiếp theo là chia trước khi tiền xử lý, không để test data chi phối quyết định nào và không bao giờ fit trên test.
Ý cuối cùng là cách chia phải hợp với dữ liệu: stratified khi có nhóm hiếm, chia theo thời gian khi model dự đoán tương lai.
Muốn tự kiểm tra, trước khi chạy cell tạo test set, hãy viết một câu giải thích vì sao bạn chia như vậy. Nếu câu đó vẫn đúng khi thay dữ liệu trong sách bằng 50.000 đơn hàng ở trên, bạn đã hiểu chương 2.
Nếu đang chuẩn bị ứng tuyển FDE, hãy làm lại chương 2 trên một bộ dữ liệu công khai thuộc ngành bạn nhắm tới rồi đưa lên GitHub. Khi JD nhắc đến “end-to-end” hay “model evaluation”, một README ghi rõ bạn chia test set thế nào và vì sao là bằng chứng cụ thể hơn mọi dòng tự giới thiệu.
Mạng neural là thứ làm khách hàng chú ý. Còn thứ giữ được lòng tin của họ là một test set mà bạn chưa từng chạm vào.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Machine Learning Notebooks, 3rd edition (ageron/handson-ml3 README)
- Machine Learning Notebooks, 3rd edition (ageron/handson-ml3 README)
- 02_end_to_end_machine_learning_project.ipynb (ageron/handson-ml3)
- Additional Resources – GenAI (W&L LibGuides)
- Cross-validation: evaluating estimator performance (scikit-learn docs)
- Common pitfalls and recommended practices (scikit-learn docs)