CS 329S của Chip Huyen: khóa Stanford về đánh giá và giám sát hệ thống ML chạy thật
65% điểm của khóa dành cho việc xây một ứng dụng ML thật, nhưng phần đáng học nhất cho FDE nằm ở các buổi về đánh giá, monitoring và distribution shift.

Tóm tắt nhanh
- CS 329S do Chip Huyen dạy ở Stanford có buổi riêng cho chẩn đoán lỗi, distribution shift và monitoring, kèm tutorial dùng WhyLogs và Evidently
- Bài giảng đã được mở rộng thành sách Designing Machine Learning Systems (O'Reilly, 2022), cách dễ nhất để theo nội dung khóa
- Ý đáng giữ nhất: phát hiện thay đổi thì dễ, biết thay đổi nào cần xử lý mới là kỹ năng thật
Ở khóa CS 329S của Stanford, 65% điểm không đến từ bài thi. Nó đến từ một dự án cuối khóa: xây một ứng dụng ML thật rồi trình bày ở buổi demo day. Cách chấm điểm này cho thấy khóa học coi trọng điều gì.
Khóa học tên đầy đủ là Machine Learning Systems Design, do Chip Huyen giảng dạy. Trang khóa học ghi đây là lần thứ hai khóa được mở.
Lịch học từ 3/1 đến 9/3 và địa chỉ email của ban giảng dạy năm 2022 cho thấy đây là đợt mùa đông 2022. Mục tiêu được nêu rõ: đưa ra một framework lặp để phát triển hệ thống ML chạy trong thế giới thật.
Nếu bạn là FDE hoặc sắp thành FDE, chữ “lặp” là chữ quan trọng nhất. Lý do nằm ngay trong mô tả khóa: phân phối dữ liệu liên tục dịch chuyển, nên một model chạy tốt lúc bàn giao chưa chắc còn tốt khi dữ liệu của khách thay đổi.
Khóa học dạy phần việc sau ngày bàn giao
Đề cương của CS 329S dành riêng các buổi cho offline evaluation và model evaluation. Buổi model evaluation có tutorial về RecList. Sau đó có một buổi về chẩn đoán lỗi hệ thống ML, distribution shift và monitoring, theo sau là một tutorial monitoring dùng WhyLogs và Evidently. Monitoring trong production vì thế có hẳn một buổi học, thay vì chỉ là vài dòng ghi chú cuối chương.
Đề cương còn có buổi “ML beyond accuracy”, bàn về fairness, security và governance. Buổi kết thúc khóa nói về giá trị kinh doanh của AI, phần sát nhất với những gì FDE phải trình bày trước khách. Thứ tự này khá giống một engagement thật: đo được, vận hành được, rồi mới chứng minh được giá trị.
Hệ thống ML là một vòng lặp
Trang khóa học nói khóa dạy cách liên tục giám sát và deploy thay đổi cho hệ thống ML, vì phân phối dữ liệu không đứng yên. Repo chính thức của cuốn sách đi kèm mô tả mục tiêu là hệ thống reliable, scalable, maintainable và thích ứng được khi môi trường và yêu cầu kinh doanh thay đổi.
Trang sách của Chip Huyen cụ thể hơn nữa: chọn dữ liệu huấn luyện thế nào, retrain thường xuyên đến đâu, giám sát cái gì đều ảnh hưởng đến toàn bộ hệ thống.
Với FDE, đây là những câu hỏi nên trả lời ngay trong kế hoạch triển khai, chứ không phải sau sự cố đầu tiên. Khi viết scope với khách, hãy có một mục riêng cho tần suất retrain và người chịu trách nhiệm theo dõi.
Đo offline trước để khách không phải đo hộ bạn
Khóa học tách offline evaluation thành một buổi riêng, và lý do khá dễ hiểu: một con số duy nhất trên tập test hiếm khi đủ để khách tin model. Thử hình dung bạn sắp bàn giao một model gợi ý sản phẩm cho một chuỗi bán lẻ. Điểm tổng thể trên tập test trông ổn.
Trước khi bàn giao, bạn chia tập test theo từng nhóm khách hàng và chấm lại. Kết quả có thể lộ ra rằng nhóm khách hàng mới, đúng nhóm bộ phận marketing quan tâm nhất, nhận gợi ý tệ hơn hẳn. Phát hiện chuyện đó ở bước offline rẻ hơn nhiều so với để khách tự thấy sau khi model đã chạy.
Tutorial RecList trong buổi model evaluation là chỗ để tập thói quen đánh giá theo lát cắt như vậy. Buổi “ML beyond accuracy” bổ sung phần còn lại: các câu hỏi về fairness, security và governance mà team pháp lý của khách thế nào cũng sẽ hỏi.
Phát hiện thay đổi thì dễ, chọn thay đổi nào để xử lý mới khó
Đây là ý đáng giữ nhất. Trong bài viết về real-time machine learning đăng ngày 2/1/2022, Chip Huyen viết rằng vấn đề không phải là phát hiện những thay đổi, mà là biết thay đổi nào thực sự cần bạn chú ý. Cũng bài viết đó gắn việc retrain với distribution shift đã được phát hiện.
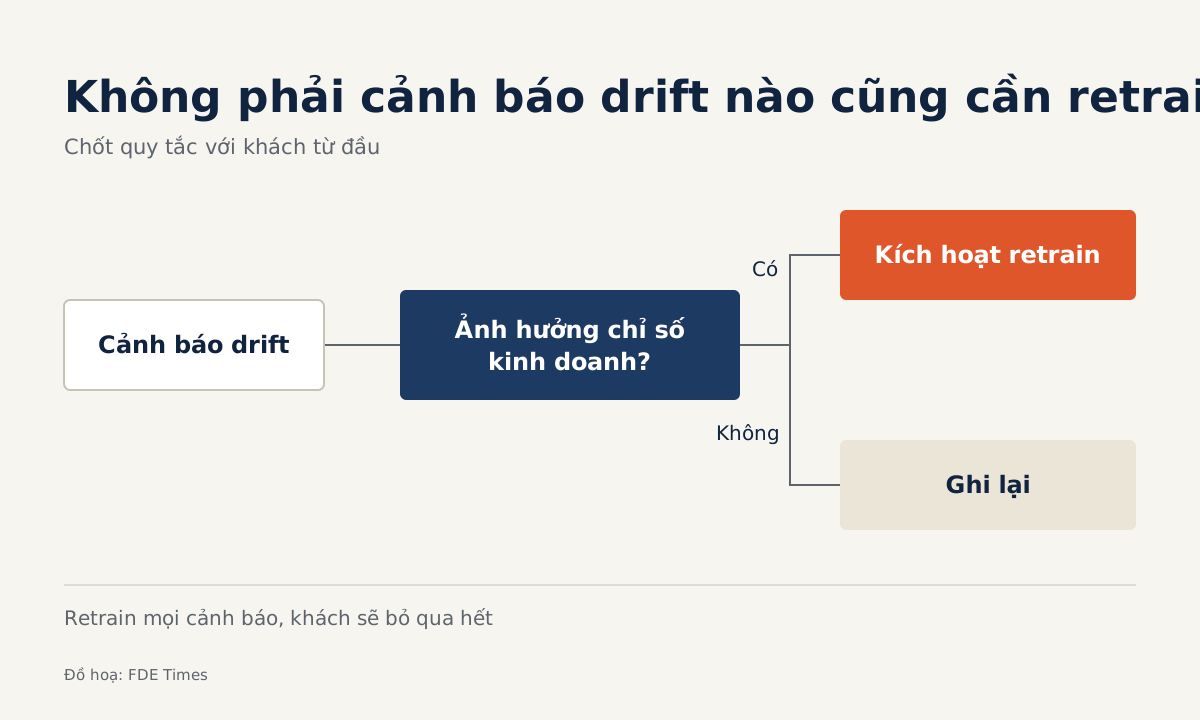
Thử hình dung Evidently báo drift trên hàng chục feature sau một đợt khuyến mãi của khách. Nếu bạn retrain mỗi khi có cảnh báo, team của khách sẽ sớm bỏ qua mọi cảnh báo. Cách tốt hơn là thống nhất với khách từ đầu: thay đổi nào ảnh hưởng đến chỉ số kinh doanh thì kích hoạt retrain, thay đổi nào chỉ cần ghi lại.
Học theo thứ tự nào?
Bài giảng của khóa đã được mở rộng thành cuốn Designing Machine Learning Systems (O’Reilly, 2022). Vì vậy nên đọc sách trước để nắm toàn bộ nội dung. Sau đó mở syllabus ở stanford-cs329s.github.io, làm tutorial RecList của buổi model evaluation, rồi mới đến tutorial monitoring với WhyLogs và Evidently.
Bước cuối là tự làm một dự án giống dự án cuối khóa, phần chiếm 65% điểm. Hãy xây một ứng dụng ML nhỏ, deploy nó, gắn monitoring, rồi demo cho người khác xem. Nếu công việc bạn nhắm tới là đưa model vào dữ liệu thật của khách, đây là khóa đáng dành thời gian.
Khi tự làm, có hai lỗi rất dễ mắc. Lỗi đầu là chỉ báo cáo một con số tổng, đúng cái bẫy mà ví dụ bán lẻ ở trên cho thấy. Lỗi thứ hai là nối thẳng cảnh báo drift vào lệnh retrain, khiến hệ thống retrain liên tục mà không ai biết vì sao.
Khi đưa dự án vào CV, đừng chỉ ghi “xây model đạt X%”. Hãy ghi bạn đánh giá model theo những lát cắt nào, giám sát drift bằng công cụ gì, và quy tắc nào quyết định retrain. Những dòng đó cho thấy bạn đã vận hành một hệ thống, chứ không chỉ huấn luyện một model.
Một model có độ chính xác cao chỉ chứng minh được ngày đầu tiên. Đề cương CS 329S dành hẳn các buổi riêng cho những gì xảy ra sau đó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!