Quality and Safety for LLM Applications: bốn bài về rủi ro LLM, học kèm công cụ để đo chúng
Bài dài nhất trong khoá ngắn của DeepLearning.AI và WhyLabs là bài giám sát. Học kèm SelfCheckGPT và LangKit, bạn có thể trả lời khách hàng bằng con số thay vì lời trấn an.

Tóm tắt nhanh
- Bernease Herman, Data Scientist ở WhyLabs, dạy khoá này trên DeepLearning.AI. Khoá dài 2 giờ 16 phút, có bốn bài chính và một bài quiz chấm điểm.
- Học kèm công cụ thì mỗi rủi ro đều có con số: SelfCheckGPT đo độ tự mâu thuẫn để bắt ảo giác, LangKit chấm điểm prompt injection và đếm số lần khớp regex để bắt rò dữ liệu.
- Bài dài nhất là bài giám sát. Kiểm thử một lần trước khi ra mắt là chưa đủ, tỷ lệ vi phạm phải được theo dõi liên tục.
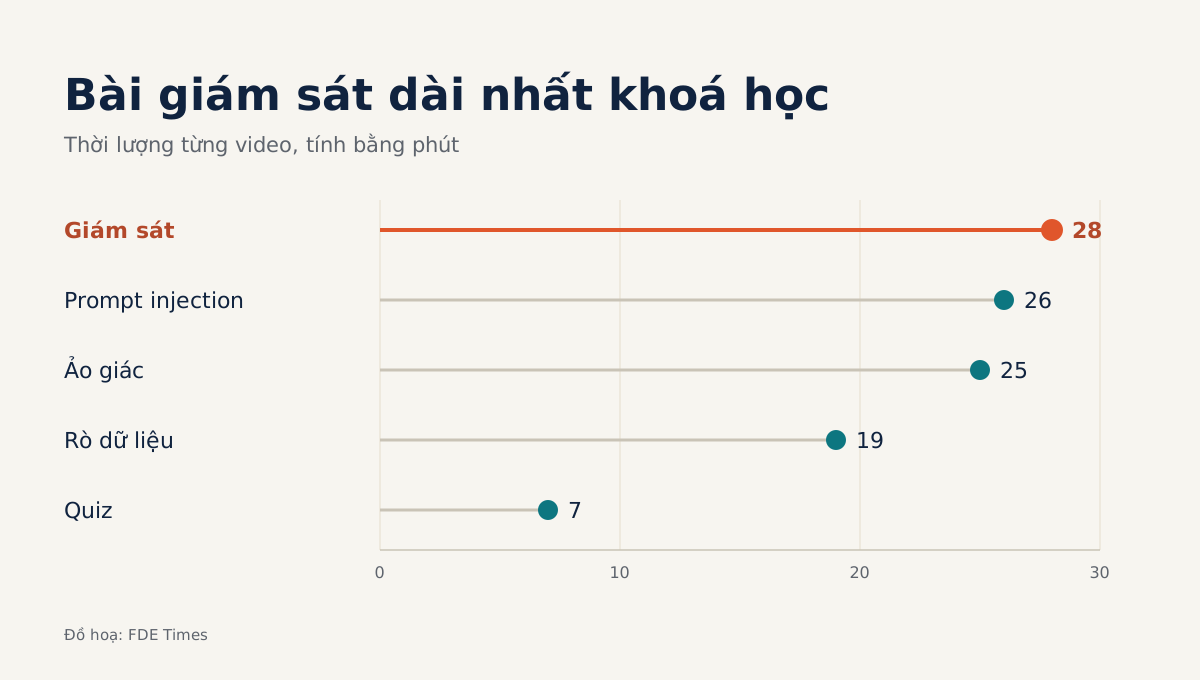
Bài dài nhất trong khoá Quality and Safety for LLM Applications không nói về ảo giác hay jailbreak. Đó là bài “Passive and active monitoring”, dài 28 phút, hơn mọi bài khác. Riêng thời lượng ấy đã gợi ý một quan điểm: an toàn của ứng dụng LLM phải được theo dõi liên tục, không phải kiểm thử một lần là xong.
Với một FDE, đây là chuyện hằng ngày. Bản demo chạy trơn tru trên dữ liệu mẫu. Đến tuần đầu đưa dữ liệu thật của khách hàng vào, sẽ có người hỏi: “Làm sao biết nó không bịa?” Câu trả lời tốt nhất không phải lời trấn an mà là một con số.
Ai dạy, và bốn bài học gồm những gì?
Khoá nằm trong loạt khoá ngắn của DeepLearning.AI, làm cùng WhyLabs. Người giảng là Bernease Herman, Data Scientist ở WhyLabs. Công ty này làm ra LangKit, bộ công cụ mã nguồn mở tính chỉ số văn bản từ đầu vào và đầu ra của mô hình ngôn ngữ để giám sát.
Khoá ở trình độ beginner, dài 2 giờ 16 phút. Mục tiêu nêu khá cụ thể: phát hiện và ngăn ảo giác, jailbreak và rò dữ liệu, rồi giám sát và cải thiện các lớp bảo vệ theo thời gian.
Phần lõi gồm bốn video: “Hallucinations” 25 phút, “Data Leakage” 19 phút, “Refusals and prompt injections” 26 phút và bài giám sát 28 phút. Cuối khoá có một bài quiz chấm điểm. Cả khoá học gọn trong một buổi chiều.
Muốn mỗi bài thành kỹ năng dùng được ngay, bạn nên đọc kèm ba thứ: bài báo SelfCheckGPT, mã nguồn LangKit và hướng dẫn về dò PII của Openlayer. Các kỹ thuật đo dưới đây lấy từ chính những tài liệu đó.
Mô hình bịa thì sẽ tự mâu thuẫn
Bài ảo giác nên học cùng SelfCheckGPT, phương pháp Manakul, Liusie và Gales công bố tháng 3/2023. Điểm mạnh của nó là phát hiện ảo giác mà không cần cơ sở dữ liệu đối chiếu bên ngoài. Nó chỉ dựa vào độ nhất quán giữa các câu trả lời được lấy mẫu.
Ý tưởng rất đơn giản. Nếu mô hình thật sự biết một điều, các lần lấy mẫu sẽ cho cùng một câu trả lời. Nếu nó đang bịa, các câu trả lời thường lệch nhau.
Thử hình dung bạn triển khai chatbot nội bộ cho một công ty bảo hiểm. Người dùng hỏi thời hạn nộp hồ sơ bồi thường. Bạn gọi mô hình 5 lần và cả 5 lần đều ra “30 ngày”: câu trả lời này đáng tin hơn.
Còn nếu nhận về 30, 45, 30, 60 và 14 ngày thì đó là dấu hiệu đáng ngờ, dù từng câu riêng lẻ nghe đều rất tự tin.
Ở chỗ khách hàng, bạn hiếm khi có sẵn bộ đáp án chuẩn, nên kỹ thuật này dùng được ngay. Việc nên làm trước tiên: lấy một mẫu nhỏ câu hỏi thật, đo tỷ lệ câu bị lệch, rồi mang con số đó vào buổi họp thay cho cảm giác “có vẻ ổn”.
Prompt injection cũng đo được thành một con số
LangKit chấm điểm rủi ro prompt injection theo độ giống nhau giữa prompt và các kiểu tấn công đã biết. Thế là một rủi ro mơ hồ thành một con số để bạn đặt ngưỡng, ghi log và vẽ biểu đồ.
Vì điểm số dựa trên độ giống với tấn công đã biết, một kiểu tấn công hoàn toàn mới có thể bị chấm điểm thấp. Dù vậy, với khách hàng doanh nghiệp, một bộ lọc đo được vẫn tốt hơn nhiều so với một system prompt dặn mô hình “đừng làm điều xấu”.
Rò dữ liệu bắt đầu từ một biểu thức regex
“Data Leakage” là bài ngắn nhất trong bốn bài lõi, nhưng nó chạm vào nỗi lo lớn nhất của khách hàng khi đưa dữ liệu thật vào hệ thống. Cách đơn giản nhất để biến nỗi lo ấy thành số là đếm.
LangKit có chỉ số patterns, đếm số chuỗi khớp một nhóm regex do bạn tự định nghĩa. Container LangKit của WhyLabs mặc định dò PII như email, số điện thoại, thẻ tín dụng ở cả prompt lẫn câu trả lời.
Quay lại khách hàng bảo hiểm ở trên, giả sử mã hợp đồng của họ có định dạng cố định. Bạn viết regex cho mã đó, thêm email và số điện thoại, rồi chạy qua 1.000 câu trả lời của tuần đầu. Có 3 câu khớp, vậy tỷ lệ rò là 0,3%.
Container của WhyLabs còn cho đặt ngưỡng riêng cho từng chỉ số, để con số đó thành báo cáo đạt hay không đạt.
Regex có điểm mù. Openlayer lưu ý rằng nó bỏ sót PII dạng tự do, như tên người nằm giữa câu văn hay mã định danh bị cắt dở, nên cần ghép thêm bộ dò khác. Red Hat OpenShift AI cũng dùng bộ dò regex trong guardrails cho đầu vào và đầu ra. Regex là lớp bảo vệ đầu tiên, không phải lớp duy nhất.
Vì sao bài giám sát đáng học kỹ nhất?
Người dùng thật luôn khác người viết test. Bộ test viết trong tuần đầu khó lường hết những gì nhân viên của khách hàng sẽ gõ vào ở tháng thứ ba.
Openlayer nhận xét rằng tỷ lệ rò PII thay đổi theo thời gian, và giám sát production là nơi bạn thấy sự thay đổi đó. Vì thế, con số 0,3% kia nên được đo đều đặn mỗi tuần chứ không chỉ một lần.
Còn một ranh giới cần nói rõ với khách hàng. Theo Openlayer, ghi log chỉ là quan sát, chặn ngay lúc suy luận mới là thực thi. Lời khuyên cho FDE: thống nhất từ đầu chỉ số nào chỉ cần cảnh báo, chỉ số nào vượt ngưỡng thì phải chặn câu trả lời.
Ai nên học, và học theo thứ tự nào?
Khoá hợp nhất với kỹ sư đã từng xây một ứng dụng LLM, chẳng hạn một hệ RAG đơn giản, và giờ phải bảo vệ nó trước khách hàng. Nếu bạn chưa từng gọi API mô hình, hãy làm một dự án nhỏ trước để có dữ liệu riêng mà thử các kỹ thuật.
Nên học bài ảo giác trước, rồi đến bài prompt injection và bài rò dữ liệu. Bài giám sát nên để cuối: lúc đó bạn đã tự đo được vài chỉ số từ ba bài trước, nên có thứ cụ thể để giám sát. Hãy làm quiz sau khi đã thử ít nhất một kỹ thuật trên dữ liệu của chính bạn.
Về nghề nghiệp, hãy để ý những tin tuyển FDE nhắc đến evals, guardrails hay monitoring cho LLM. Đừng ghi “đã hoàn thành khoá học” vào CV. Hãy viết điều bạn đã đo, chẳng hạn “theo dõi hằng tuần tỷ lệ rò PII và tỷ lệ câu trả lời tự mâu thuẫn trên chatbot nội bộ”.
Khách hàng sẽ không hỏi bạn đã học khoá nào. Họ sẽ hỏi tuần trước mô hình làm lộ dữ liệu bao nhiêu lần, và FDE giỏi là người trả lời được bằng một con số.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Quality and Safety for LLM Applications - DeepLearning.AI
- Course: quality-safety-llm-applications - DeepLearning.AI Learn
- SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models · 2023-03-15
- whylabs/langkit: An open-source toolkit for monitoring Large Language Models (LLMs)
- WhyLabs documentation: LangKit container integration
- PII Detection in LLM Outputs: AI Team Guide
- Using FMS Guardrails for AI safety - Red Hat OpenShift AI