Building and Evaluating Advanced RAG: khoá học ngắn đáng học vì phần đánh giá
Thứ đáng mang theo từ khoá học của Jerry Liu và Anupam Datta là cách chỉ ra hệ thống RAG đang hỏng ở khâu nào, chứ không phải cách dựng pipeline.

Tóm tắt nhanh
- Khoá dài 2 giờ 5 phút, ở mức Beginner, gồm 6 video và 4 ví dụ code. Phần đáng giữ lại lâu nhất là RAG triad.
- Sentence-window retrieval khớp theo từng câu đơn, rồi gửi cho LLM cả cửa sổ các câu xung quanh. Kích thước cửa sổ phải lấy từ cấu hình thực tế, đừng dựa vào giá trị mặc định.
- Hãy dùng triad để chẩn đoán lỗi, đừng coi nó là lời bảo đảm. Theo benchmark của Snowflake, giám khảo LLM chấm context relevance chỉ đạt F1 64%.
Khoá Building and Evaluating Advanced RAG của DeepLearning.AI chỉ dài 2 giờ 5 phút, gồm 6 video và 4 ví dụ code. Tên khoá đặt “building” lên trước. Nhưng thứ đáng mang theo khi đến làm việc tại chỗ khách hàng lại là phần “evaluating”, tức RAG triad, bộ ba phép đo mà khoá dùng để chấm mức liên quan và độ trung thực của câu trả lời LLM.
Với một FDE, đó là phần nên học kỹ nhất. Dựng một pipeline RAG chạy được chỉ mất một buổi chiều. Cái khó đến khi khách hàng nói “bot trả lời sai”: bạn phải chỉ ra nó sai ở đâu, sai vì sao, và sau khi sửa thì nó đã tốt hơn chưa.
Ai dạy, và khoá dạy những gì?
Hai giảng viên là Jerry Liu của LlamaIndex và Anupam Datta của TruEra/Snowflake. Khoá được làm cùng hai đối tác là LlamaIndex và TruEra. Khoá xếp ở mức Beginner, và có thêm một bài tập chấm điểm dành cho tài khoản PRO.
Trang khoá học chỉ ghi lần cập nhật ngày 7/10/2025, không ghi ngày ra mắt ban đầu. Chi tiết này đáng để ý khi bạn chạy lại notebook. Code được viết trên LlamaIndex, nên hãy đối chiếu tên lớp và tham số với tài liệu hiện hành trước khi mất cả buổi sửa lỗi phiên bản.
Ý thứ nhất: triad là công cụ chẩn đoán lỗi
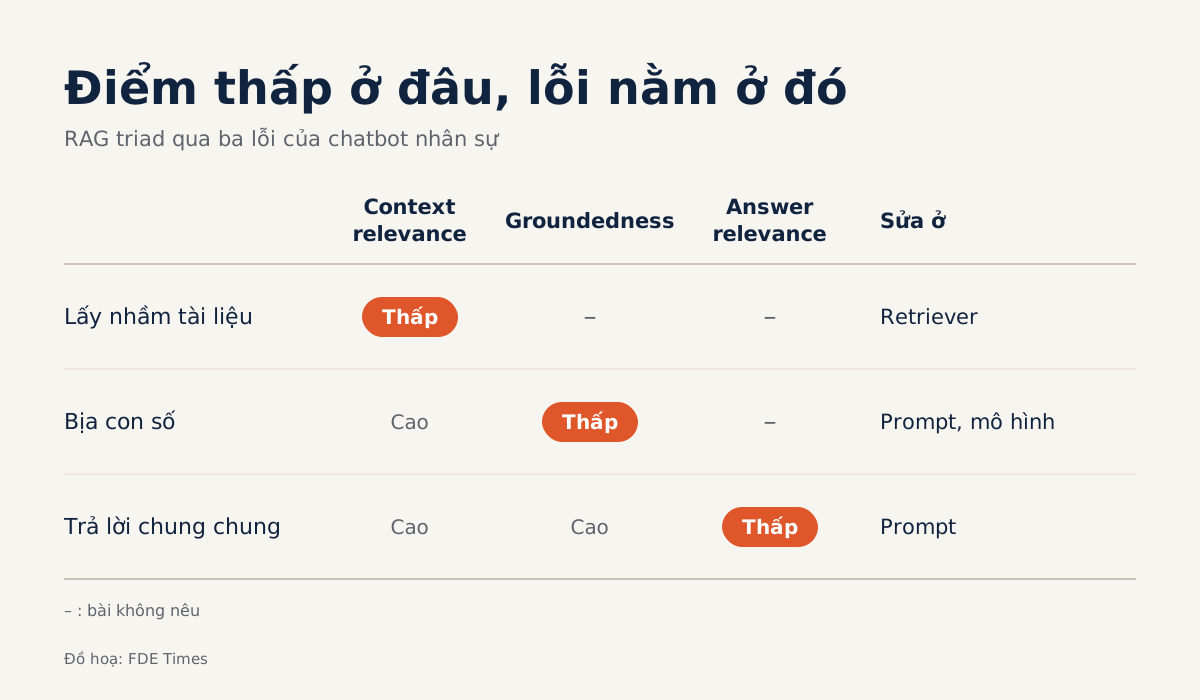
TruLens, thư viện mã nguồn mở của TruEra, thiết kế triad để bắt hallucination trên từng cạnh của kiến trúc RAG. Context relevance kiểm tra từng đoạn ngữ cảnh truy xuất có liên quan tới câu hỏi không. Groundedness đo mức độ các khẳng định của LLM truy ngược được về văn bản nguồn. Answer relevance xem câu trả lời có thực sự hữu ích cho người hỏi không.
Giá trị thật của triad là nó cho biết lỗi nằm ở mắt xích nào. Thử hình dung một chatbot tra cứu chính sách nhân sự, và một nhân viên hỏi mình còn bao nhiêu ngày nghỉ phép. Nếu bot trả lời bằng quy định công tác phí, nhiều khả năng context relevance thấp: retriever đã kéo nhầm tài liệu, và sửa prompt sẽ không giúp gì.
Trường hợp thứ hai: retriever lấy đúng quy định nghỉ phép, nhưng bot đưa ra một con số không có trong tài liệu. Groundedness sẽ thấp, vì mô hình đang khẳng định quá mức hoặc bịa thêm chi tiết so với ngữ cảnh được cung cấp.
Lỗi lúc này nằm ở bước sinh câu trả lời, nên việc cần làm là siết prompt hoặc đổi mô hình, chứ không phải đụng vào retriever.
Trường hợp thứ ba khó nhận ra nhất: ngữ cảnh đúng, mọi khẳng định đều có căn cứ, nhưng bot chỉ diễn giải chung chung quy trình xin nghỉ mà không nói số ngày. Câu trả lời có căn cứ nhưng không giúp được người hỏi, nên answer relevance thấp. Cách sửa là hướng dẫn mô hình trả lời thẳng vào điều được hỏi.
Ba con số này biến lời than “bot dở quá” thành một ticket có địa chỉ cụ thể. Ở buổi làm việc đầu tiên với khách hàng, hãy xin vài câu hỏi bot từng trả lời sai và chấm triad cho từng câu, trước khi chạm vào bất cứ dòng code nào.
Ý thứ hai: truy xuất câu nhỏ, gửi cho LLM đoạn lớn
Sentence-window retrieval giải một mâu thuẫn quen thuộc. Chunk nhỏ thì truy xuất chính xác nhưng thiếu ngữ cảnh. Chunk lớn thì đủ ngữ cảnh nhưng dễ kéo theo nội dung thừa. Theo bài giảng của khoá, kỹ thuật này không chỉ lấy câu liên quan nhất mà lấy cả cửa sổ các câu đứng trước và sau nó.
Trong LlamaIndex, hệ thống khớp theo embedding của từng câu đơn. Sau đó MetadataReplacementNodePostProcessor thay mỗi câu bằng cửa sổ các câu xung quanh trước khi đưa cho LLM. Theo tài liệu, cửa sổ mặc định là 5 câu mỗi bên, nhưng ví dụ code lại đặt window_size=3.
Vì vậy hãy tự tính lượng ngữ cảnh từ cấu hình thực tế. Làm phép tính với mặc định 5 câu mỗi bên: mỗi câu khớp mang vào prompt tối đa 11 câu, và nếu lấy top-3 kết quả thì LLM đọc nhiều nhất 33 câu.
Với window_size=3, các con số đó là 7 và 21; nếu các câu khớp nằm gần nhau, cửa sổ chồng lên nhau và số câu thực tế còn ít hơn. Hãy dùng mức trần tự tính này khi ước tính độ trễ và chi phí token với khách hàng.
Ý thứ ba: điểm cao chưa phải lời bảo đảm
TruLens cho rằng khi cả ba điểm đều cao, bạn có thể tự tin là ứng dụng không hallucination. Nên đọc câu này với một chút hoài nghi, vì có nguồn coi triad là công cụ gỡ lỗi chứ không phải lời bảo đảm. Lý do nằm ở chính người chấm: cả ba chỉ số thường được chấm bằng LLM-as-judge.
Snowflake đã benchmark các giám khảo đó. Giám khảo groundedness đạt F1 81%, answer relevance 79%, còn context relevance chỉ 64%. Mức đồng thuận giữa các giám khảo này và người chấm là từ khá đến cao, nghĩa là vẫn còn những câu bị chấm nhầm, nhất là ở context relevance.
Một bài khác của Snowflake cho thấy muốn cải thiện giám khảo cũng cần dữ liệu chuẩn. Họ tối ưu prompt cho giám khảo bằng Eval-Guided Optimization, và khi không có benchmark dẫn đường thì TextGrad không cải thiện được giám khảo nào.
Bài học cho FDE: trước khi báo cáo điểm triad cho khách hàng, hãy có một bộ câu nhỏ do người chấm tay để biết giám khảo lệch đến đâu.
Nên học theo thứ tự nào?
Khoá ở mức Beginner. Dù vậy, bạn sẽ học được nhiều hơn nếu đã tự dựng một pipeline RAG cơ bản, để khi tới phần triad bạn có sẵn hệ thống của riêng mình để chấm. Xem bài sentence-window trước, rồi đến phần đánh giá, và chạy lại 4 ví dụ code trên tài liệu của chính bạn thay vì dữ liệu mẫu.
Trong CV, đừng chỉ ghi đã hoàn thành khoá học. Hãy viết một dòng có số liệu trước và sau, chẳng hạn bạn đã khoanh được lỗi ở retriever và nâng context relevance trên một bộ câu hỏi thật, và đã kiểm tra điểm của giám khảo bằng một bộ nhãn tự chấm.
Một dòng chứng chỉ chỉ nói bạn đã xem xong khoá học. Một bảng điểm triad đặt cạnh bộ nhãn do chính bạn chấm cho người phỏng vấn thấy bạn biết đo, chứ không chỉ biết dựng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Building and Evaluating Advanced RAG - DeepLearning.AI · 2025-10-07
- sentence window retrieval - DeepLearning.AI
- Metadata Replacement + Node Sentence Window - LlamaIndex
- RAG Triad - TruLens
- RAG triad (PromptLayer glossary)
- What is the RAG Triad? - TruEra
- Benchmarking LLM-as-a-Judge for the RAG Triad Metrics · 2025-01-31
- Eval-Guided Optimization of LLM Judges for the RAG Triad · 2025-02-04