W&B Weave: một decorator Python để trace, rồi biến lỗi của khách thành bài eval
Khi khách hỏi vì sao agent trả lời sai hôm qua, công cụ này giúp bạn có bản ghi để mở ra và bài kiểm tra để chứng minh lỗi đã hết.

Tóm tắt nhanh
- Weave ghi input, output và code của hàm được gắn @weave.op; các lời gọi LLM được hỗ trợ thì tự được trace.
- Dataset tạo được từ chính các call đã trace, còn mỗi lần gọi .evaluate() là một run của Evaluation.
- Giá trị thật nằm ở bộ ca lỗi bạn thu thập tại khách hàng, không nằm ở chính decorator.
Thử hình dung tuần thứ hai sau khi agent phân loại ticket của bạn chạy tại khách hàng. Trưởng nhóm vận hành gửi một ảnh chụp màn hình: ticket về hóa đơn bị chuyển nhầm sang bộ phận kỹ thuật, kèm câu hỏi vì sao. Không có trace, bạn chỉ biết đoán.
Với W&B Weave, phần ghi lại chỉ tốn rất ít code: sau một lệnh khởi tạo, một decorator trên hàm Python sẽ lưu input, output và cả code của hàm đó. Từ đây bạn dựng được vòng lặp mà FDE nào cũng cần: thấy lỗi, giữ lỗi lại, rồi chứng minh lỗi đã hết.
Tài liệu chính thức mô tả Weave là nền tảng observability và evaluation; trang PyPI gọi gọn hơn là bộ công cụ để trace và đánh giá AI agent. Nếu bạn đang đưa một ứng dụng LLM vào môi trường của khách, đây là loại công cụ nên có trước buổi họp đầu tiên về chất lượng, không phải sau đó.
Khi nào FDE cần đến Weave?
Hãy dùng phép thử này: nếu chiều nay khách hỏi về một lần gọi từ hôm qua mà bạn không mở lại được input và output của nó, đã đến lúc cần trace. Weave hợp khi ứng dụng chạy Python 3.10 trở lên, agent đã nhận yêu cầu thật, và bộ phận bảo mật của khách chấp nhận cho ghi lại nội dung đó.
Với ticket hóa đơn ở trên, câu chuyện đổi từ “chắc do prompt” sang một bản ghi cụ thể có input, output, latency và token usage để hai bên cùng đọc.
Ngược lại, bản demo một buổi trên dữ liệu giả chưa cần đến nó, vì chưa có lỗi thật nào để giữ lại. Phần evaluation đáng đầu tư từ lúc bạn có ca lỗi thật và chuẩn bị sửa prompt hoặc model, vì khi đó bạn cần biết lần sửa có làm hỏng gì khác không.
Một dòng khởi tạo, một decorator
Bắt đầu với phần trace. weave.init nhận đường dẫn team/project và tự tạo project nếu chưa có.
import weave
from openai import OpenAI

weave.init("acme/ticket-triage")
client = OpenAI()

@weave.op
def classify_ticket(text: str) -> str:
    response = client.chat.completions.create(
        model=MODEL_NAME,
        messages=[{"role": "user", "content": PROMPT + text}],
    )
    return response.choices[0].message.content
Hai tên viết hoa trong đoạn code là chỗ bạn tự điền và cần định nghĩa trước khi chạy. MODEL_NAME là tên model dự án đang dùng, còn PROMPT là chỉ dẫn phân loại, chẳng hạn yêu cầu model chỉ trả về một nhãn như billing hoặc access.
Lời gọi LLM bên trong không cần decorator riêng nếu nó thuộc diện được hỗ trợ, vì Weave tự trace những lời gọi đó. @weave.op dành cho code của bạn: bước tiền xử lý, bước truy xuất, hàm hậu kiểm. Việc đầu tiên tại khách hàng là gắn nó vào đúng những hàm mà bạn sẽ phải giải thích khi có sự cố.
Từ ảnh chụp màn hình thành bài kiểm tra
Trace cho biết chuyện gì đã xảy ra, nhưng không ngăn nó lặp lại. Tài liệu của Weave mô tả các ví dụ trong bộ đánh giá thường là những ca thất bại cần kiểm tra, tương tự unit test. Nếu chỉ mang một thói quen từ Weave sang dự án khác, hãy chọn thói quen này.
Dataset có thể sinh ra từ chính các call đã trace: chọn một hoặc nhiều call trên giao diện, hoặc dùng Dataset.from_calls trong Python. Call cho bạn input và output của lần chạy sai, nhưng đáp án đúng thì bạn vẫn phải thêm vào. Hãy nhờ trưởng nhóm vận hành duyệt nhãn, vì người hiểu nghiệp vụ thường đáng tin hơn một kỹ sư đoán nhãn.
Đoạn code dưới đây viết tay các dòng cho dễ thấy cấu trúc và chỉ phác thảo các bước chính; hãy đối chiếu function signature với tài liệu của đúng phiên bản bạn cài. Mỗi dòng có một id riêng để về sau so sánh được giữa các run.
import asyncio

rows = [
    {"id": "ca-01", "text": "Charged twice for September invoice", "expected": "billing"},
    {"id": "ca-02", "text": "Cannot log in after SSO change", "expected": "access"},
]
dataset = weave.Dataset(name="ticket-failures", rows=rows)
weave.publish(dataset)

@weave.op
def exact_match(expected: str, output: str) -> dict:
    return {"correct": expected == output}

evaluation = weave.Evaluation(dataset=dataset, scorers=[exact_match])
asyncio.run(evaluation.evaluate(classify_ticket))
Scorer phải có tham số output và trả về một dictionary điểm số. Còn Evaluation, tài liệu ví nó như bản thiết kế, và mỗi lần gọi .evaluate() là một run. Bạn giữ nguyên bản thiết kế, đổi prompt hoặc model, rồi đo lại.
Con số tổng có thể đánh lừa bạn
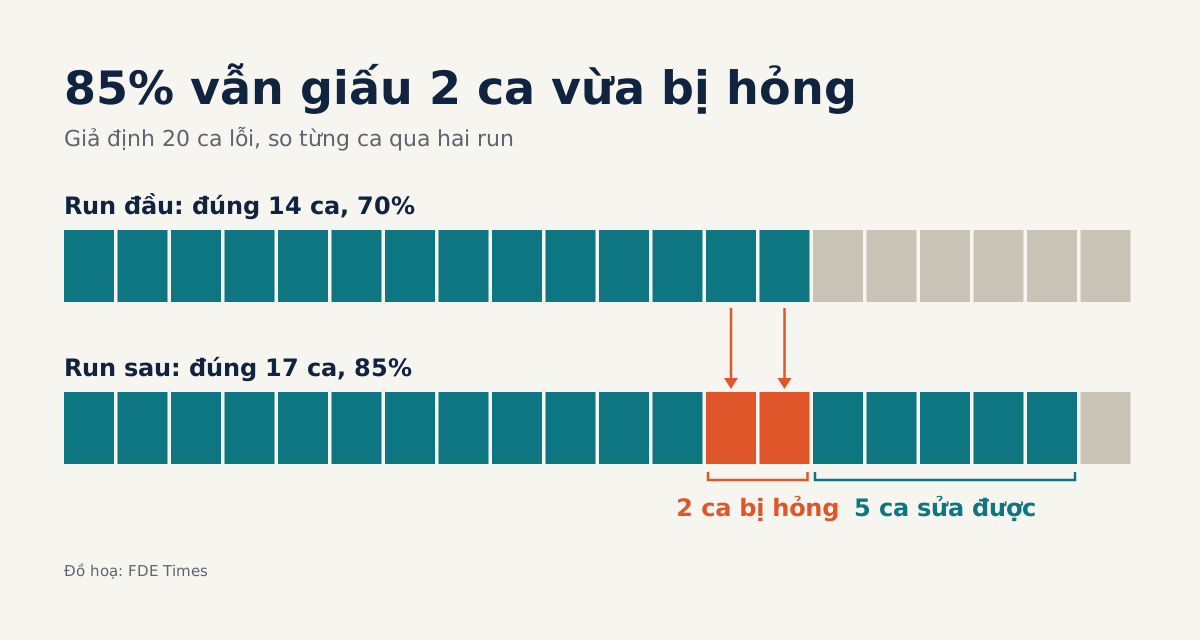
Giả sử bộ đánh giá có 20 ca lỗi thật, và run đầu tiên đúng 14 ca, tức 70%. Bạn sửa prompt và run sau đúng 17 ca, tức 85%. Báo cáo với khách rằng chất lượng tăng 15 điểm phần trăm nghe rất ổn.
Nhưng hãy đọc điểm theo từng ca. Có thể bạn sửa được 5 ca và làm hỏng 2 ca vốn đang đúng: 14 cộng 5 trừ 2 vẫn ra 17. Nếu 2 ca ấy là loại ticket khách coi trọng nhất, con số 85% chưa đủ để lên production.
Vì thế, mỗi run cần một file JSON riêng, mỗi ca một khóa: id của ca, kèm giá trị correct mà scorer trả về. Dữ liệu lấy từ Python SDK bằng client.get_calls; giao diện cũng cho xuất các dòng đã chọn hoặc tất cả.
Có hai điều cần tra trong trang Query and export calls, đối chiếu với đúng phiên bản đã cài: cách lọc ra các call thuộc một run, và tên trường chứa id cùng điểm số. Nếu chưa tìm ra, đường lùi là tự chạy classify_ticket và exact_match qua từng dòng rồi ghi file:
import json

results = {}
for row in rows:
    output = classify_ticket(row["text"])
    results[row["id"]] = exact_match(row["expected"], output)["correct"]

with open("run_1.json", "w") as f:  # run_2.json for the second run
    json.dump(results, f)
Dù lấy dữ liệu bằng cách nào, hai file phải có cùng định dạng thì đoạn diff dưới đây mới chạy được.
import json

# run_1.json, run_2.json: {"ca-01": true, "ca-02": true, "ca-03": false}
run_1 = json.load(open("run_1.json"))
run_2 = json.load(open("run_2.json"))
assert run_1.keys() == run_2.keys()  # both runs must cover the same cases

fixed = [c for c in run_1 if not run_1[c] and run_2[c]]
regressions = [c for c in run_1 if run_1[c] and not run_2[c]]
Danh sách regressions chính là thứ cần mang vào cuộc họp với khách, trước khi báo con số tổng.
Decorator không làm thay phần khó
Giới hạn đầu tiên nằm ngay trong cách hoạt động: @weave.op chỉ ghi những hàm bạn gắn, và tính năng tự trace chỉ áp dụng cho các lời gọi LLM được hỗ trợ. Nếu khách dùng một gateway LLM nội bộ, hãy thử sớm xem nó có xuất hiện trong trace không, đừng mặc định là có.
Giới hạn thứ hai mới là chuyện lớn. Trace ghi lại input và output, nghĩa là nội dung ticket của khách, có thể kèm dữ liệu cá nhân, sẽ nằm trong đó. Trước khi bật trên dữ liệu thật, hãy cùng bộ phận bảo mật của khách làm rõ dữ liệu được lưu ở đâu và ai xem được.
Về nhà cung cấp và phiên bản, có hai chi tiết cần nắm. CoreWeave công bố hoàn tất việc mua Weights & Biases ngày 5/5/2025 và tài liệu Weave giờ nằm ở docs.coreweave.com, nên hãy ghi rõ quan hệ này trong hồ sơ gửi khách.
Gói weave trên PyPI yêu cầu Python 3.10 trở lên; hãy ghim đúng bản đã kiểm tra, chẳng hạn weave==0.54.0.
Cuối cùng, Weave chỉ đo đúng thứ scorer của bạn đo. So khớp chính xác hợp với bài toán phân loại, còn với văn bản tự do, dù dùng LLM judge hay scorer tự viết, bạn vẫn phải định nghĩa thế nào là tốt. Đó là việc phải thống nhất với khách.
Nên học gì trước, và ghi gì vào CV?
Học theo đúng thứ tự của vòng lặp: trace trước, rồi Dataset, rồi Evaluation với một scorer đơn giản. Đừng vội viết scorer phức tạp khi chưa có 20 ca lỗi thật trong tay; bộ dữ liệu tốt giúp ích nhiều hơn một phép chấm tinh vi trên dữ liệu tự nghĩ ra.
Khi đọc tin tuyển dụng FDE hoặc applied AI, hãy để ý các từ khóa evals và observability, rồi chuẩn bị một câu chuyện có số. Dòng CV mạnh sẽ kể bạn dựng bộ đánh giá từ bao nhiêu ca lỗi thật, điểm trước và sau là bao nhiêu, và đã chặn được hồi quy nào trước khi lên production. Tên công cụ chỉ là chi tiết phụ.
Bài tập: tự lập danh sách hồi quy
Lấy 20 ca lỗi trong dataset của bạn, chạy một run và lưu điểm từng ca ra run_1.json. Đổi một chi tiết trong prompt, chạy run thứ hai, lưu ra run_2.json, rồi diff hai file bằng đoạn Python ở trên.
Đếm số ca chuyển từ sai sang đúng và số ca chuyển từ đúng sang sai. Để tự kiểm tra, lấy điểm run đầu cộng số ca sửa được rồi trừ số ca bị hỏng: kết quả phải bằng điểm run sau, giống phép tính 14 cộng 5 trừ 2 ra 17 ở trên.
Sau đó viết hai câu báo cáo cho khách. Câu đầu nêu điểm trước và sau; câu sau gọi tên các ca vừa bị hỏng và việc bạn sẽ làm với chúng.
Lần tới khi khách gửi ảnh chụp một câu trả lời sai, đừng chỉ sửa prompt. Hãy thêm một dòng vào dataset, để lần đo sau cho bạn biết lỗi ấy có quay lại hay không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!